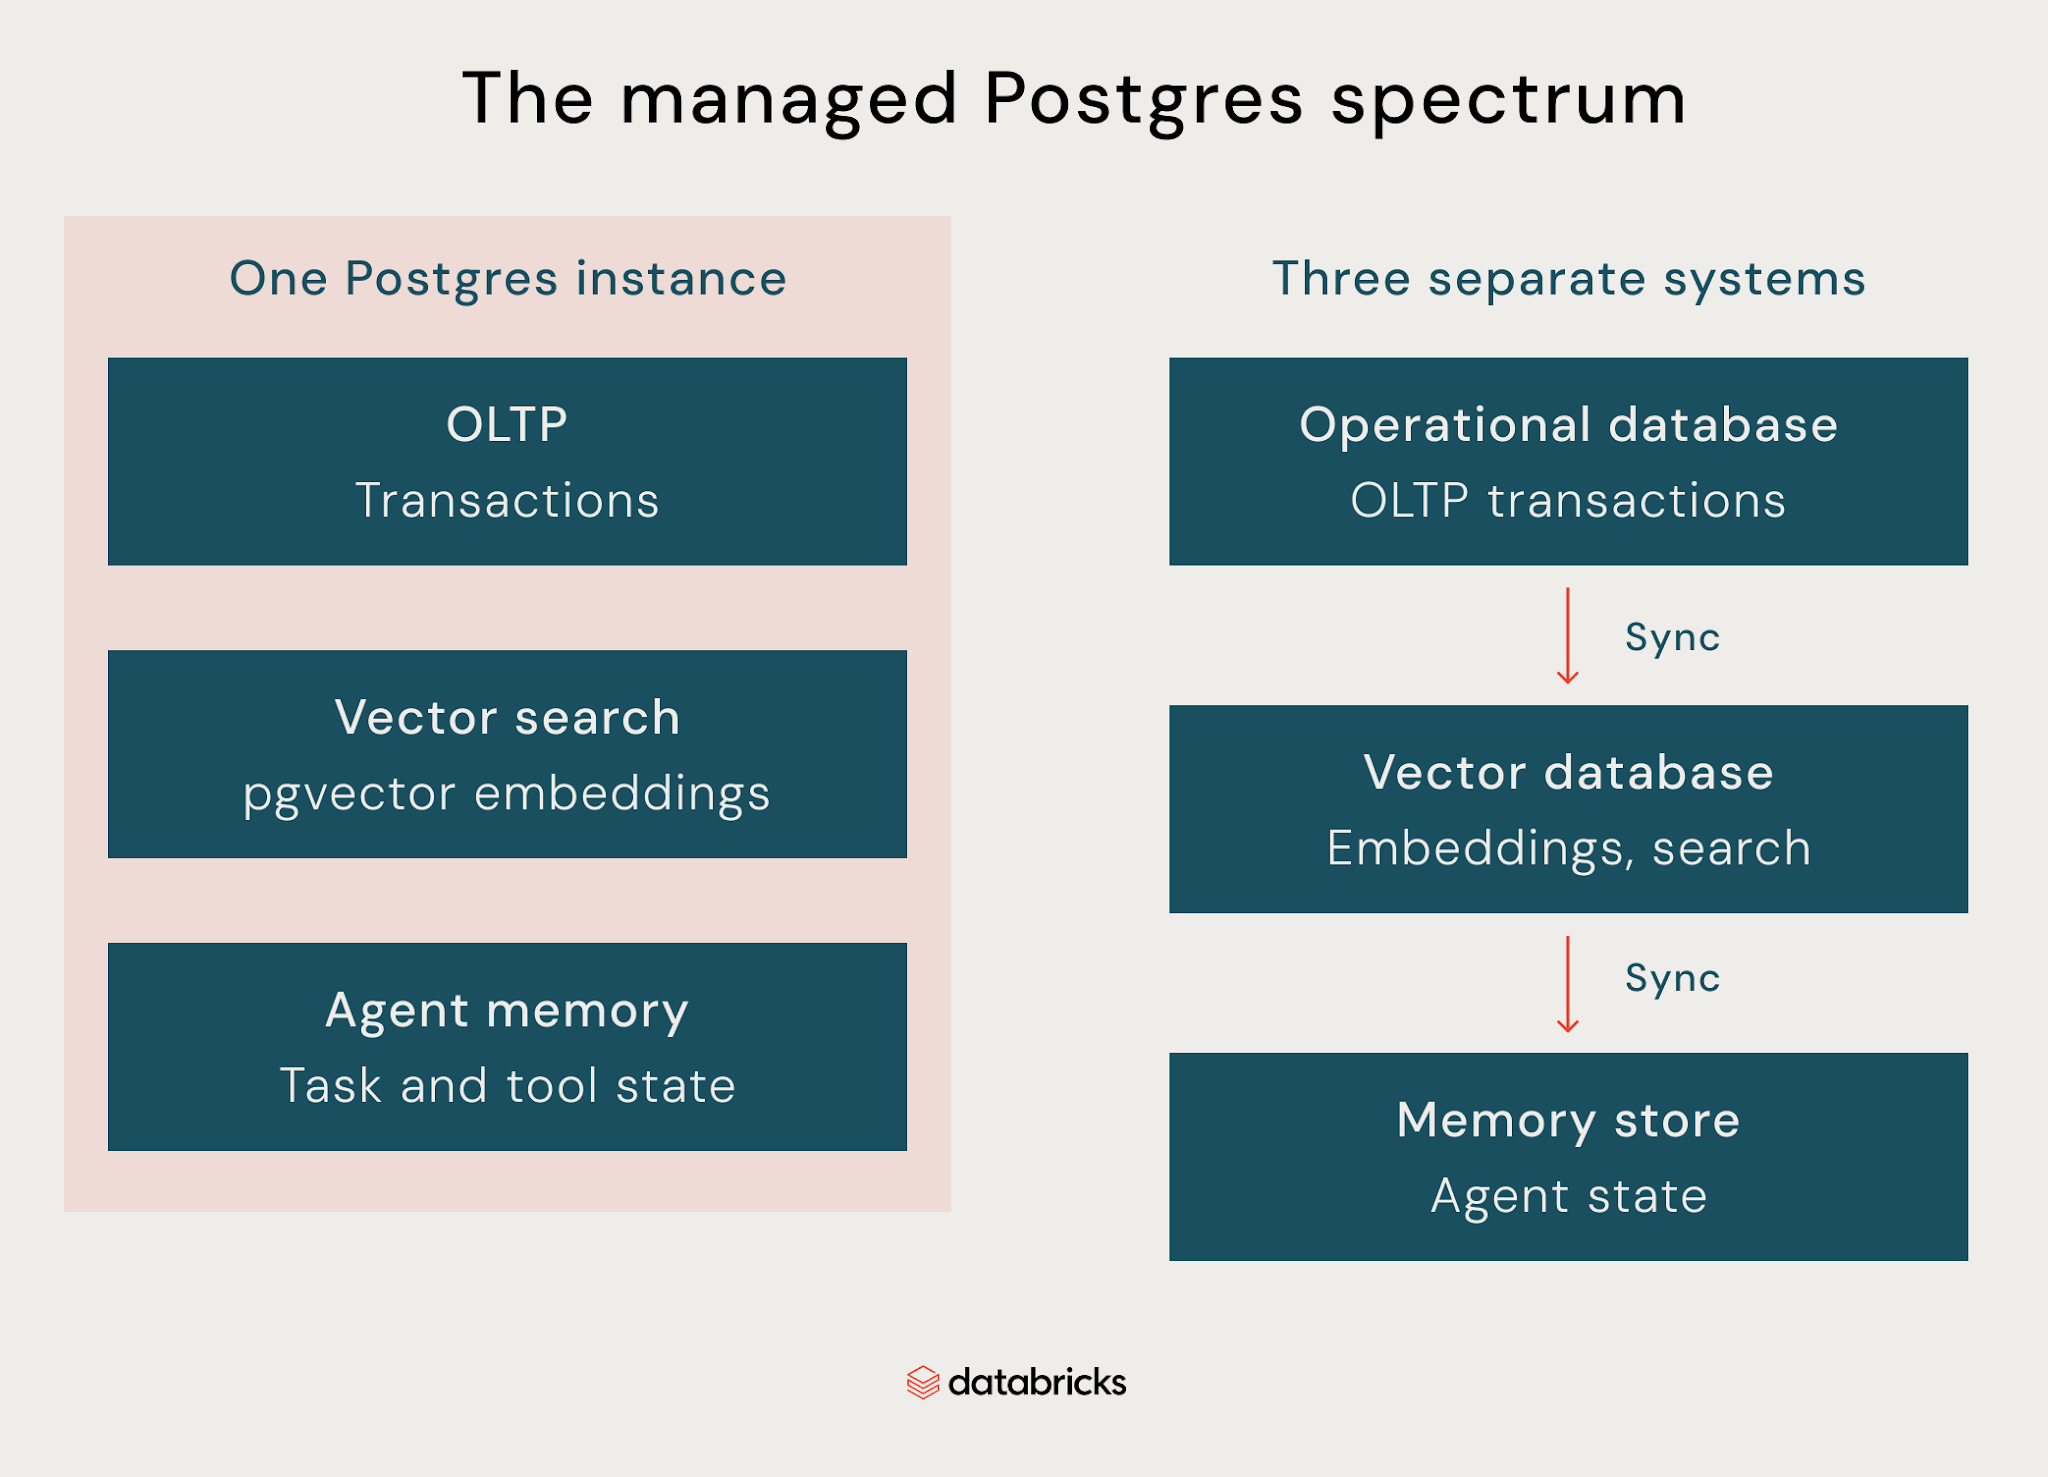
Databricks提出统一能源交易平台方案:通过Spark结构化流将市场数据毫秒级实时写入Lakebase运营数据库,支撑实时交易应用展示价格、持仓、盈亏与风险,并在接近限额时即时预警;同一份受Unity Catalog治理的数据同时用于机器学习训练与部署、历史分析与自然语言查询,避免运营与分析双系统导致的数据不同步、治理重复和模型交接复杂等问题。
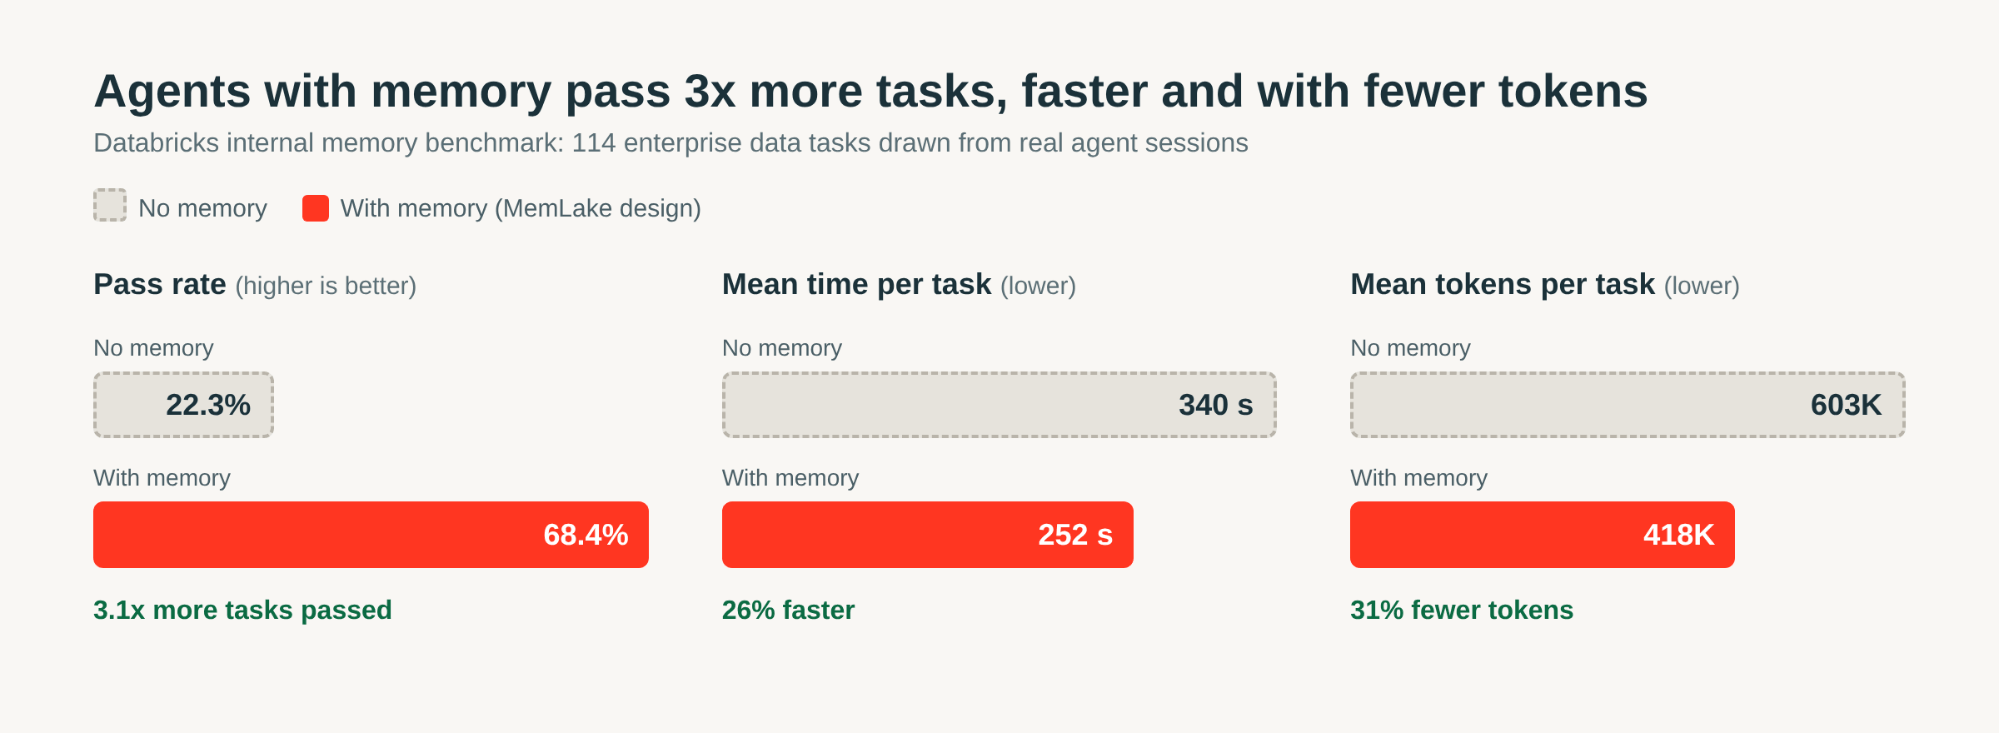
Databricks在Agent Bricks平台推出智能体记忆功能(Beta版),基于MemCurrent架构并运行于Lakebase。该功能通过自动记录上下文、按需调用工具及后台整合记忆三种方式,存储关键事实、偏好和工作流,以减少重复错误。内部测试显示,任务通过率提升约三倍,令牌用量减少31%。该功能已用于Genie,开发者可通过CLI快速部署。
Stripe数据管道新增实时同步至Postgres功能,支持目标为Databricks Lakebase。Stripe可将支付、客户、订阅等数据在数秒内同步至Lakebase,供应用实时查询,无需自建API或webhook集成。应用可即时更新订阅权限、展示账单、构建销售仪表盘并推送个性化优惠。该功能已公开预览,可免费使用。
Databricks 内部应用 Slide Hub 基于 Lakebase Postgres 实现混合搜索,结合向量检索与 BM25 关键词检索,无需独立搜索系统。基准测试显示:8 CU 以下时数据库为瓶颈,8 CU 以上时应用为瓶颈;缓存与索引比例决定命中率,接近 1.0 时延迟稳定。建议索引用 quality 模式、候选数设为 200,生产环境最小 0.5 CU 以避免冷启动。
AI编程代理并行开发时,共享数据库易冲突并危及生产数据。Lakebase Postgres通过数据库分支解决:秒级创建隔离分支,采用写时复制,空闲可缩零。每个代理和PR使用独立分支,测试后删除,架构变更经迁移工具提升至主分支。该模式支持安全调试与迁移验证,构成代理开发循环。
Lakebase 的 LTAP 架构将大批量数据加载从主库卸载到 Spark 分布式引擎,避免与在线事务争抢资源。Spark 通过沙箱 Postgres 生成合法堆页和索引,主库仅发布结果。1TB 数据加载不到 5 分钟,客户每日 10 亿行同步从 8 小时大幅加速,且不影响线上性能。
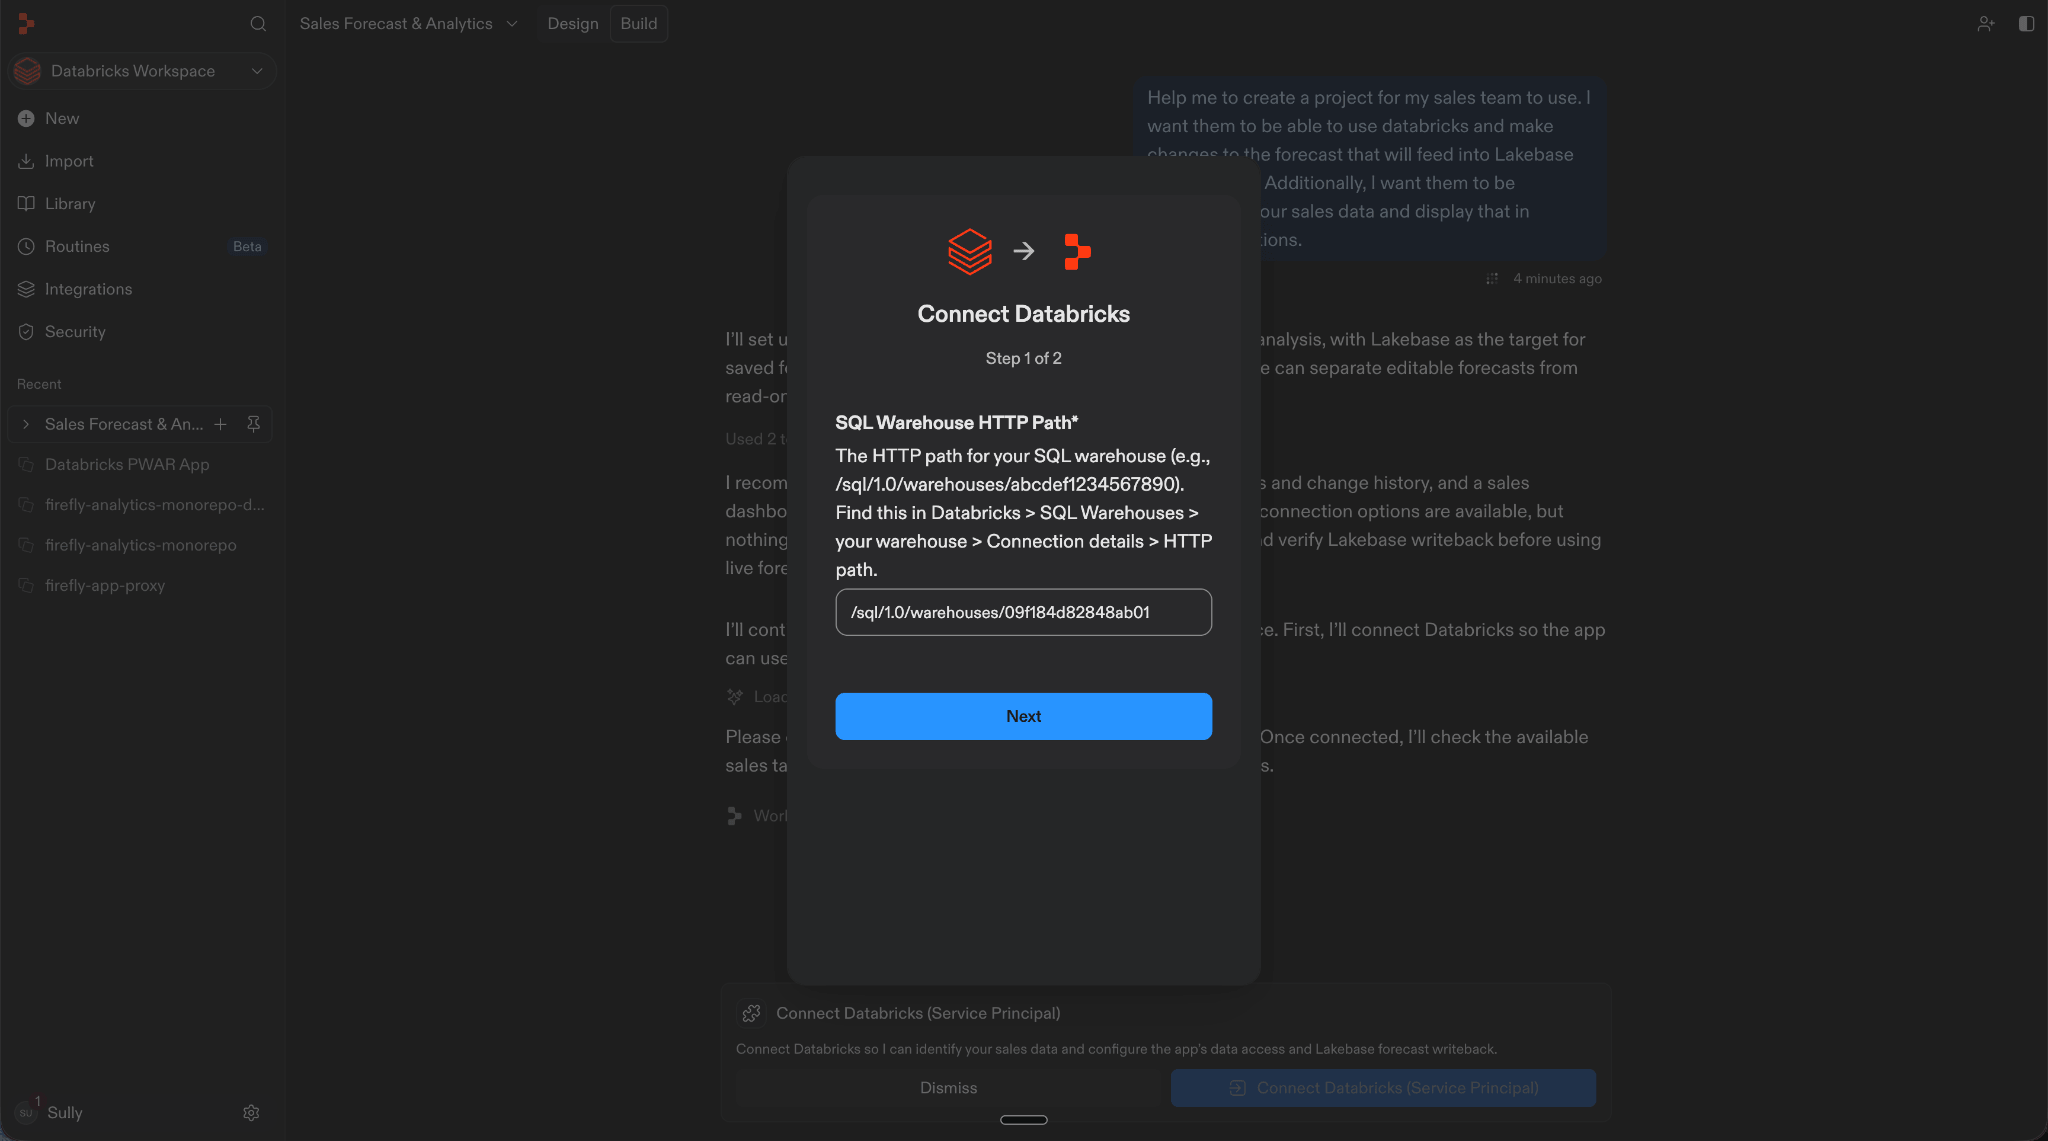
Replit与Databricks集成正式发布,支持Lakebase。企业用户可通过Replit Agent以自然语言构建受治理的应用并部署至Databricks Apps,应用自动继承Unity Catalog权限与身份验证,并自动配置Lakebase Postgres存储运营数据,无需外部数据库。适用于绩效管理、文档处理、工作流自动化等场景。入门需Replit企业版,约15分钟完成四步配置。
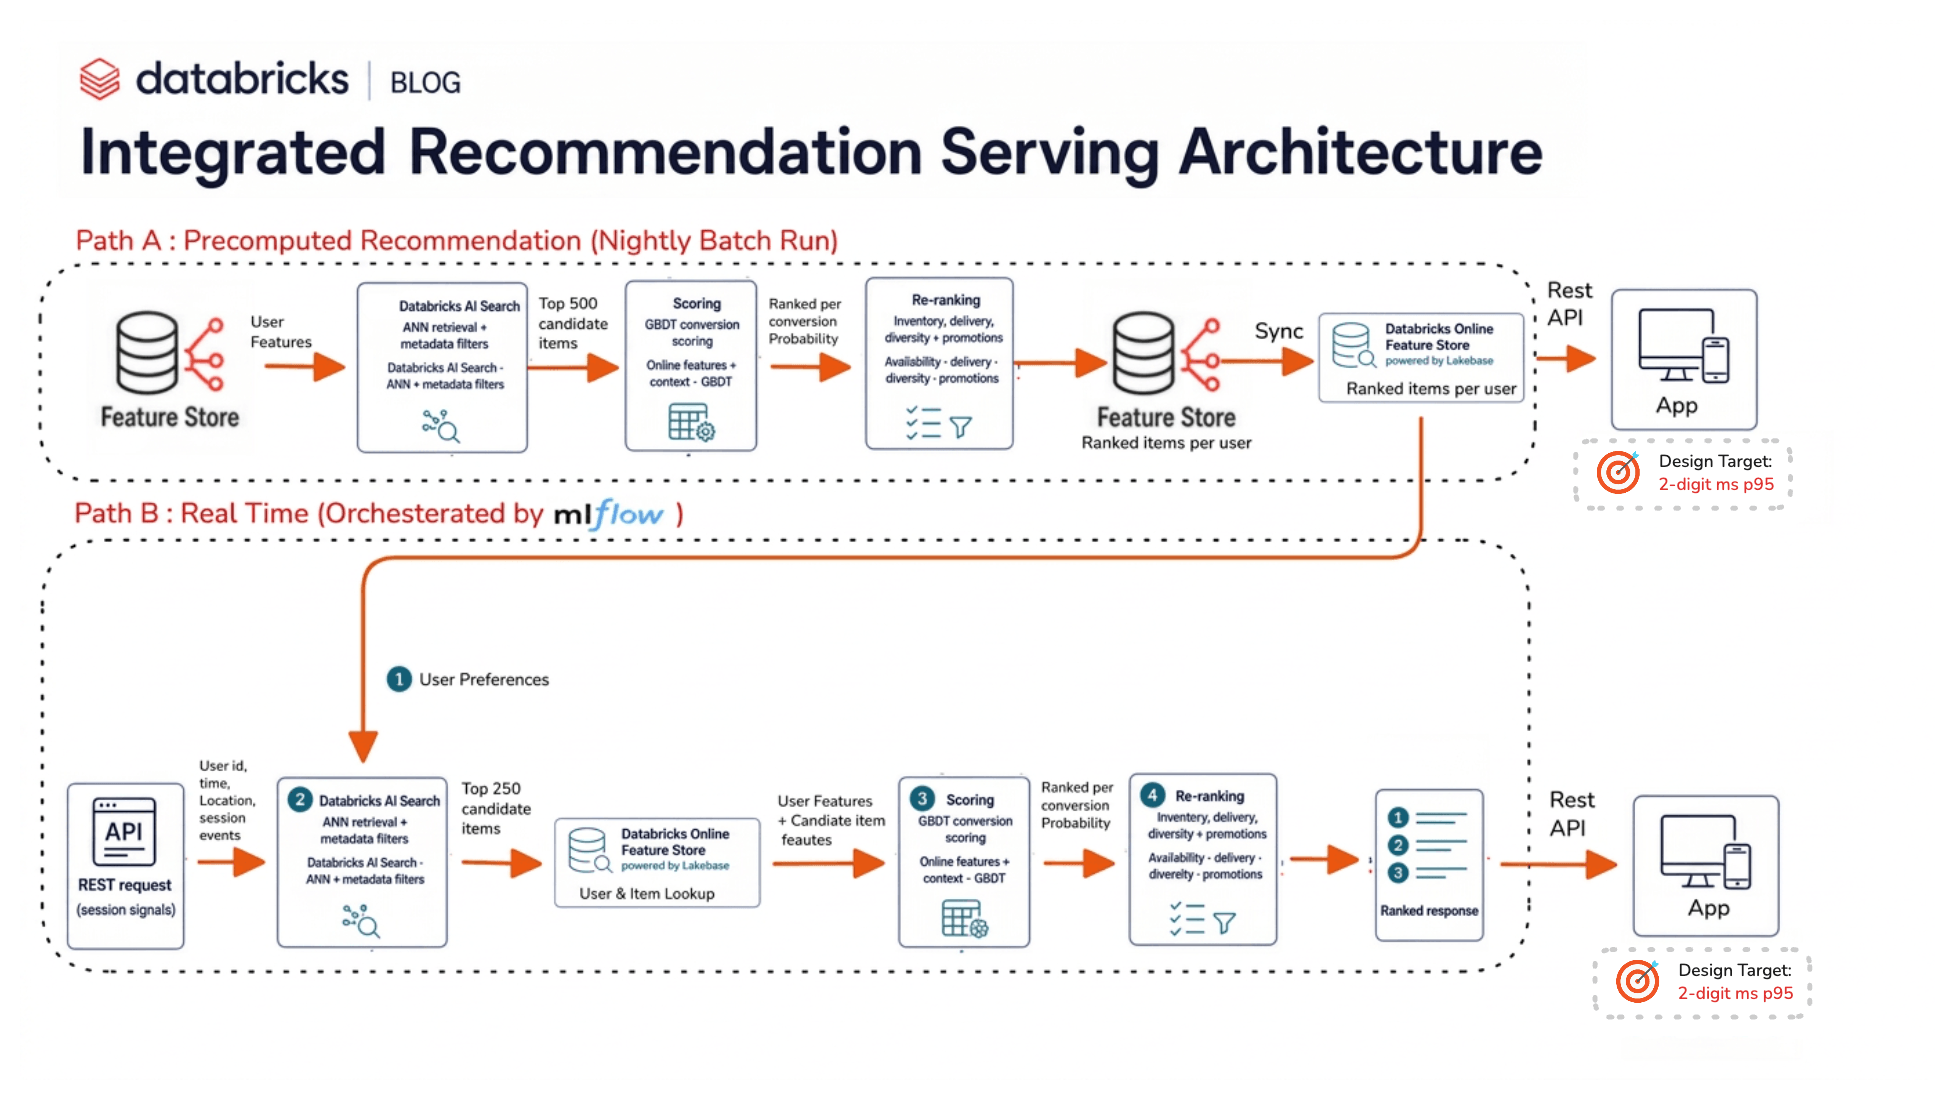
某亚洲时尚电商平台基于Databricks构建实时个性化推荐系统,服务百万月活用户和十万级SKU,每秒处理约千条事件。系统采用湖仓分层架构与特征存储,确保训练与推理一致。推荐分批量预计算(首页等)和实时会话评分(相似商品等)两条路径,均实现毫秒级响应,并支持冷启动、模型迭代与漂移监控。
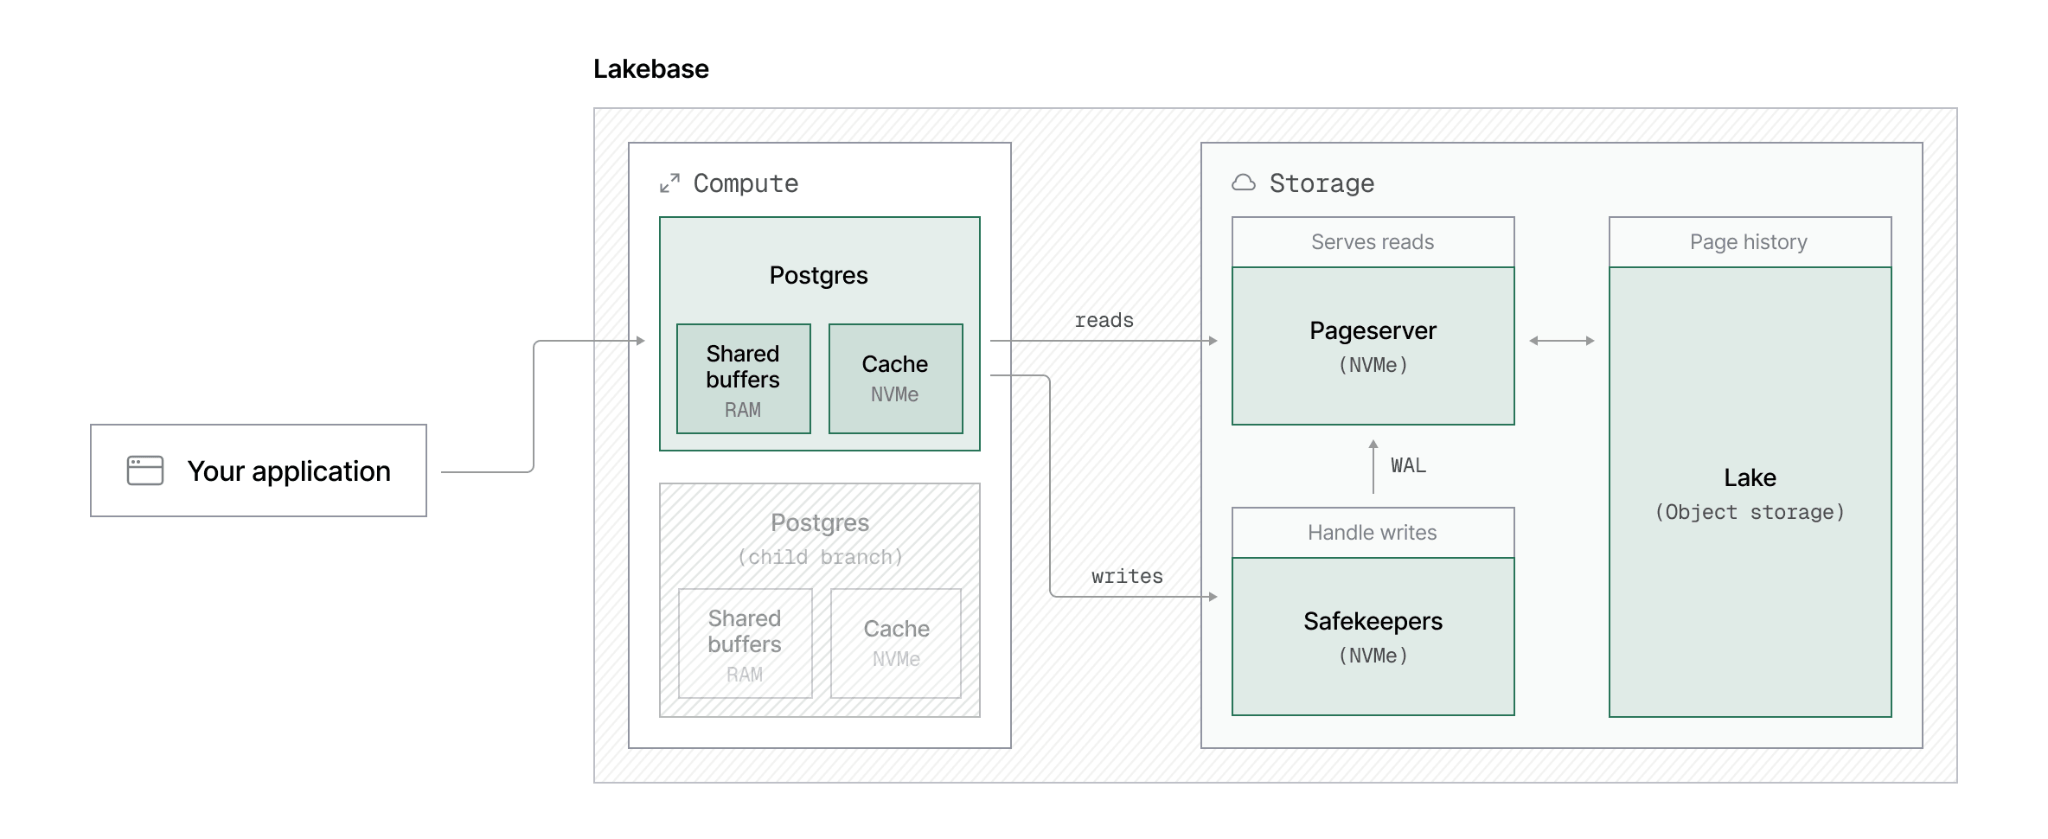
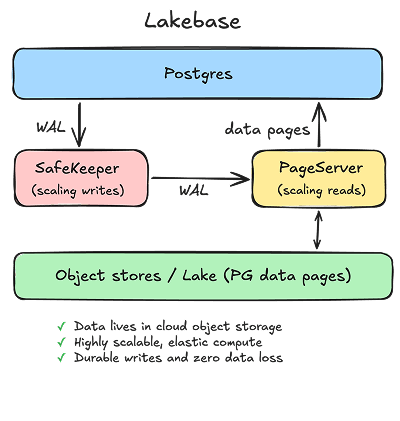
Lakebase Postgres 采用计算与存储分离架构,数据历史存于对象存储,恢复时按时间戳创建分支,无需复制数据或重放 WAL。分支恢复仅需数秒,即使 100TB 数据库也一样,而传统托管 Postgres 恢复需数小时。该机制支持代理自动执行,可用于实时版本控制和撤销。
Lakebase 是基于存算分离架构的托管 Postgres,成本优势显著。数据库分支共享存储,适合短期开发测试;自动扩缩容可按需调整算力,配合缩容至零可进一步降本。读写分离与高可用无需复制存储。同步表应只同步活跃子集,并按需选择快照、触发或连续模式。合理配置计算规格、连接池和恢复窗口,可避免资源浪费。
Databricks 在 Lakebase Postgres 上推出 lakebase_vector 和 lakebase_text 扩展,提供可扩展的向量搜索与 BM25 全文检索,已在 AWS 和 Azure 正式可用。该方案突破 pgvector 内存瓶颈,支持存算分离、并行索引与混合搜索,可无服务器扩展至十亿级向量,兼顾高召回与低延迟。
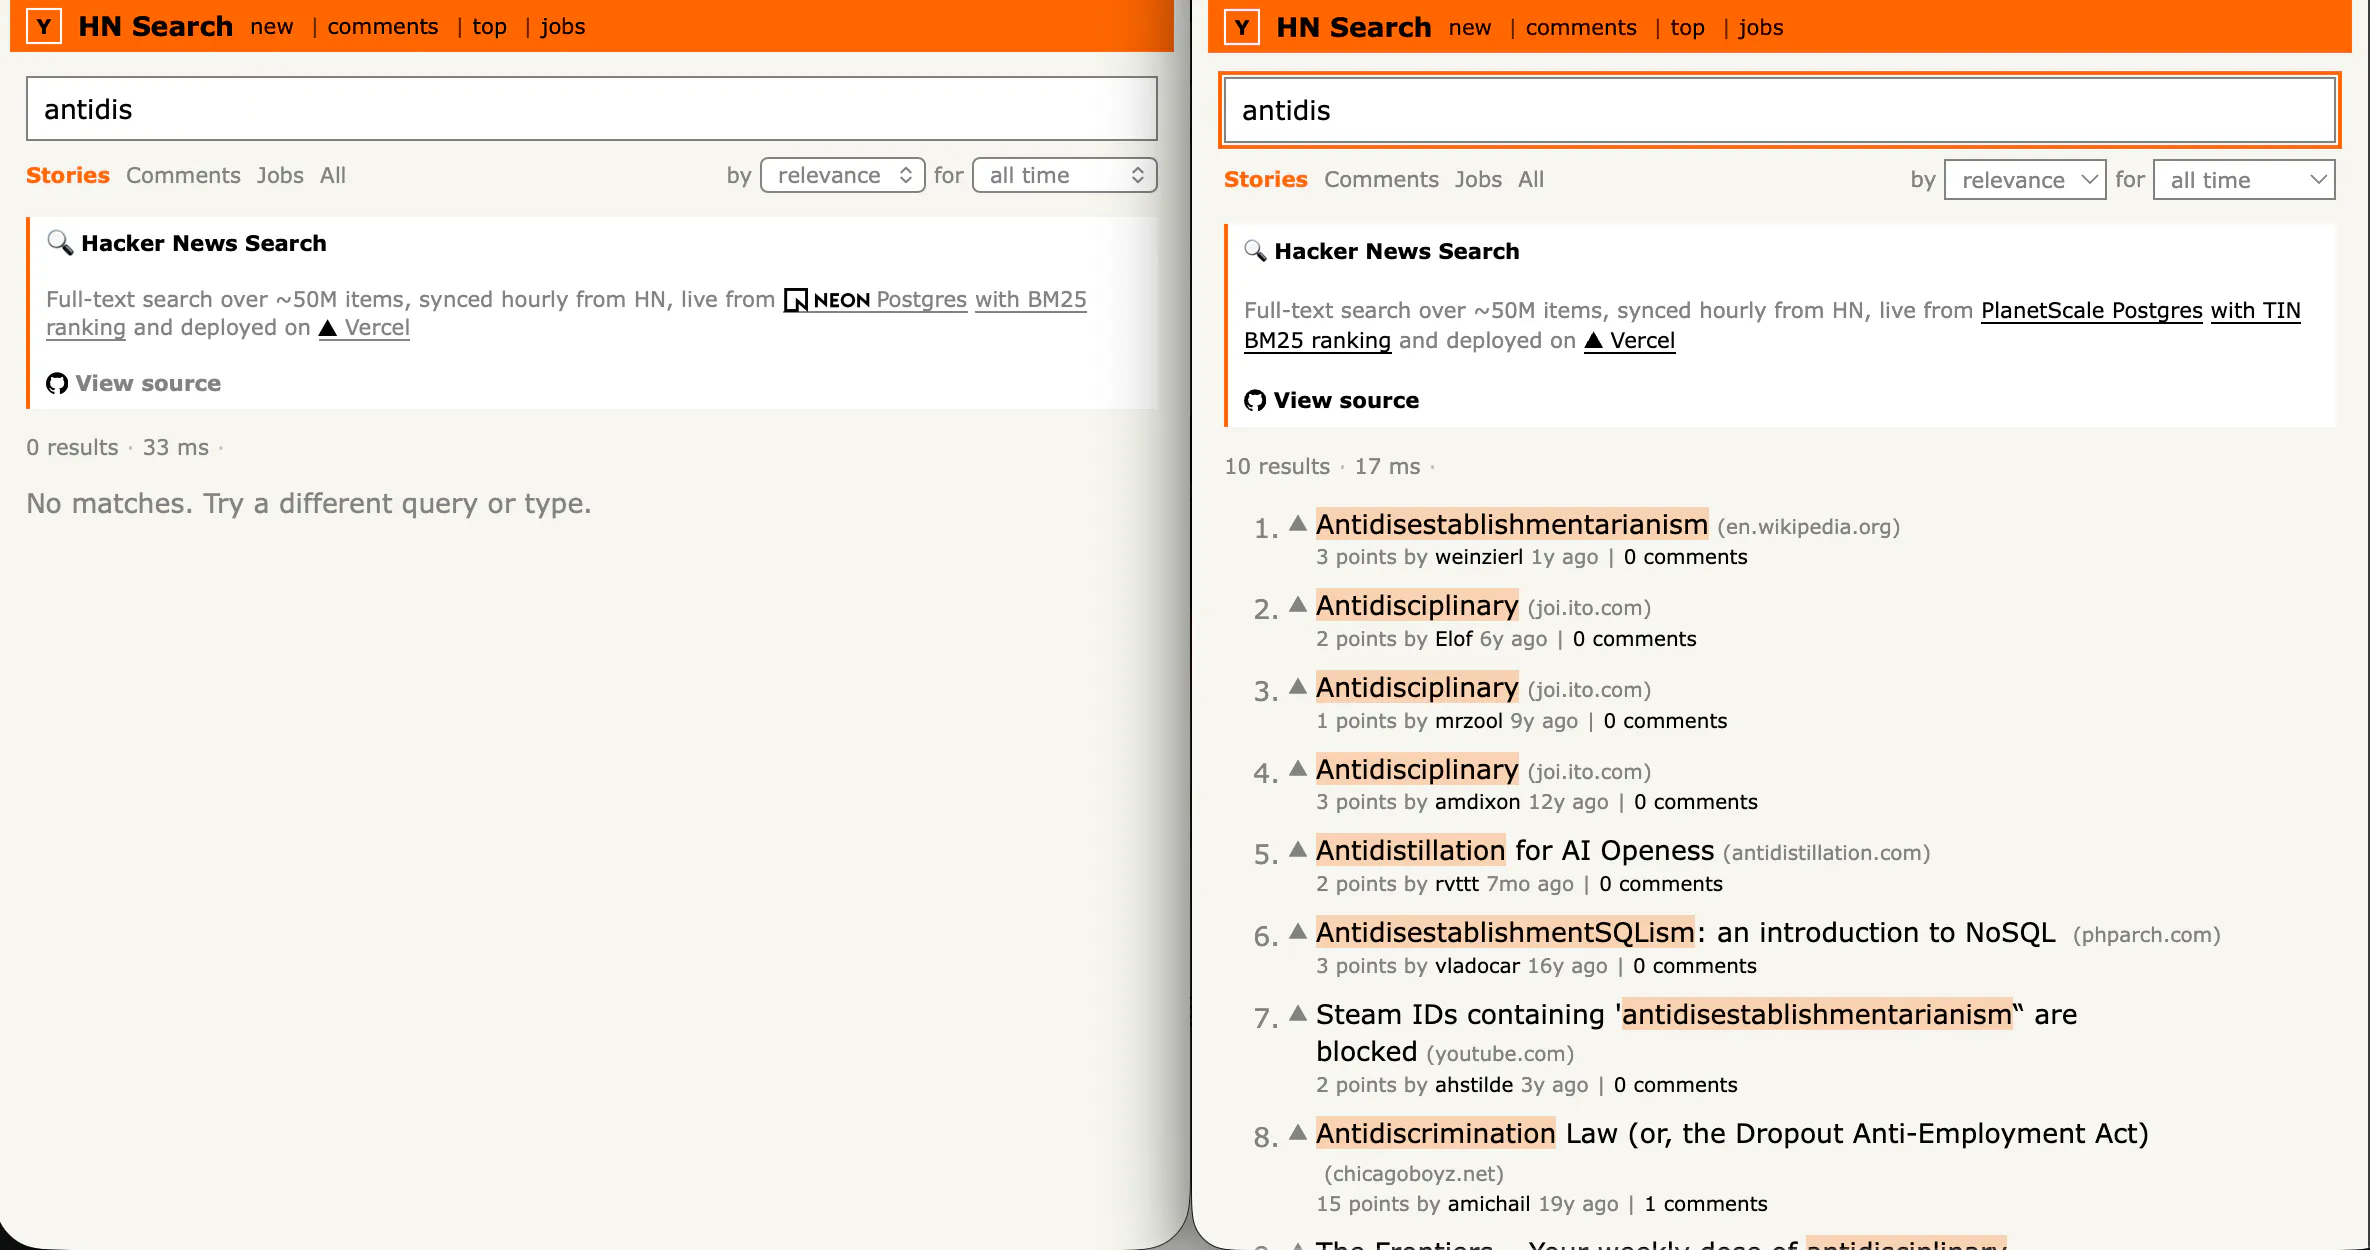
作者对比了TIN与Lakebase的Postgres全文搜索:TIN无需防抖,支持通配符自动补全和模糊匹配,不忽略停用词,毫秒级返回精确计数;Lakebase需3.6秒且仅估算3400条结果,实际为213447条。成本上,Lakebase月费约5186美元,TIN仅609美元,更快更强且便宜八倍以上。
Databricks Lakebase 是全托管无服务器 Postgres,自动处理补丁、扩缩容、故障转移和备份,写入速度比标准 Postgres 快 5 倍,内置时间点恢复、安全、连接池和数据库分支,支持 pgvector 向量检索与 LLM 状态存储,适合 AI 应用。跨区域灾难恢复仍处私有预览,需手动故障转移。
Databricks 为 Lakebase Postgres 优化计算节点缓存:在固定规格计算上停用本地文件缓存,将共享缓冲区设为内存的75%,并启用2MB大页以减少页表和TLB开销。实测吞吐翻倍、延迟下降、CPU占用降低,存储读取请求大减。下一步将把大共享缓冲区扩展至自动伸缩计算。
本文介绍Databricks开源框架Consort,它利用Lakebase数据库分支实现测试驱动开发。传统数据库无法分支,导致测试用mock或共享环境。Consort通过代理团队(如产品负责人、DBA)在真实数据库分支上运行红绿重构循环,支持并行实验和代码模式审查,使集成测试左移,减少生产故障,实现代码与模式同步部署。
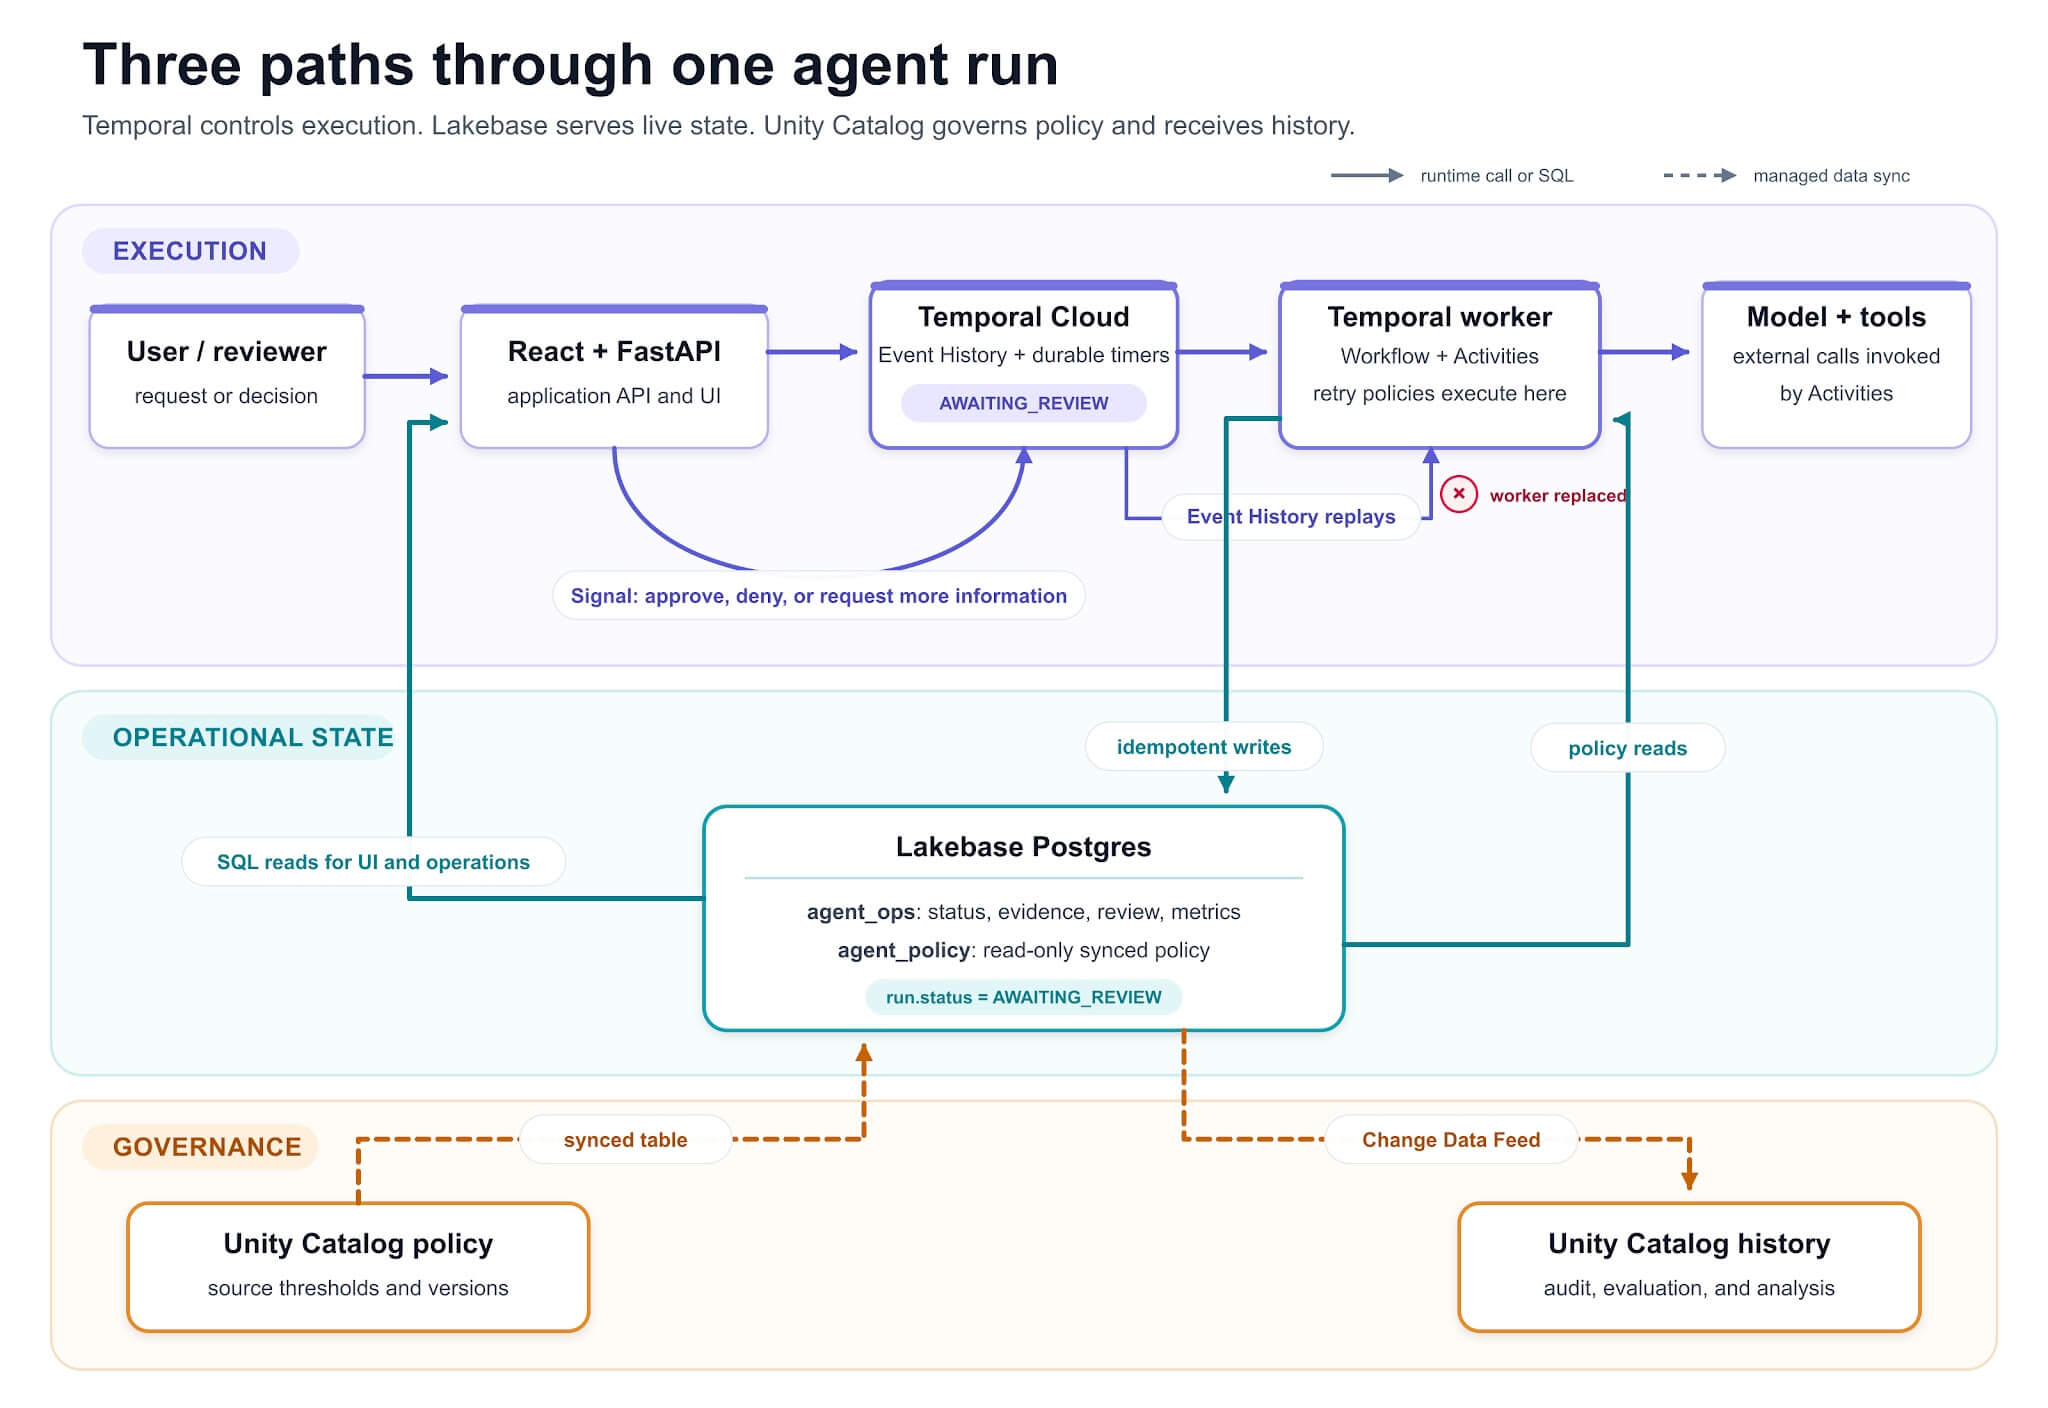
该文章介绍了一个基于Temporal和Lakebase的个人贷款核保代理参考实现。它利用Temporal实现持久执行,确保代理在工人故障后恢复;Lakebase存储可查询的操作状态,如运行状态、证据和指标。通过确定性ID和幂等写入处理重试,Unity Catalog同步政策,Change Data Feed导出历史数据。此架构增强了代理的韧性和可扩展性,适用于需要长期等待和状态恢复的代理场景。
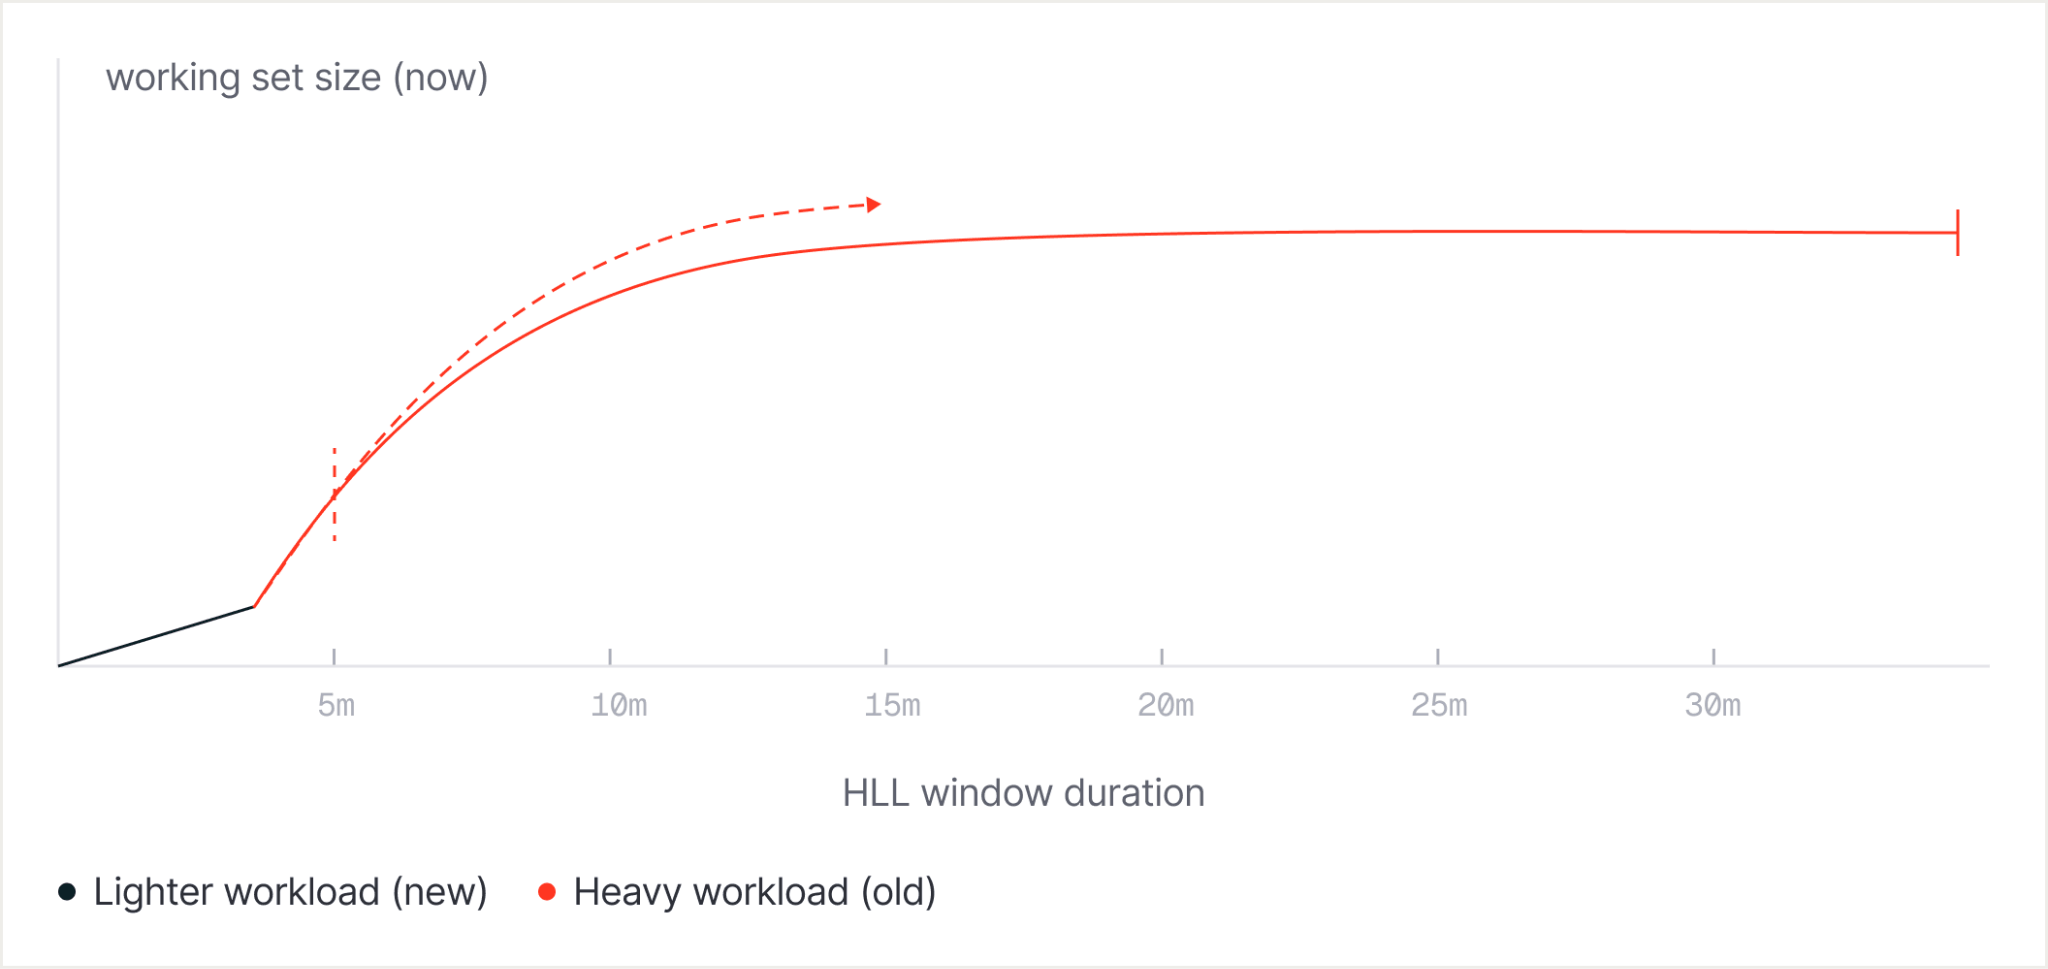
Lakebase Postgres通过自动扩展实现数据库计算资源的动态调整,其算法监控CPU使用率、内存压力及基于时间感知的HyperLogLog估算的工作集大小来确定扩展目标。系统利用VM实时调整CPU和内存,无需中断连接,支持双向扩展,并分离存储与计算,使扩展灵活高效,避免资源浪费,适应实时工作负载变化。
Databricks将在VLDB 2026展示多项创新,包括Reynold Xin的主题演讲,介绍AI代理时代数据库工程的“第三黄金时代”,提出Lakebase和LTAP新范式。四篇论文涵盖Lakebase架构、Spark Structured Streaming演进、AutoLiquid自动数据布局优化及Ultron历史查询优化,另有Enzyme演示,旨在提升湖仓性能与实时分析能力。
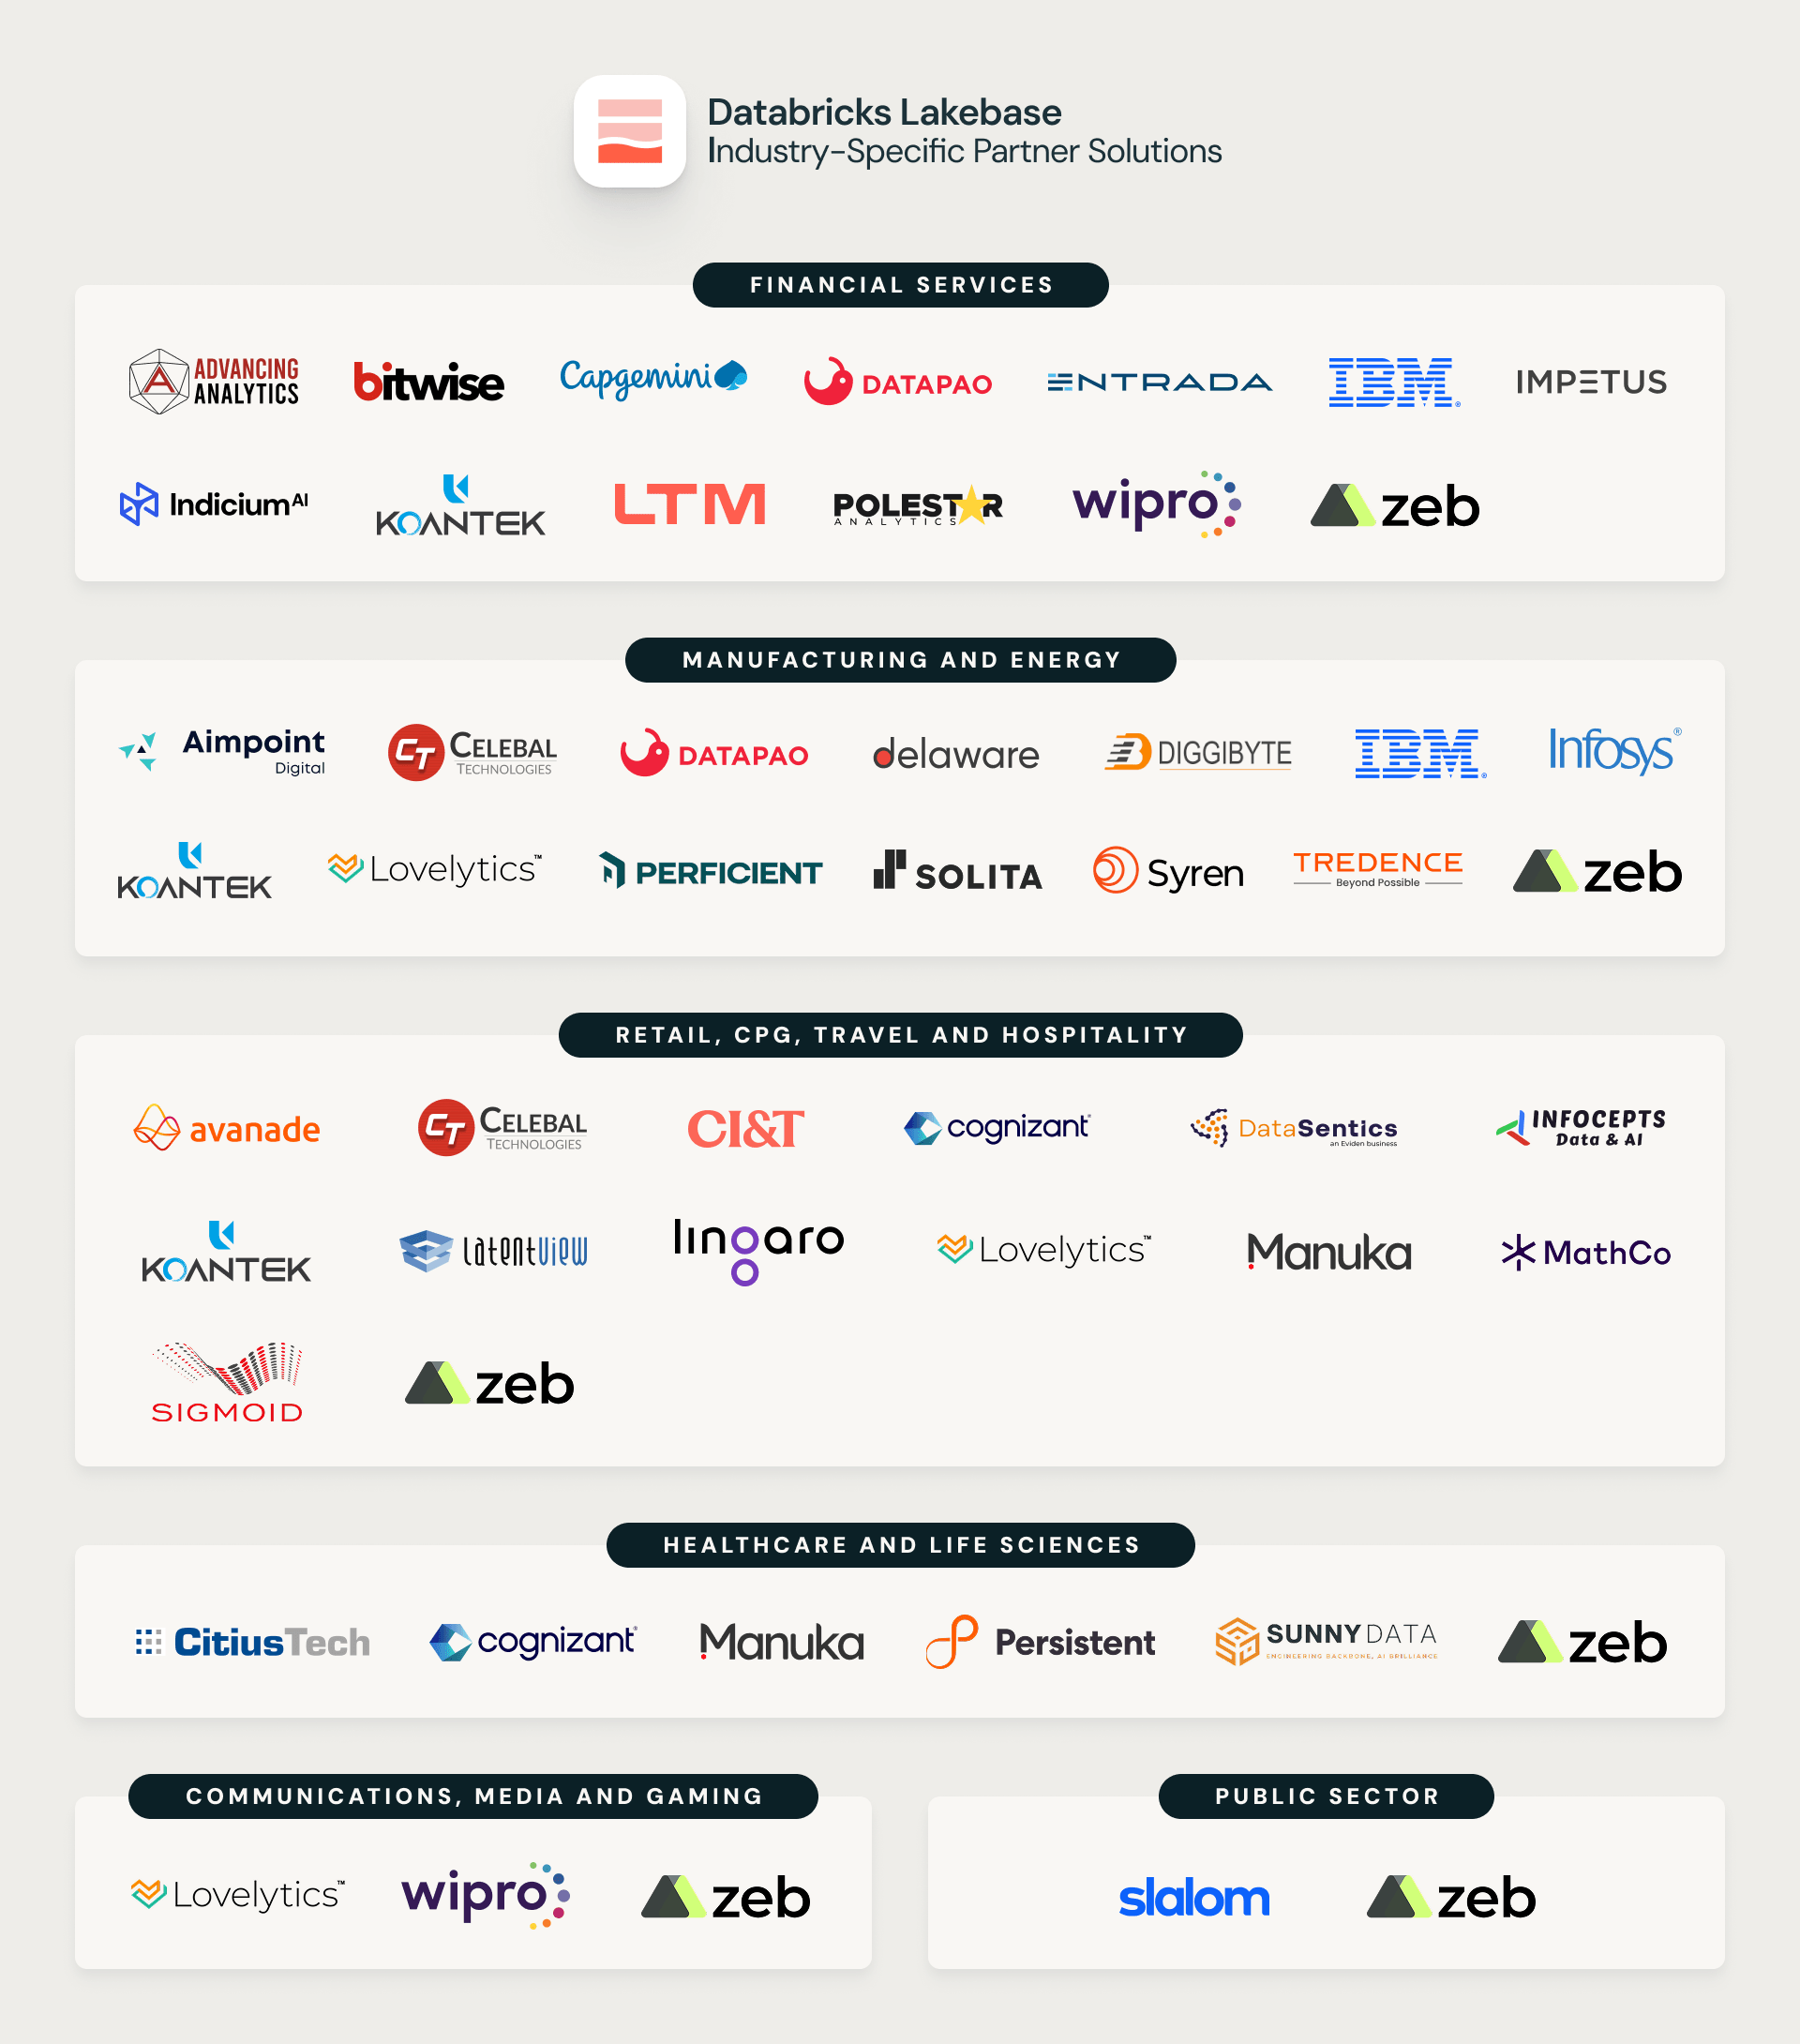
Databricks Lakebase Postgres将事务数据库与分析平台统一,其合作伙伴基于此构建了覆盖金融、制造、零售、医疗等行业的AI解决方案,如欺诈检测、理赔处理、供应链优化等。这些方案利用Lakebase的低延迟和统一治理能力,加速决策,提升运营效率,并已投入生产使用。
本文介绍Databricks Lakebase与Unity Catalog的FinOps解决方案,通过将Backstage运营数据与云账单数据直接连接,实现单查询成本归属分析。Lakebase隔离计算,支持秒级数据库分支,使临时分支成本可追踪。文章强调零ETL管道、统一治理及分支生命周期管理,展示技术融合如何简化成本与所有权查询,并指出未来需优化认证路径。
完成下面两步后,将自动完成登录并继续当前操作。