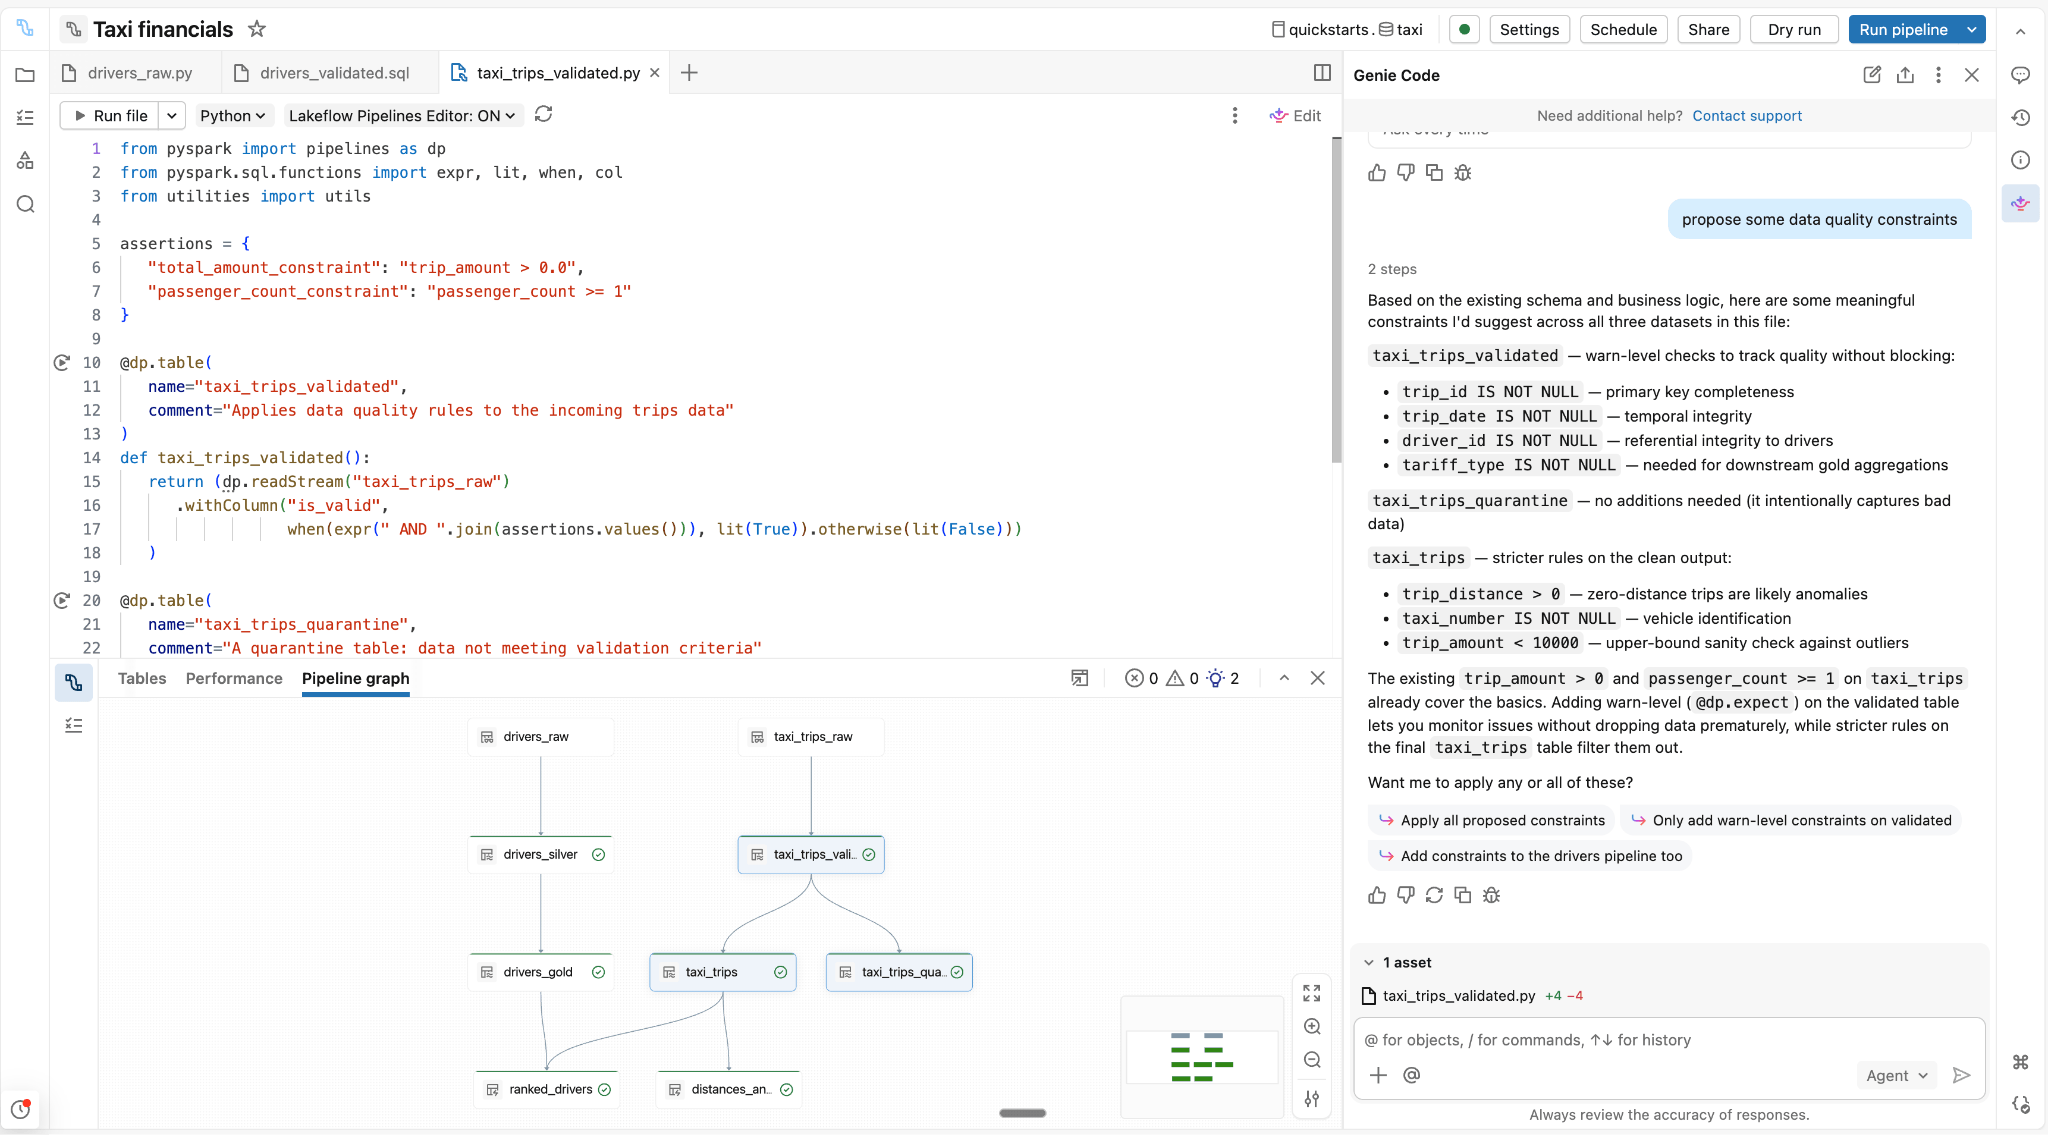
Databricks在SQL编辑器中引入声明式ETL,支持追加、CDC和批量覆盖三种模式,简化数据转换流程。用户可直接在SQL查询中定义流程,平台自动处理增量处理、调度和编排。CDC模式支持SCD类型1和2,REPLACE WHERE提升性能。用户可混合传统SQL与声明式操作,并借助Genie Code生成和优化流程。
Databricks推出Genie Code智能体转换器,可将T-SQL、Snowflake等专有方言自动转换为开放ANSI SQL,简化数据仓库迁移。用户通过迁移项目集中管理文件,系统评估复杂度并生成血缘关系,支持并行转换和自定义规则修复。该工具已帮助千余客户迁移至Lakehouse,未来将扩展ETL源和增加数据验证功能。
本文探讨了Flink与Iceberg在流式数据入湖中的配置与优化,分析了checkpoint间隔、提交频率与小文件数量的关系。通过调整checkpoint参数和并行度,优化提交过程,减少背压对数据可见性的影响。同时介绍了预聚合和bucket分区策略,以提高写入效率并降低小文件生成。最后提供了CDC入湖作业的检查清单,确保数据一致性与性能。
本文探讨了数据湖与开放表格式的关系,分析了Hive表的局限性及其在对象存储中的应用问题。Hive表依赖目录重命名,缺乏原子提交,导致部分提交和并发写入问题。开放表格式(如Iceberg、Delta、Hudi)通过将表拆分为不可变数据文件、可变元数据和原子切换的catalog指针,解决了这些问题,实现了在对象存储上支持ACID和时间旅行的能力。
选择数据迁移工具时,应根据工作负载的复杂性选择合适的工具,如Lakehouse、Spark Declarative Pipelines或PySpark。迁移过程应逐步进行,首先评估现有数据仓库,选择低风险、高可见性的工作负载进行快速迁移,随后现代化和优化管道,最终整合冗余ETL流程。
文章讨论了数据库设计方法的演变,重点介绍了Databricks Lakehouse的复制写入分支技术。这项技术使开发者能够轻松创建独立的数据库分支,提高了数据库变更的效率和协作。开发者Jen利用这一技术在生产环境中进行数据库重构,展示了开发者与DBA之间的顺畅协作。
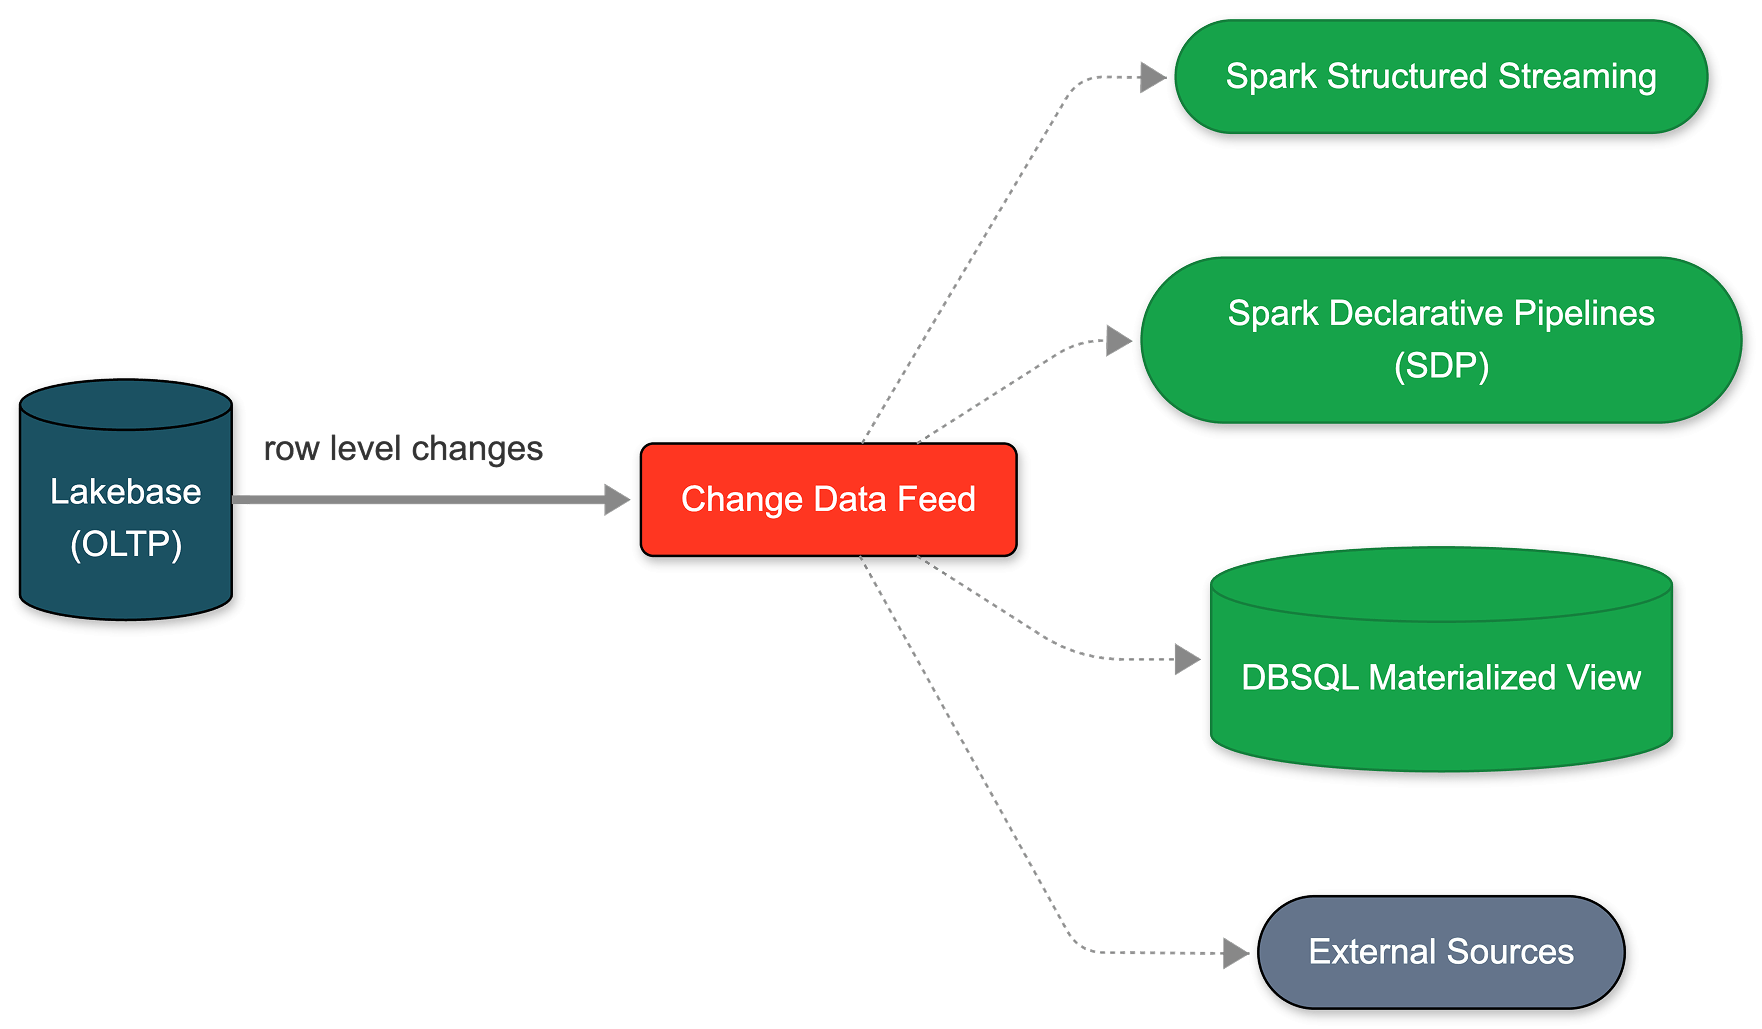
Lakebase推出了变更数据馈送(CDF),简化了从操作数据库到Lakehouse的数据提取过程。通过Unity Catalog管理,用户可以轻松启用CDF,提升数据治理和流通效率。这一新架构将操作数据库转变为Lakehouse的原生Bronze层,支持ETL和流式工作流,推动数据管理的开放性与高效性。
健康数据分散在多个系统中,标准化和统一这些数据是提升医疗效果的关键。Health Samurai与Databricks合作,基于开放标准的FHIR数据基础,消除数据孤岛,实现高效分析和合规性。通过无ETL的数据流动,组织能够灵活应对挑战,提升临床决策支持和患者关系管理,确保合规性成为架构的自然属性。
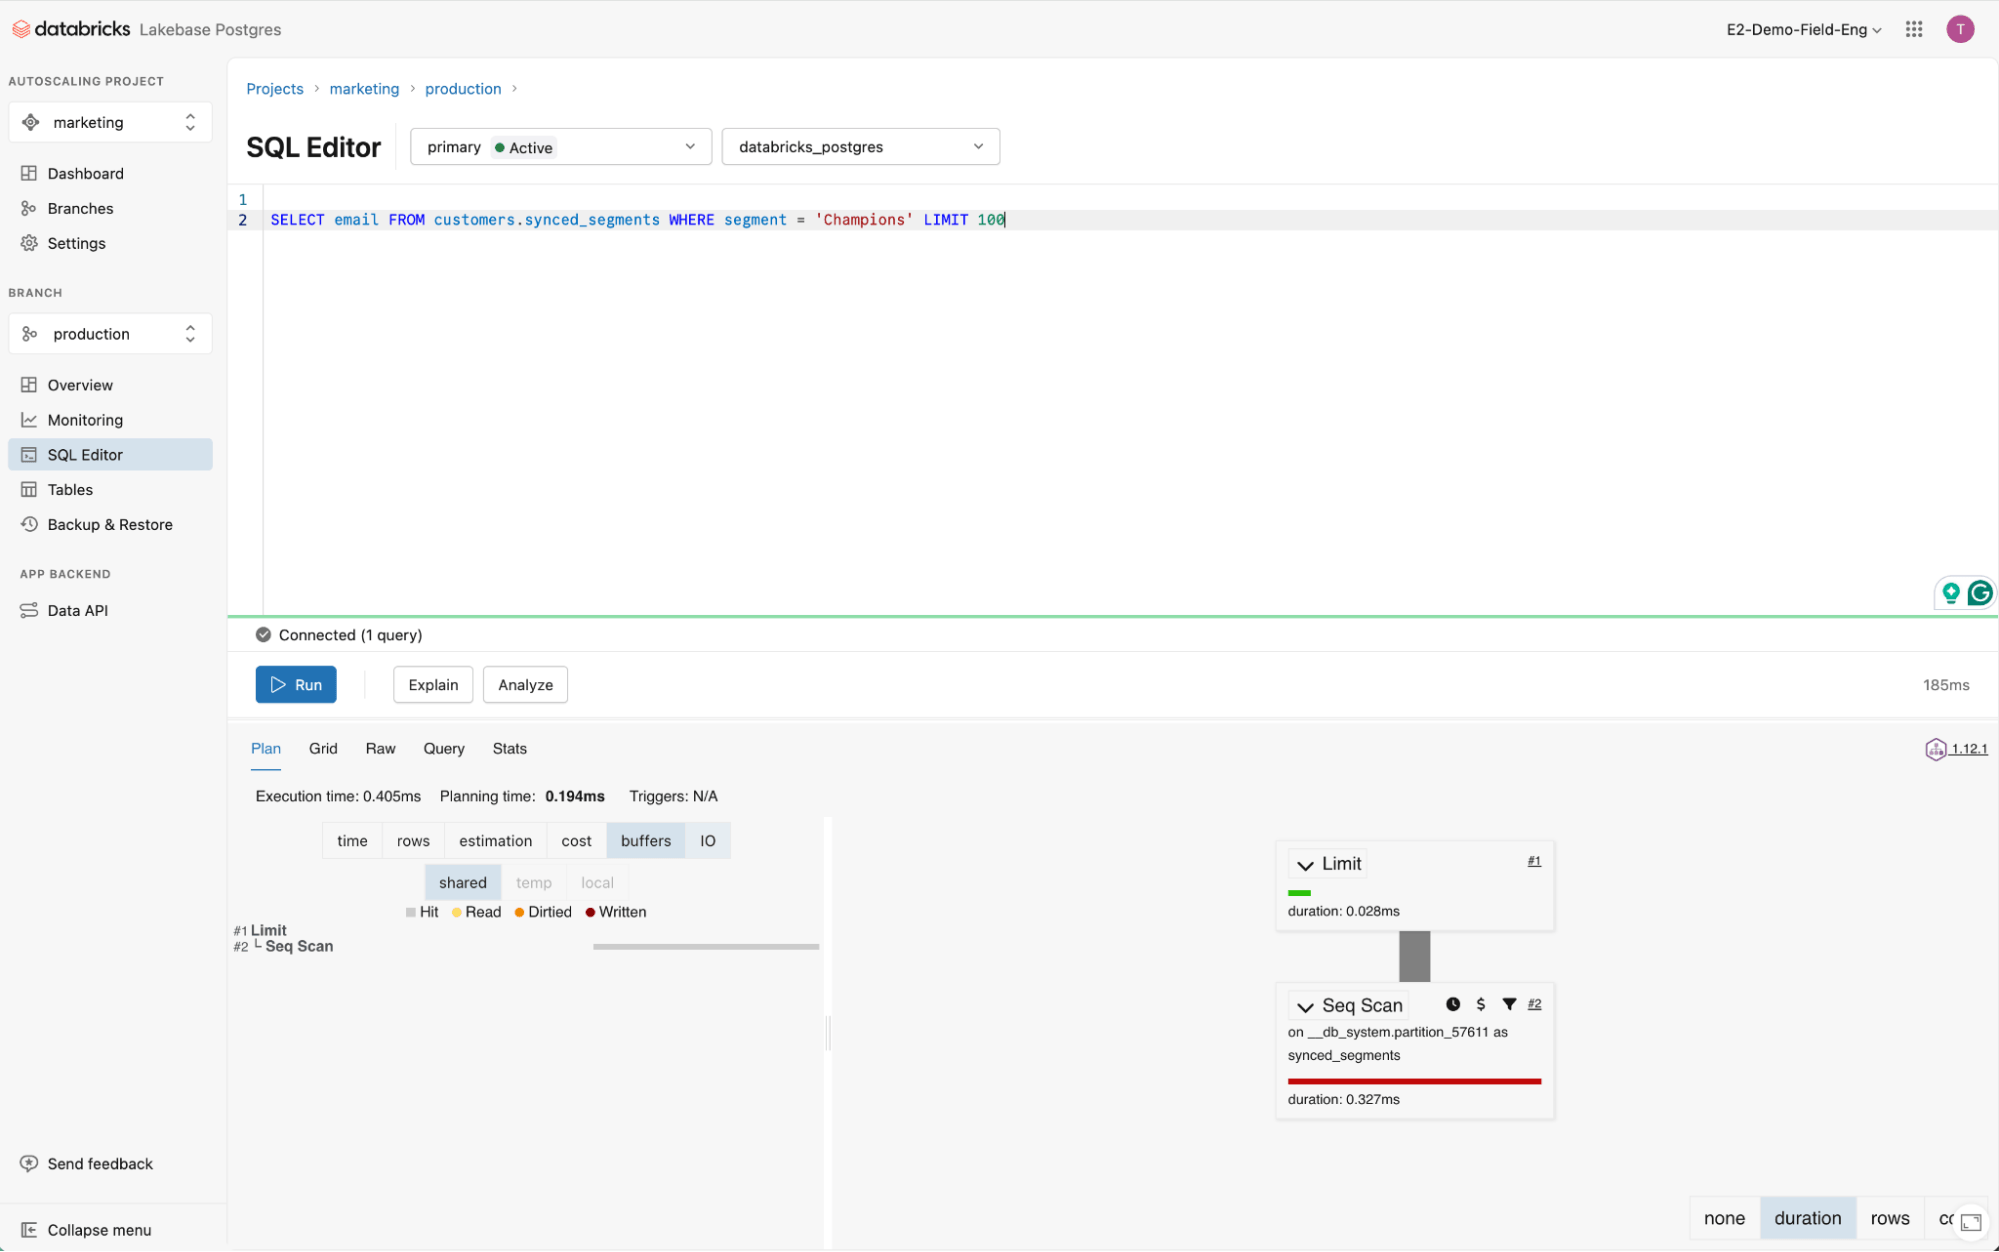
Databricks Lakehouse通过无服务器自动扩展显著降低了全渠道营销平台的总拥有成本(TCO)。它支持个性化营销活动,优化数据同步和查询性能,提升客户细分的低延迟服务能力,结合了事务数据库的优势和数据湖的灵活性,适合高并发查询,推动了营销效率的提升。
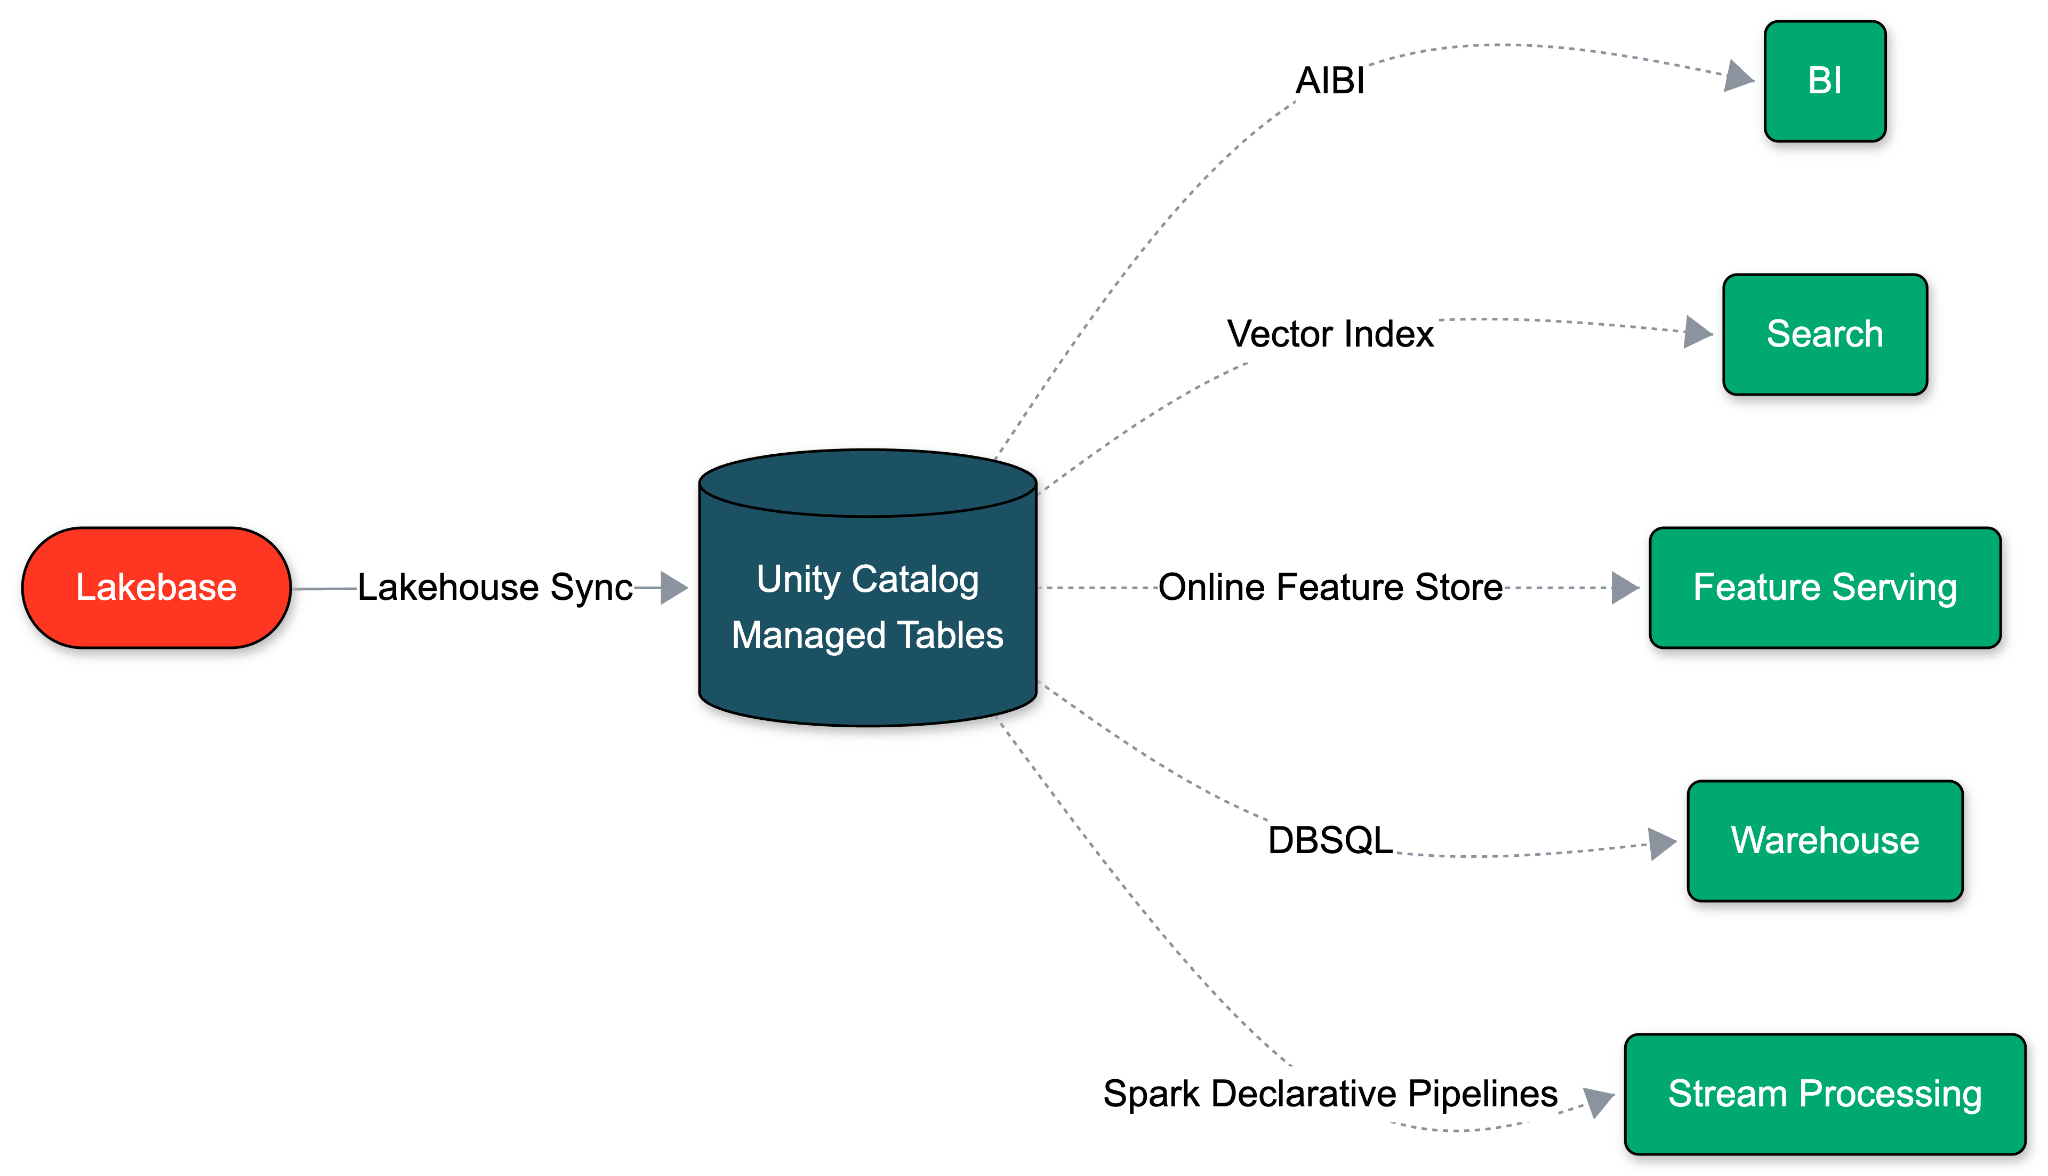
Databricks推出了Native Lakehouse Sync功能,允许Lakebase数据直接同步到Unity Catalog管理表,消除了ETL流程,提升数据流动性,支持实时分析和机器学习。用户可在一分钟内完成同步,确保数据一致性和合规性。
Snowflake's pg_lake and Databricks' Lakebase both wrap PostgreSQL for lakehouse workloads, but they're nearly opposite architectures.
HTAP(混合事务/分析处理)旨在将OLTP和OLAP系统合并,实现实时数据更新和高效分析。通过行列双引擎、行列一体存储和Lakehouse等方案,HTAP解决了传统架构中的数据一致性和性能问题。文章探讨了不同HTAP系统的工作负载隔离、新鲜度边界及评估方法,并提供了选型决策树,帮助企业选择合适的HTAP解决方案。
Lakehouse architectures enable multiple engines to operate on shared data using open table formats such as Apache Iceberg. However, differences in SQL identifier resolution and catalog naming...
电商平台的订单数据从500万条增长到5亿条,推动了数据架构的演进。从MapReduce、Lambda架构到Kappa架构,最终实现了批流一体和湖仓一体。Lambda架构虽然兼顾批流,但开发维护成本高,数据一致性难以保证;Kappa架构简化为单一流处理,但历史数据处理复杂。现代架构趋向于用同一引擎处理批流数据,Flink和Spark各有优势。Lakehouse融合了数据湖与数据仓库,解决了存储与查询性能问题。
MySQL HeatWave is a fully-managed MySQL database service that combines transactions, analytics, machine learning, and GenAI services, without ETL duplication. Also included is HeatWave Lakehouse,...
In traditional MySQL, analytics require data to be ingested into InnoDB tables and processed on a single primary instance using row-based storage engine and limited parallelism. Scaling analytical...
Zerobus Ingest是一种无服务器的数据流服务,简化了传统流架构,直接将数据推送至Lakehouse,降低成本并提升性能。它支持高并发连接,消除中间消息总线的复杂性,减少运营开销,适用于多种开发接口。
云存储是Lakehouse架构的基础,优化Delta表的存储成本至关重要。常见错误包括对象版本管理、存储类别选择和数据传输成本。使用合适的工具和策略可以避免不必要的费用,确保数据访问高效和完整性。
MySQL HeatWave Lakehouse enables queries on file formats like Parquet, Avro, ND-JSON and CSV in an object store. This blog introduces support for the Delta Lake table format, thereby enabling...
完成下面两步后,将自动完成登录并继续当前操作。