在M1 Mac上安装并实测OpenShell运行受控Coding Agent,验证了三项核心机制:程序×端点×HTTP方法三级策略、凭证以占位符形式进入沙箱、策略变更前先经形式化检查。实测遇到四个问题:gateway启动时静默拉取镜像导致假死;policy update漏带--binary会清空二进制列表;Alpine镜像下载因busybox不识别realpath -e而失败;gateway重启后所有沙箱进入Error状态且restart-policy不生效。结论:OpenShell适合高风险任务,但日常迭代仍有摩擦。
在M1 Mac上,Node.js最低支持版本为16,低于此版本需通过Rosetta 2转译运行。以asdf-vm为例,安装Node.js 14版本的步骤包括安装Rosetta 2并使用转译命令执行安装。如遇错误,可重新启动新shell以确保命令转译执行。
M1 Mac上安装低版本Node.js时,原生支持最低版本为16,更早版本需通过Rosetta 2转译运行。以asdf-vm为例,先安装Rosetta 2,再用`arch -x86_64 asdf install`命令安装Node.js 14。若遇错误,可启动Rosetta 2 shell后执行安装。
本文简要介绍了在React Native中设置Firebase云消息推送的步骤,包括Firebase配置、iOS推送通知启用、Android运行时权限请求等,并提供了M1 Mac用户的解决方案及常见问题排查建议,以确保推送通知正常运行。
本文介绍在M1 Mac上使用Ollama本地运行Mistral-7B模型的方法:安装Ollama后,在终端执行ollama run mistral即可运行基础模型;若已有微调模型,可用llama.cpp脚本将LoRA适配器转为GGML格式,编写Modelfile指定基础模型和适配器,再用ollama create创建并运行自定义模型;还可通过Python调用Ollama本地API,用curl命令发送提示并逐行解析返回结果。
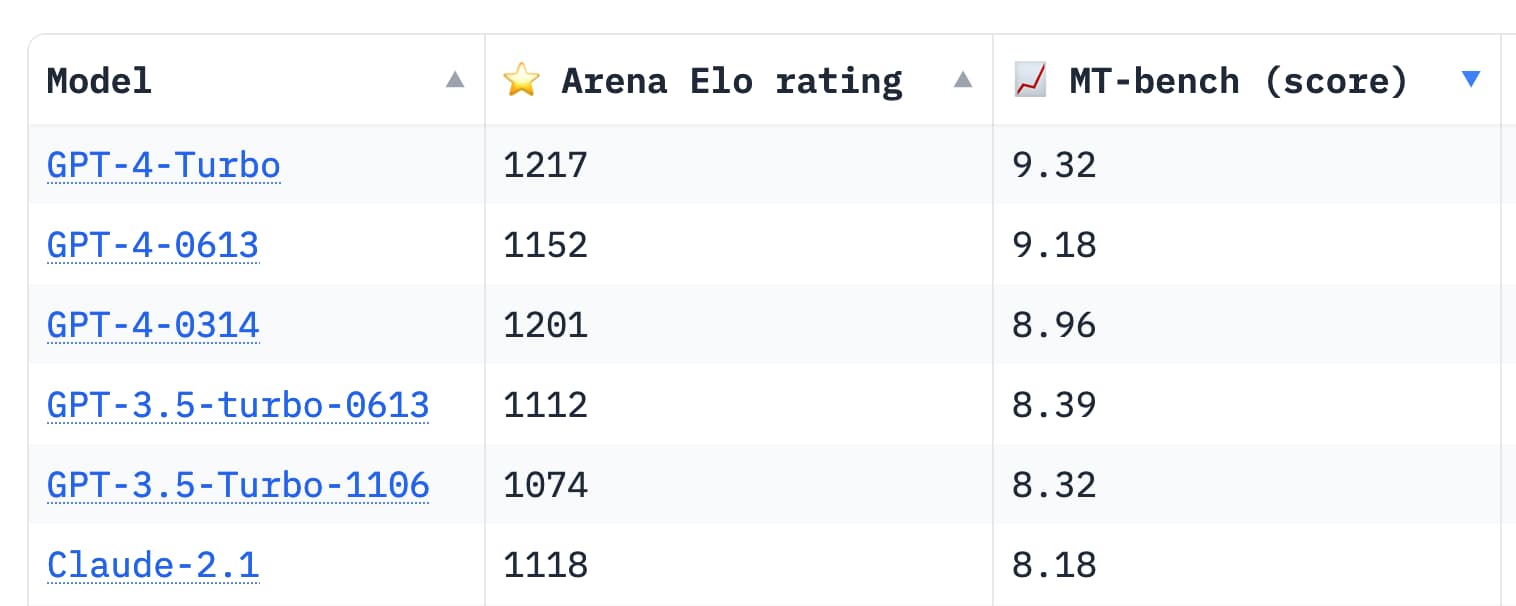
文章介绍在M1 Mac上运行Mistral模型的方法:通过llama.cpp和llm-llama-cpp插件运行Mixtral 8x7B,需下载GGUF文件并指定路径;Mistral 7B可用llm-llama-cpp、llm-gpt4all或llm-mlc运行;也可通过Mistral API及Replicate、Anyscale、OpenRouter等第三方服务调用。作者还介绍llm-mistral插件,并对比Mistral Small、Medium与GPT-3.5的基准成绩,认为Mistral Medium表现接近GPT-4。
GPT4All是一个基于大量数据训练的聊天机器人,可在M1 Mac和Windows等环境下运行。它包括约800k条GPT-3.5-Turbo生成数据,并可供个人使用。点击链接了解风险规避策略。
GPT4All是一款基于大量助手数据训练的聊天机器人,支持在M1 Mac和Windows等环境运行,标志着个人GPT时代的到来,用户可以轻松体验。
在M1 Mac上安装TensorFlow前需卸载Anaconda并删除相关文件,接着下载并安装Miniforge,最后验证TensorFlow版本及可用的GPU和CPU数量。
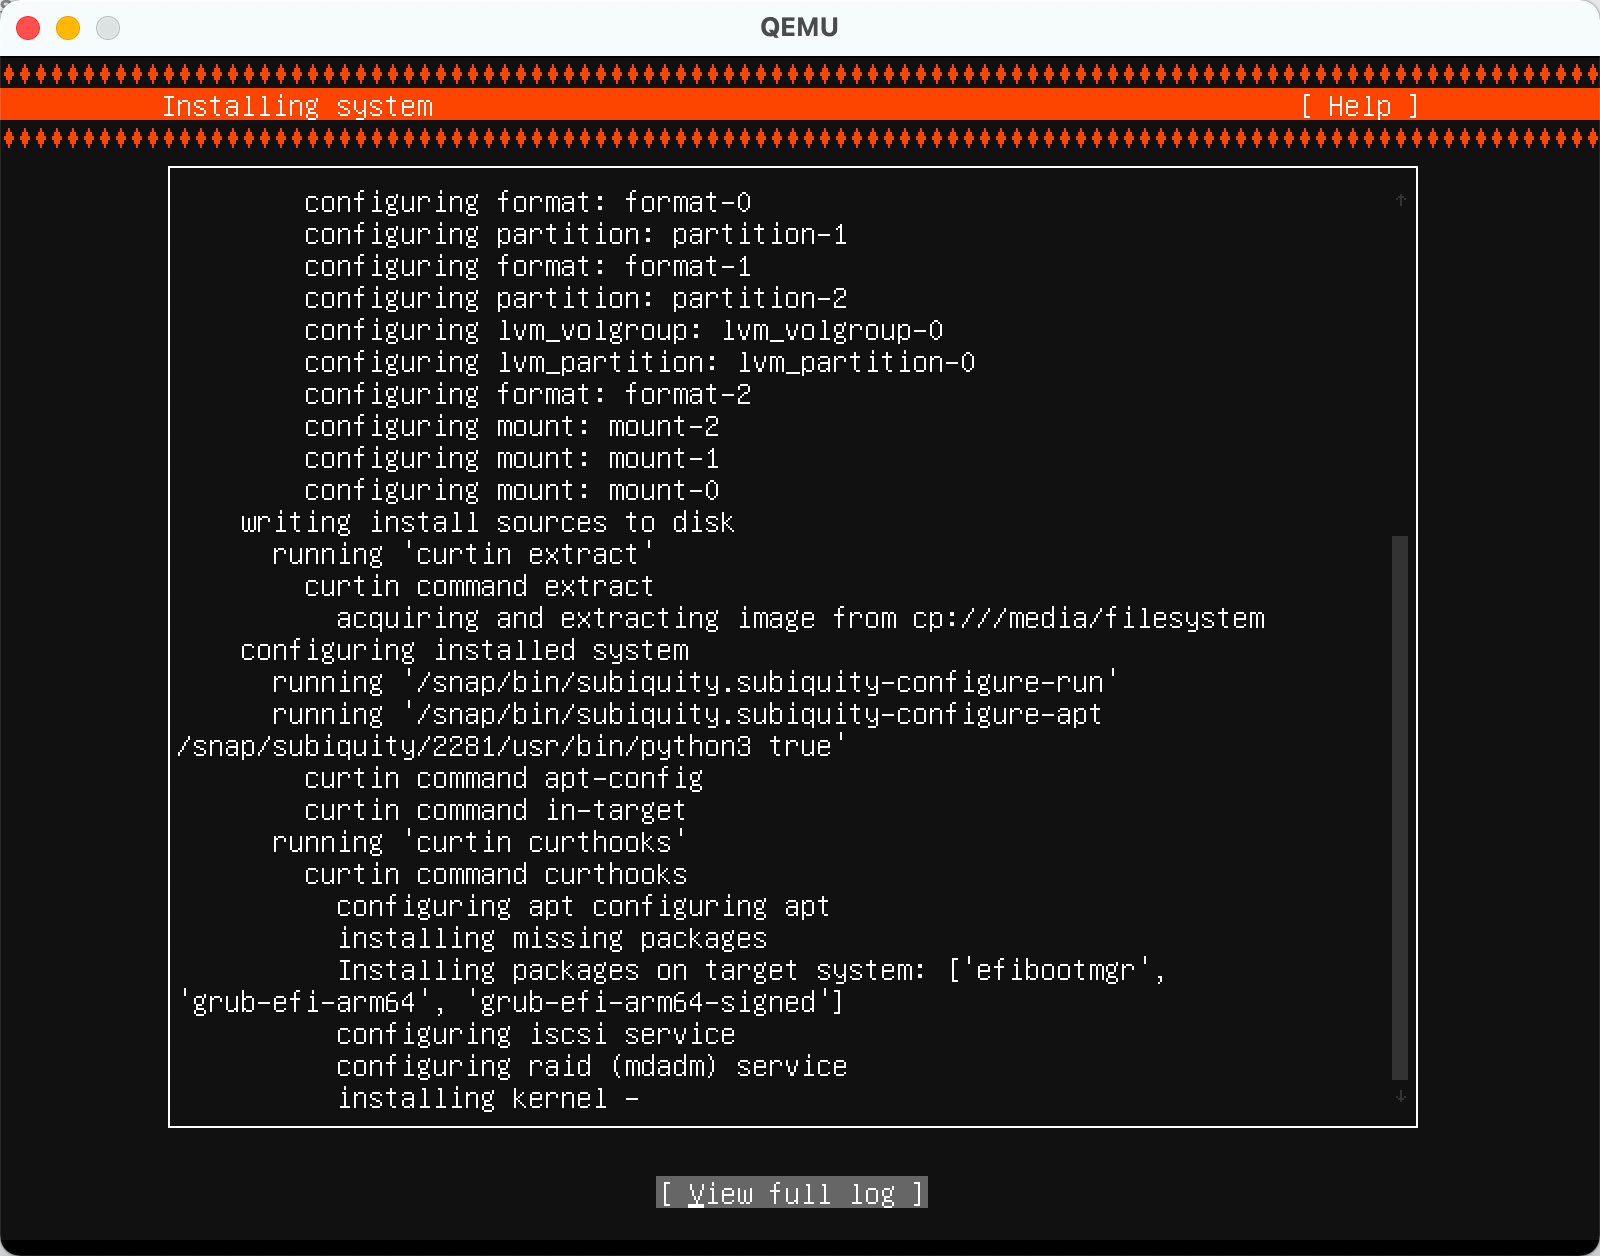
本文介绍在M1 Mac上自行编译QEMU以运行Linux镜像:brew安装的QEMU不支持M1,需使用QEMU 6.0并打上Alexander Graf的hvf补丁,安装ninja、glib等依赖后配置编译aarch64-softmmu并安装;随后给出启动Ubuntu Server 20.04 ARM64虚拟机的脚本,并建议使用gcc-11、检查hvf支持以便调试。
本文介绍在M1 Mac上构建QEMU并运行Linux虚拟机:用Homebrew安装依赖,克隆QEMU 6.0源码并打上Alexander Graf的hvf补丁,以aarch64-softmmu为目标编译安装;再用qemu-system-aarch64配合hvf加速、EDK2固件和Ubuntu 20.04 ARM镜像启动虚拟机,并给出调试建议。
在M1 Mac上搭建Linux内核开发环境时,由于brew安装的QEMU不支持Apple Silicon,需自行编译QEMU 6.0并应用Alexander Graf的hvf补丁,使用gcc-11构建aarch64-softmmu目标。安装后即可通过qemu-system-aarch64配合hvf加速运行Ubuntu Server等Linux镜像。
完成下面两步后,将自动完成登录并继续当前操作。