

在命令行中运行 Mistral 模型的多种方法 [译]
内容提要
文章介绍在M1 Mac上运行Mistral模型的方法:通过llama.cpp和llm-llama-cpp插件运行Mixtral 8x7B,需下载GGUF文件并指定路径;Mistral 7B可用llm-llama-cpp、llm-gpt4all或llm-mlc运行;也可通过Mistral API及Replicate、Anyscale、OpenRouter等第三方服务调用。作者还介绍llm-mistral插件,并对比Mistral Small、Medium与GPT-3.5的基准成绩,认为Mistral Medium表现接近GPT-4。
延伸解读
本地运行 Mistral 的硬件与量化选择
文章以 M1 Mac 为例,展示了通过 llama.cpp 运行 Mixtral 8x7B 的完整流程,但需注意模型文件大小:作者选择的 Q6_K 量化版本达 36GB,原始文件为 87GB。这意味着本地运行需要足够的存储和内存,且不同量化等级会影响输出质量与速度。对于资源有限的设备,Mistral 7B 是更实际的选择,甚至可在 iPhone 上通过 MLC Chat 运行。
API 服务商竞争与免费试用机会
由于 Mistral 模型采用 Apache 2 许可,Replicate、Anyscale、OpenRouter 等第三方托管商可提供竞争性价格。文章提到 OpenRouter 目前免费提供 Mistral 和 Mixtral 的 API 调用(每百万输入 token 0 美元),但作者也指出这种免费服务不太可能长期持续。对于想低成本尝试模型的开发者,这是一个值得关注的窗口,但需留意后续收费变化。
基准测试的参考价值与局限
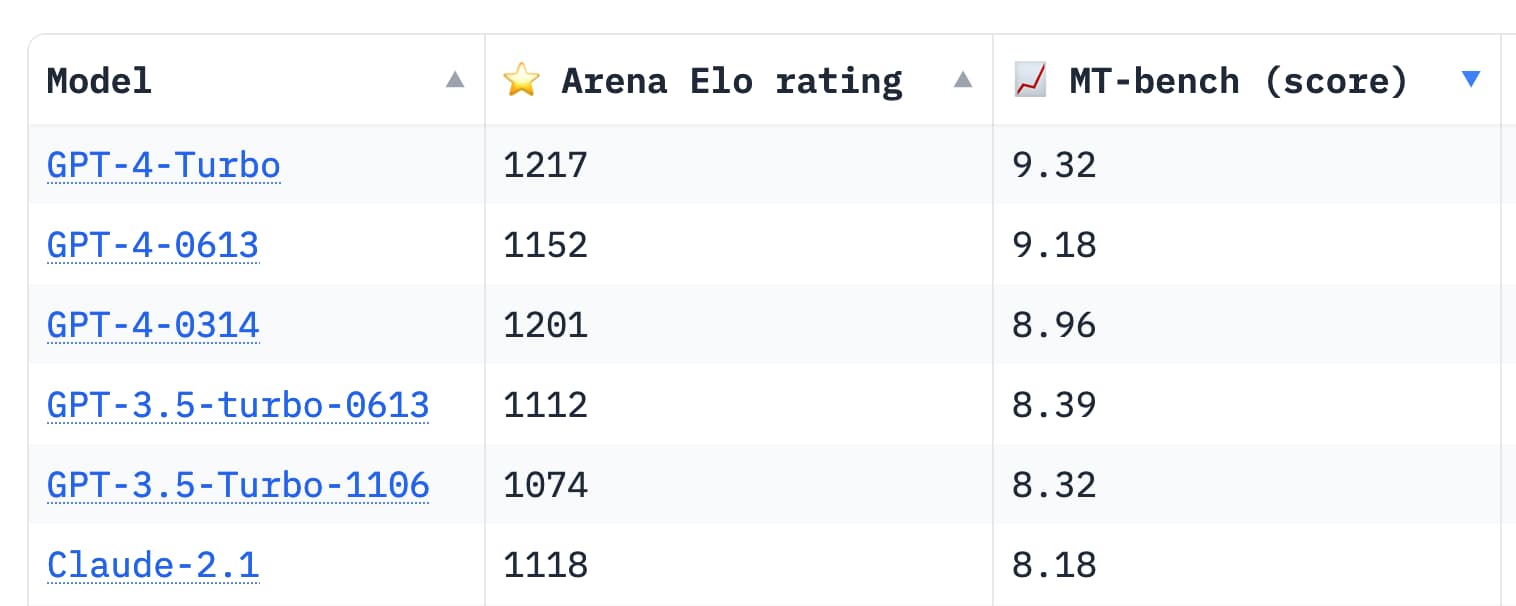
文章对比了 Mistral Small、Medium 与 GPT-3.5 在 MMLU、HellaSwag 等多项基准上的成绩,显示 Mistral Medium 在多数测试中领先 GPT-3.5,MT-Bench 得分 8.61 介于 GPT-3.5 和 GPT-4 之间。但作者提醒这些数据可能经过精心挑选,且基准分数只能提供参考,真正了解模型表现仍需亲自体验。读者应避免仅凭分数做决策。
Q&A
如何在M1 Mac上通过llama.cpp运行Mixtral 8x7B模型?
首先安装LLM工具和llm-llama-cpp插件,然后手动安装llama-cpp-python(在苹果硅芯片Mac上使用命令:CMAKE_ARGS="-DLLAMA_METAL=on" FORCE_CMAKE=1 llm install llama-cpp-python)。接着从Hugging Face下载GGUF文件(例如mixtral-8x7b-instruct-v0.1.Q6_K.gguf),最后使用命令:llm -m gguf -o path mixtral-8x7b-instruct-v0.1.Q6_K.gguf '[INST] 你的提示 [/INST]' 来运行模型。
Mistral 7B模型有哪些本地运行方式?
在Mac上本地运行Mistral 7B主要有三种方式:1) 使用llm-llama-cpp插件,下载GGUF文件后指定路径运行;2) 使用llm-gpt4all插件,安装后首次使用会自动下载模型;3) 使用llm-mlc插件,需先下载模型再运行。此外,还可以在iPhone上通过MLC Chat应用运行。
如何通过Mistral API使用Mistral-medium模型?
首先安装llm-mistral插件(llm install llm-mistral),然后设置Mistral API密钥(llm keys set mistral),之后即可使用命令如:llm -m mistral-medium '你的提示' 来调用Mistral-medium模型。该模型在MT-Bench上得分8.6,表现接近GPT-4。
除了官方API,还有哪些第三方服务可以调用Mistral模型?
文章提到了三个第三方API服务商:Replicate、Anyscale Endpoints和OpenRouter。它们都提供了相应的LLM插件,安装插件并设置API密钥后即可调用Mistral 7B或Mixtral 8x7B模型。其中OpenRouter目前免费提供这些模型(每百万输入token 0美元)。
Mistral Medium与GPT-3.5的基准测试成绩对比如何?
根据文章中的表格,Mistral Medium在多项基准测试中均优于GPT-3.5:MMLU(75.3% vs 70%)、HellaSwag(88% vs 85.5%)、ARC Challenge(89.9% vs 85.2%)、WinoGrande(88% vs 81.6%)、MBPP(62.3% vs 52.2%)、GSM-8K(66.7% vs 57.1%)、MT Bench(8.61 vs 8.32)。Mistral Small也几乎在所有测试中超过GPT-3.5。
如何使用Llamafile的OpenAI API端点运行Mixtral模型?
首先下载Mixtral的llamafile文件(如mixtral-8x7b-instruct-v0.1.Q5_K_M-server.llamafile),然后运行该文件启动服务。接着在LLM的配置文件(~/Library/Application Support/io.datasette.llm/extra-openai-models.yaml)中添加模型配置,指定api_base为"http://127.0.0.1:8080/v1"。之后就可以用 llm -m llamafile '你的提示' 来调用模型。
