DeepSeek-V4.1在主干外有两处改动。视觉端:自研DeepSeek-ViT从零训练,采用2D-RoPE、RMSNorm、SwiGLU,经3×3 pixel-unshuffle将token数除以9,再投影到5120维;1302×1302图像占994个位置,文本与图像token各用一套MoE负载均衡偏置。优化器端:head-wise Muon按注意力头分别正交化query权重;Sinkhorn-balanced update以行列交替归一化替代Adam二阶动量,仅存一份动量即可训练196B参数的Engram表。
DeepSeek-V4采用Muon优化器,通过谱范数最速下降实现逐矩阵正交化,用Newton-Schulz迭代逼近SVD,混合系数提升小奇异值并精确稳定大值。RMS匹配对齐AdamW,部分参数仍用AdamW。Q/KV归一化替代QK-Clip防logit爆炸,Anticipatory Routing打断MoE路由正反馈,MTP预测多token,训练配方含32T token等细节。
Kimi K3模型采用从零训练的MoonViT-V2视觉编码器,27层、patch14结构,支持高分辨率图像token化;MTP层预训练后微调为EAGLE-3投机解码draft模型;Per-Head Muon优化器按头正交化动量矩阵,提升训练稳定性。词表大小163840,采用稠密层设计,强调结构选择对系统设计的影响。
在文章《Muon优化器指南:快速上手与关键细节》中,我们罗列了Muon的几个版本,它们的区别是学习率的矩阵形状相关的缩放因子不同,其中“官方版(KellerJordan版)”只比“MuP版”多出...
DeepSeek-V4系列模型推出了1.6T和284B参数的两个版本,采用混合注意力架构和流形约束超连接,提升了长上下文处理效率。通过Muon优化器和多项基础设施优化,模型在训练和推理阶段展现出更高的稳定性和效率。预训练后,DeepSeek-V4在多个基准测试中超越前代,设立了新的性能标准。
经过《基于流式幂迭代的Muon实现:1. 初识》、《基于流式幂迭代的Muon实现:2. 加速》和《基于流式幂迭代的Muon实现:3. 雕琢》三篇文章,想必大家已经对流式幂迭代(Streaming...
回顾前两篇文章《基于流式幂迭代的Muon实现:1. 初识》和《基于流式幂迭代的Muon实现:2. 加速》,我们引入了Muon的流式幂迭代(Streaming Power Iteration)实现...
自去年提出的Muon优化器已在多个训练框架中应用,表现优异。本文介绍了从Adam切换到Muon的技术细节,包括不同版本的参数设置和注意事项。Muon专注于矩阵参数优化,用户需了解输入输出维度的定义以确保正确使用。
Muon Linux 是一款基于 Debian 的轻量级发行版,专为老旧硬件设计,提供高效、稳定的使用体验。它具有简化的配置流程和低资源占用的桌面环境,兼容 Debian 软件仓库,便于用户快速上手和优化系统。
本文探讨了Muon优化器的变体,提出通过放宽Gram矩阵约束设计多种流形约束优化器。Muon优化器通过正交化权重更新改善条件数,而流形Muon进一步将权重限制在特定几何形状上。研究表明,放宽约束可以在保持良好条件的同时提升优化器的灵活性和收敛速度。
四个月前,我们发布了Moonlight,在16B的MoE模型上验证了Muon优化器的有效性。在Moonlight中,我们确认了给Muon添加Weight Decay的必要性,同时提出了通过Upd...
机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。
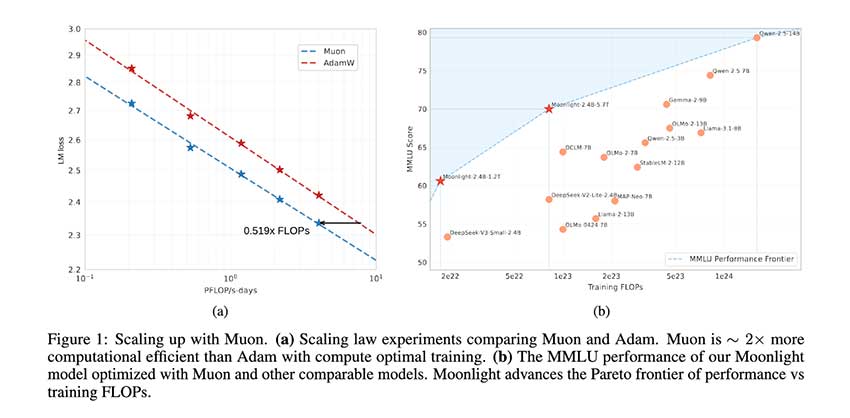
Muon优化器通过权重衰减和一致的RMS更新,提高了大规模语言模型的稳定性和效率,降低了计算成本。Moonlight模型表现优异,超越同类,支持多语言处理,推动高效训练方法的探索。
月之暗面开源了改进版Muon优化器,计算效率提升2倍,优于AdamW。新模型Moonlight在相同预算下表现更佳,支持大规模训练,无需调整超参数。
月之暗面团队改进了OpenAI的Muon优化器,使算力需求降低48%。新版本适用于更大模型,并验证了在分布式训练中的可行性。改进包括引入权重衰减和调整参数更新尺度,提升了训练效率和性能。
完成下面两步后,将自动完成登录并继续当前操作。