Claude Fable 5.2 发布,API 价格较前代降低 20%,输入每百万 token 8 美元、输出 40 美元。其在最高推理强度下以 65 分登顶 Artificial Analysis 智能指数,编程评测表现提升,但单任务成本 26.54 美元、耗时 46.4 分钟。官方建议日常编程使用 Opus 5.5,复杂长任务再用 Fable 5.2;快速模式价格翻倍。
OpenAI发布GPT-6.1 Terra,称其在科学编程和电脑操作任务上接近Opus 5.5且成本更低。作者自建三项测试:发布分诊两者打平;细胞追踪Terra得分更高;大表格任务Terra完成而Opus因超输出上限未作答。Terra总成本约为Opus的12%,耗时更短,但大表格数值仍有错误,结果不具可重复性。
Anthropic发布Sonnet 5.5,价格仅为Opus 5.5的一半。相同提示测试显示:Sonnet 5.5在代码修复和并发测试中更准、更快、更便宜,15次运行全部通过,总成本比Opus 5.5低约36%;Opus 5.5在智能体测试中更快、更省。建议硬编码任务默认用Sonnet 5.5并调高输出上限,智能体循环仍用Opus 5.5。
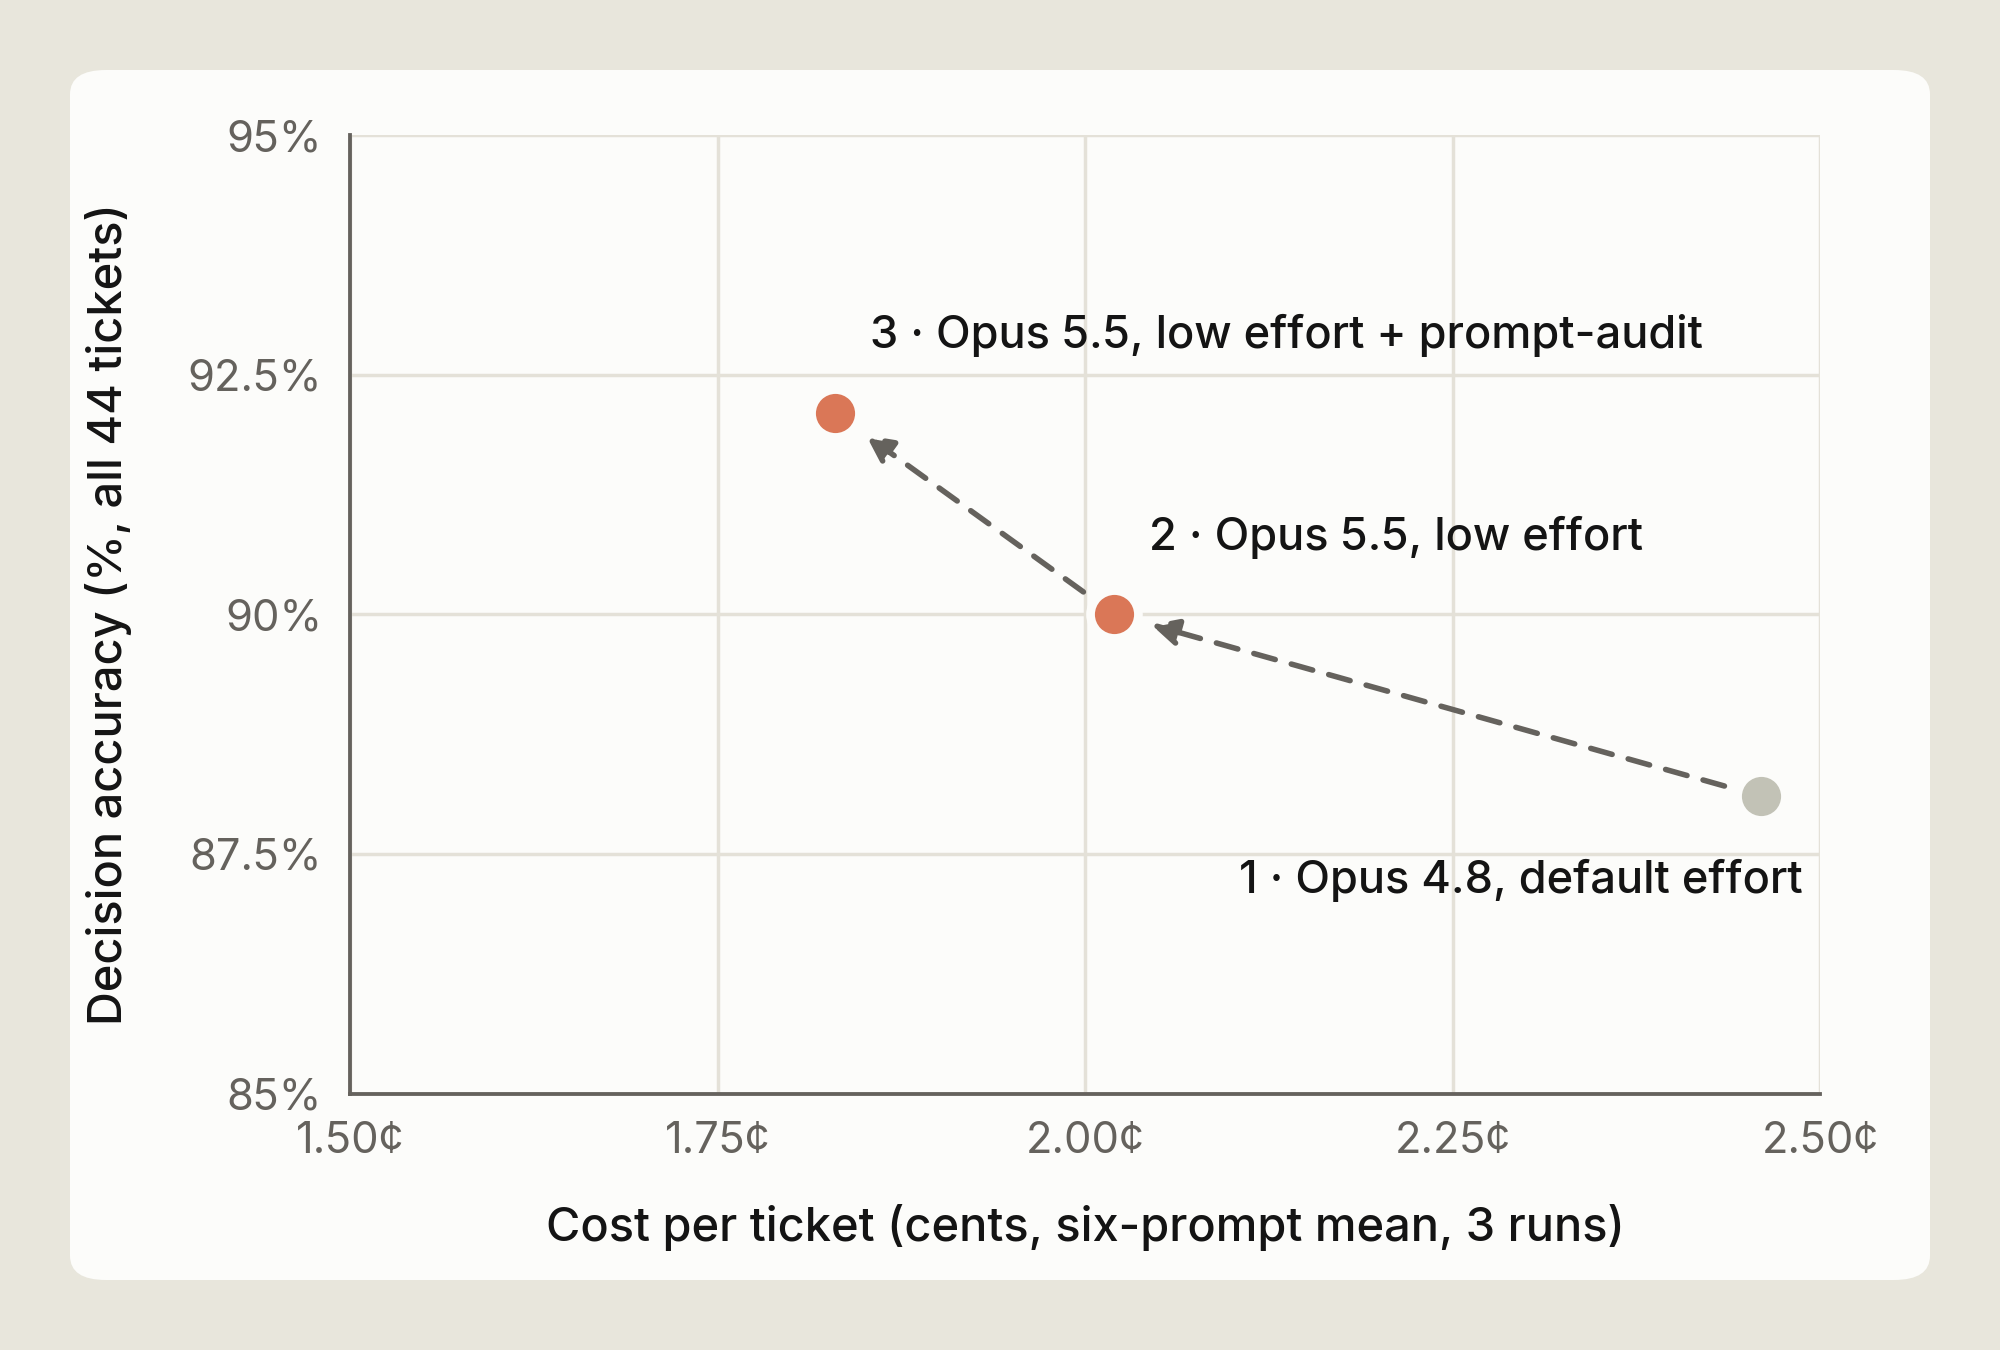
Databricks 通过 Unity Gateway 和 CLI,让超万名员工在新模型(如 Opus 5.5、GPT-6 Sol)发布首日即可试用,并标记为实验性。三天内依据基准测试、用户反馈和成本追踪确认性价比,随后转为正式模型。Opus 5.5 每会话成本降低 29%,将设为 Claude Code 默认;GPT-6 Sol 成本降低 48%,将纳入智能路由。
Databricks借助Unity Gateway和CLI,让1.2万名员工在新模型发布首日即可试用。通过实验标签、预算控制和成本追踪,团队在三天内评估了Opus 5.5与GPT-6 Sol的效率前沿。结果显示,Opus 5.5质量更高、成本降低29%,将设为Claude Code默认模型;GPT-6 Sol成本降低48%,将纳入智能路由。
Claude Code任务成本由轮次、缓存读取、输出token和模型选择构成。Opus 5.5较Opus 5输入输出便宜20%,缓存读取便宜60%。日常建议用中等effort让模型自检,卡住再升high,两次失败换Fable 5.1,搜索类子代理用Sonnet或Haiku。可用/usage查看实际用量,自行测量最可靠。
Anthropic发布Opus 5.5,跑分与价格均优于Fable 5.1,但社区用户仍用Fable做规划审查,因其在陌生任务中判断更稳。跑分难测真实项目能力,且存在污染问题。实际工作流正形成分工:Fable规划审查,Opus执行实现,兼顾性能与成本。
完成下面两步后,将自动完成登录并继续当前操作。