
Opus 5.5 上执行任务要花多少钱
内容提要
Claude Code任务成本由轮次、缓存读取、输出token和模型选择构成。Opus 5.5较Opus 5输入输出便宜20%,缓存读取便宜60%。日常建议用中等effort让模型自检,卡住再升high,两次失败换Fable 5.1,搜索类子代理用Sonnet或Haiku。可用/usage查看实际用量,自行测量最可靠。
延伸解读
轮次与缓存:成本的两大杠杆
任务成本由轮次、缓存读取、输出token和模型选择决定。每轮都会重发整个对话,因此轮次越多,输入token越多。缓存读取价格极低,高命中率能大幅降低输入成本。例如,90%缓存命中率下,2.8M输入token成本约$1.62,无缓存则高达$11.20。保持会话稳定、避免中断,是维持高缓存命中率的关键。
Opus 5.5的价格变化与节省幅度
Opus 5.5的输入输出价格比Opus 5低20%,缓存读取价格低60%。节省幅度取决于任务类型:缓存密集的长会话最多可省60%的输入成本;短问题长回答因输出主导,最多省20%。大多数Claude Code任务介于两者之间。实际节省需用/usage测量自己的任务。
effort与模型切换的权衡
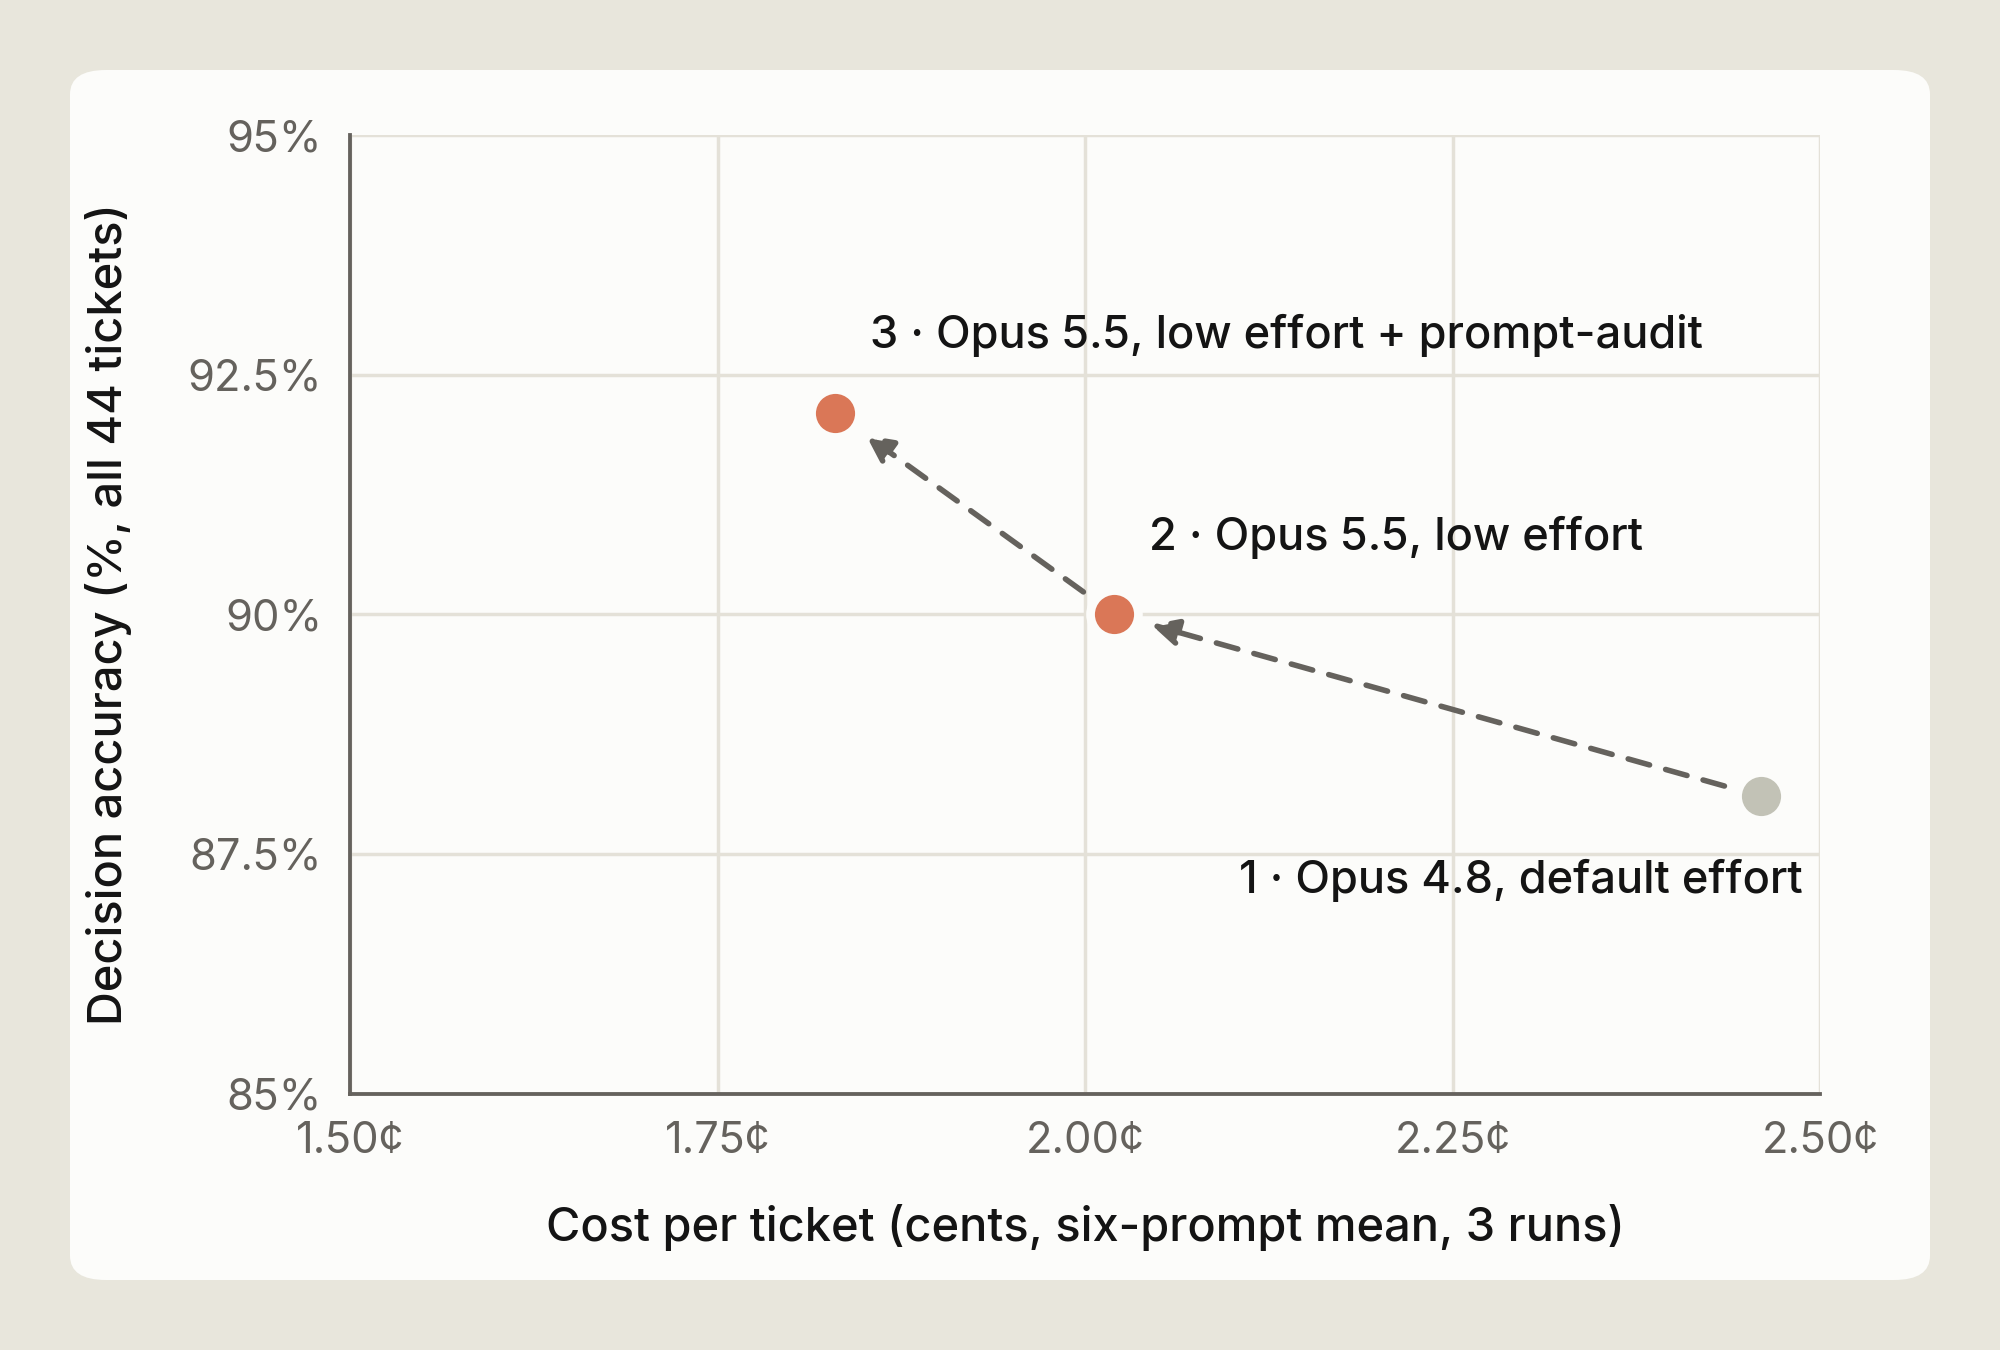
日常任务建议用中等effort,让模型自检;卡住时升到high。high增加思考token,但若节省一次重试就值得。若high两次失败,换Fable 5.1,解决后切回。搜索类子代理用Sonnet或Haiku,代码编辑保留Opus 5.5。切换effort或模型会清空缓存,导致下一次请求支付缓存写入费用,因此应在自然断点进行。
缓存与压缩的实用技巧
缓存写入成本高于读取,5分钟缓存写入是输入价的1.25倍,1小时为2倍。长时间暂停、更改effort或模型、连接MCP服务器、压缩对话都会导致缓存失效。使用/clear结束无关任务,用/compact在断点压缩并指定保留内容。压缩成本约$0.25,但后续每轮节省约$0.025,约十轮回本。
Q&A
Opus 5.5 相比 Opus 5 在价格上有什么变化?
Opus 5.5 的输入和输出 token 价格比 Opus 5 便宜 20%,缓存读取价格便宜 60%。具体来说,Opus 5.5 的输入价格为每百万 token 4 美元,输出为 20 美元,缓存读取为 0.20 美元。
在 Claude Code 中,一次任务的花费主要由哪些因素决定?
一次任务的花费主要由四个因素决定:轮次(turns)、缓存读取(cache reads)、输出 token 类型和模型选择。轮次越多,重发的上下文越多,成本越高;缓存读取价格远低于输入价格;输出 token 最贵,是输入价格的 5 倍;不同模型单价不同。
如何降低 Claude Code 任务的花费?
可以采取以下措施:使用中等 effort 进行日常任务,卡住时再升到 high;给模型提供检查工作的方式(如测试、构建);批量工具调用;保持会话稳定以提高缓存命中率;对搜索类子代理使用 Sonnet 或 Haiku;使用 /clear 清理无关任务,使用 /compact 在自然断点压缩上下文;迁移时运行 /claude-api prompt-audit 检查提示词。
Opus 5.5 的 effort 等级有哪些?分别适用于什么场景?
Opus 5.5 有四个 effort 等级:low、medium、high 和 xhigh,外加 max 用于单次会话。low 适用于机械性工作,如重命名或应用已知模式;medium 适用于范围明确的日常工作;当 medium 停滞时尝试 high;xhigh 和 max 用于最复杂的任务。可以用 /effort 命令设置等级,/effort status 查看当前等级。
什么时候应该从 Opus 5.5 切换到 Fable 5.1?
当结果比 token 价格更重要时,例如无人监督的长任务、代码库中没有现有模式的问题、需要协调多个子代理的大型更改。如果 Opus 5.5 在 high effort 下同一个问题失败两次,就切换到 Fable 5.1,问题解决后再切回。Fable 5.1 的输入价格为每百万 token 10 美元,输出 50 美元,是 Opus 5.5 的 2.5 倍。
如何查看自己会话的实际用量和成本?
在会话中运行 /usage 或 /cost 命令。Session 块会显示 token 使用量和按标价估算的美元成本,以及提示缓存行显示缓存输入的比例。对于团队,可以使用 Claude Code Analytics API 或 Usage and Cost API 查看按用户或按模型的成本报告。
缓存写入和读取的成本分别是多少?如何避免不必要的缓存写入?
在 Opus 5.5 上,缓存读取成本是新鲜输入 token 的 5%,即每百万 token 0.20 美元。缓存写入成本更高:5 分钟缓存为输入价格的 1.25 倍,1 小时缓存为 2 倍。避免不必要的缓存写入的方法包括:不要在会话中途更改 effort 或 thinking 设置、不要连接或断开 MCP 服务器、不要切换模型、避免长时间暂停超过缓存生命周期。
为什么长会话的每轮成本更高?如何管理长会话?
因为每一轮都会重新发送整个上下文,即使缓存命中,随着上下文增长,每轮成本也会增加。例如,在 20K token 上下文时,一轮的缓存读取成本约 0.004 美元;在 150K 时约 0.03 美元。管理长会话的方法包括:使用 /compact 在自然断点压缩历史,使用 /clear 在无关任务间清空会话,保持会话稳定以维持高缓存命中率。
