华为云RDS Supabase AI应用正式公测,基于开源Supabase与RDS PostgreSQL全托管能力,提供认证、数据API、存储、实时推送等开箱即用的BaaS服务,可将后端开发周期从月级缩短至天级。相比自建方案,它支持一键部署、主备高可用、安全合规与可视化运维,并内置pgvector向量检索和MCP接入,使AI Agent可直接操作数据库,实现数据自主可控。
该课程介绍如何在 PostgreSQL 内构建生产级混合搜索,无需 Elasticsearch 等外部集群。它结合关键词匹配与向量语义检索,用 RRF 在 SQL 中合并排序结果,并以 24 万篇维基百科文章为例,演示 BM25 排序、pgvector 存储 384 维嵌入、查询计划分析,以及 Python、FastAPI 和 Psycopg 后端实现。
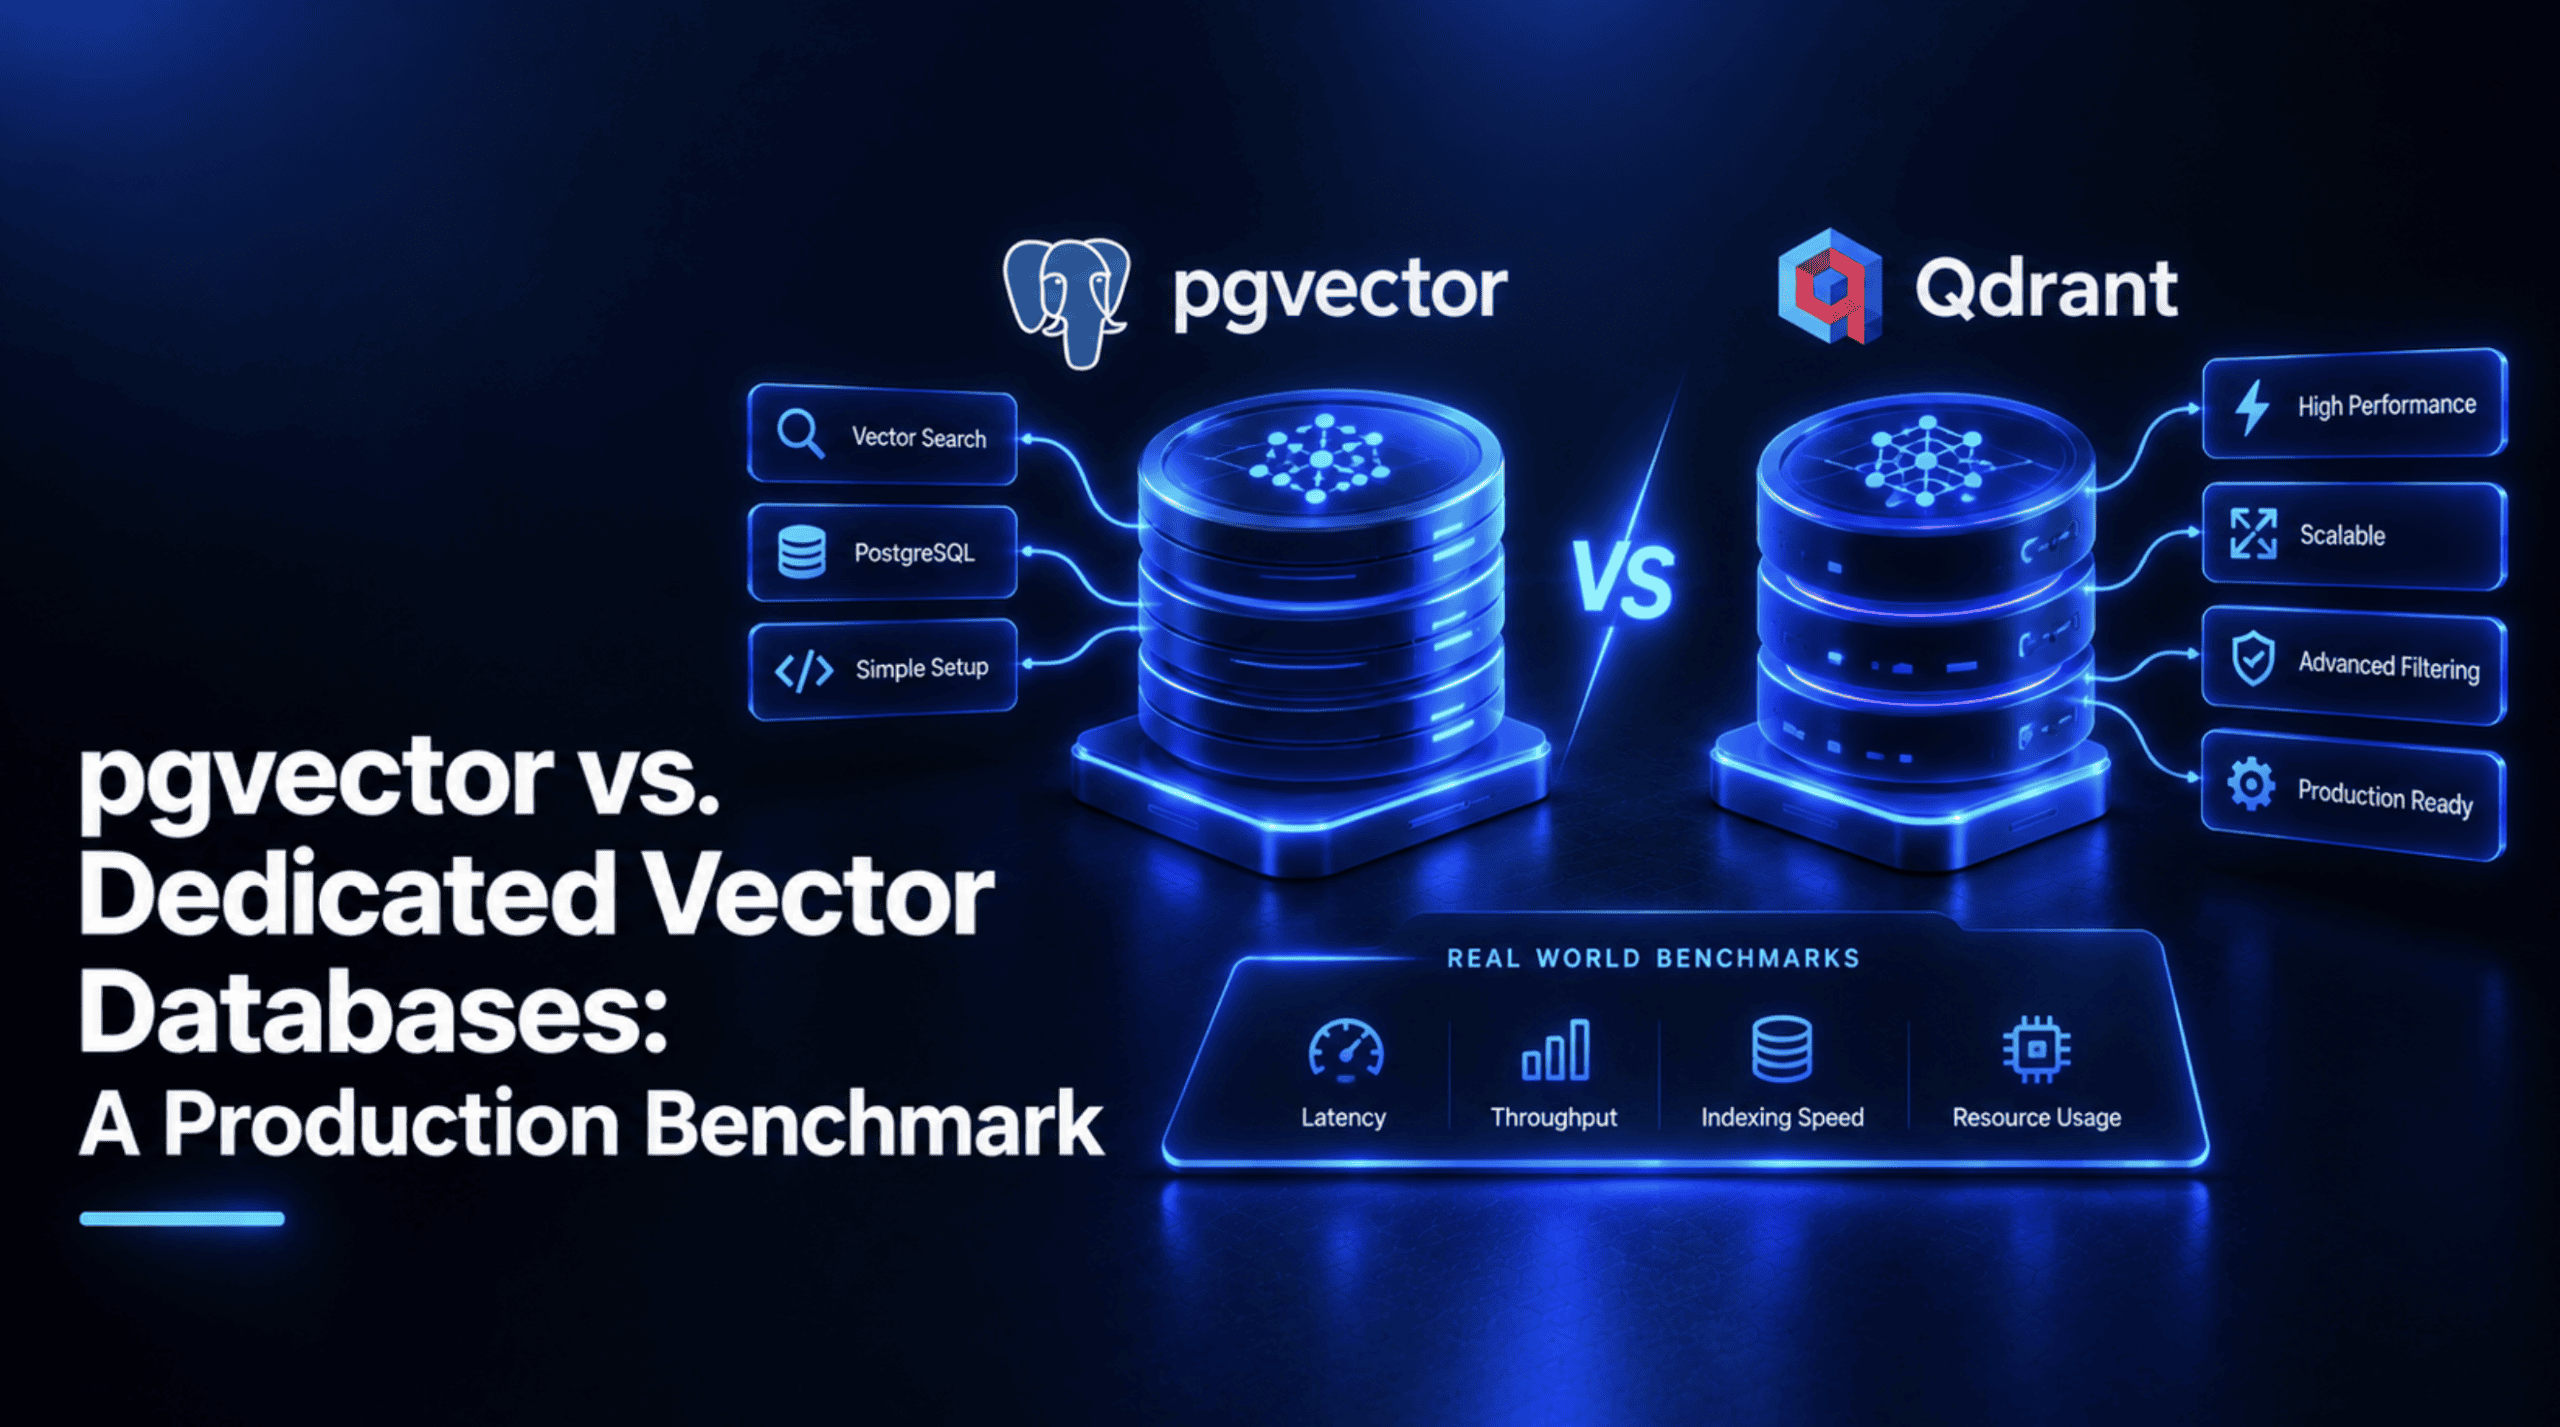
文章比较了pgvector与专用向量数据库。pgvector是Postgres扩展,可在同一数据库内同时存储向量与关系数据,支持多种向量类型和距离函数。作者用Docker在本地对pgvector和Qdrant做基准测试,但10万向量的规模太小,难以得出结论。文章引用Tiger Data的5000万向量生产级测试:在99%召回率下,pgvector配合pgvectorscale吞吐达471 QPS,远超Qdrant的41 QPS;但Qdrant尾延迟更优,p99为38.71ms对74.60ms,索引构建也快约3.4倍。结论:千万级以下、需要事务一致性的场景选pgvector;超大规模、严格尾延迟SLA或零运维需求的场景选专用数据库。
本文讨论AI数据库选型,需同时兼顾向量检索与事务数据。评估标准包括分支隔离、无服务器扩展、混合搜索、ACID保障和统一访问。文章对比了Pinecone、Weaviate、pgvector、Milvus、Qdrant、Redis、MongoDB Atlas、Chroma及Databricks Lakebase等方案:专用向量库适合大规模检索,pgvector适合已有Postgres环境,Lakebase则整合事务、搜索与分析。选型应依据检索模式、现有技术栈、并发延迟及治理需求。
PGConf.Asia 2026将于11月17日至18日在香港举行。EDB成员将作为演讲者参与,议题涵盖PostgreSQL未实现功能、AI生成SQL、基于pgvector的混合搜索与RAG管道、横向扩展架构与核心开发、数据建模与锁竞争等性能调优,以及基于CloudNativePG和TPA的Kubernetes集群运维。
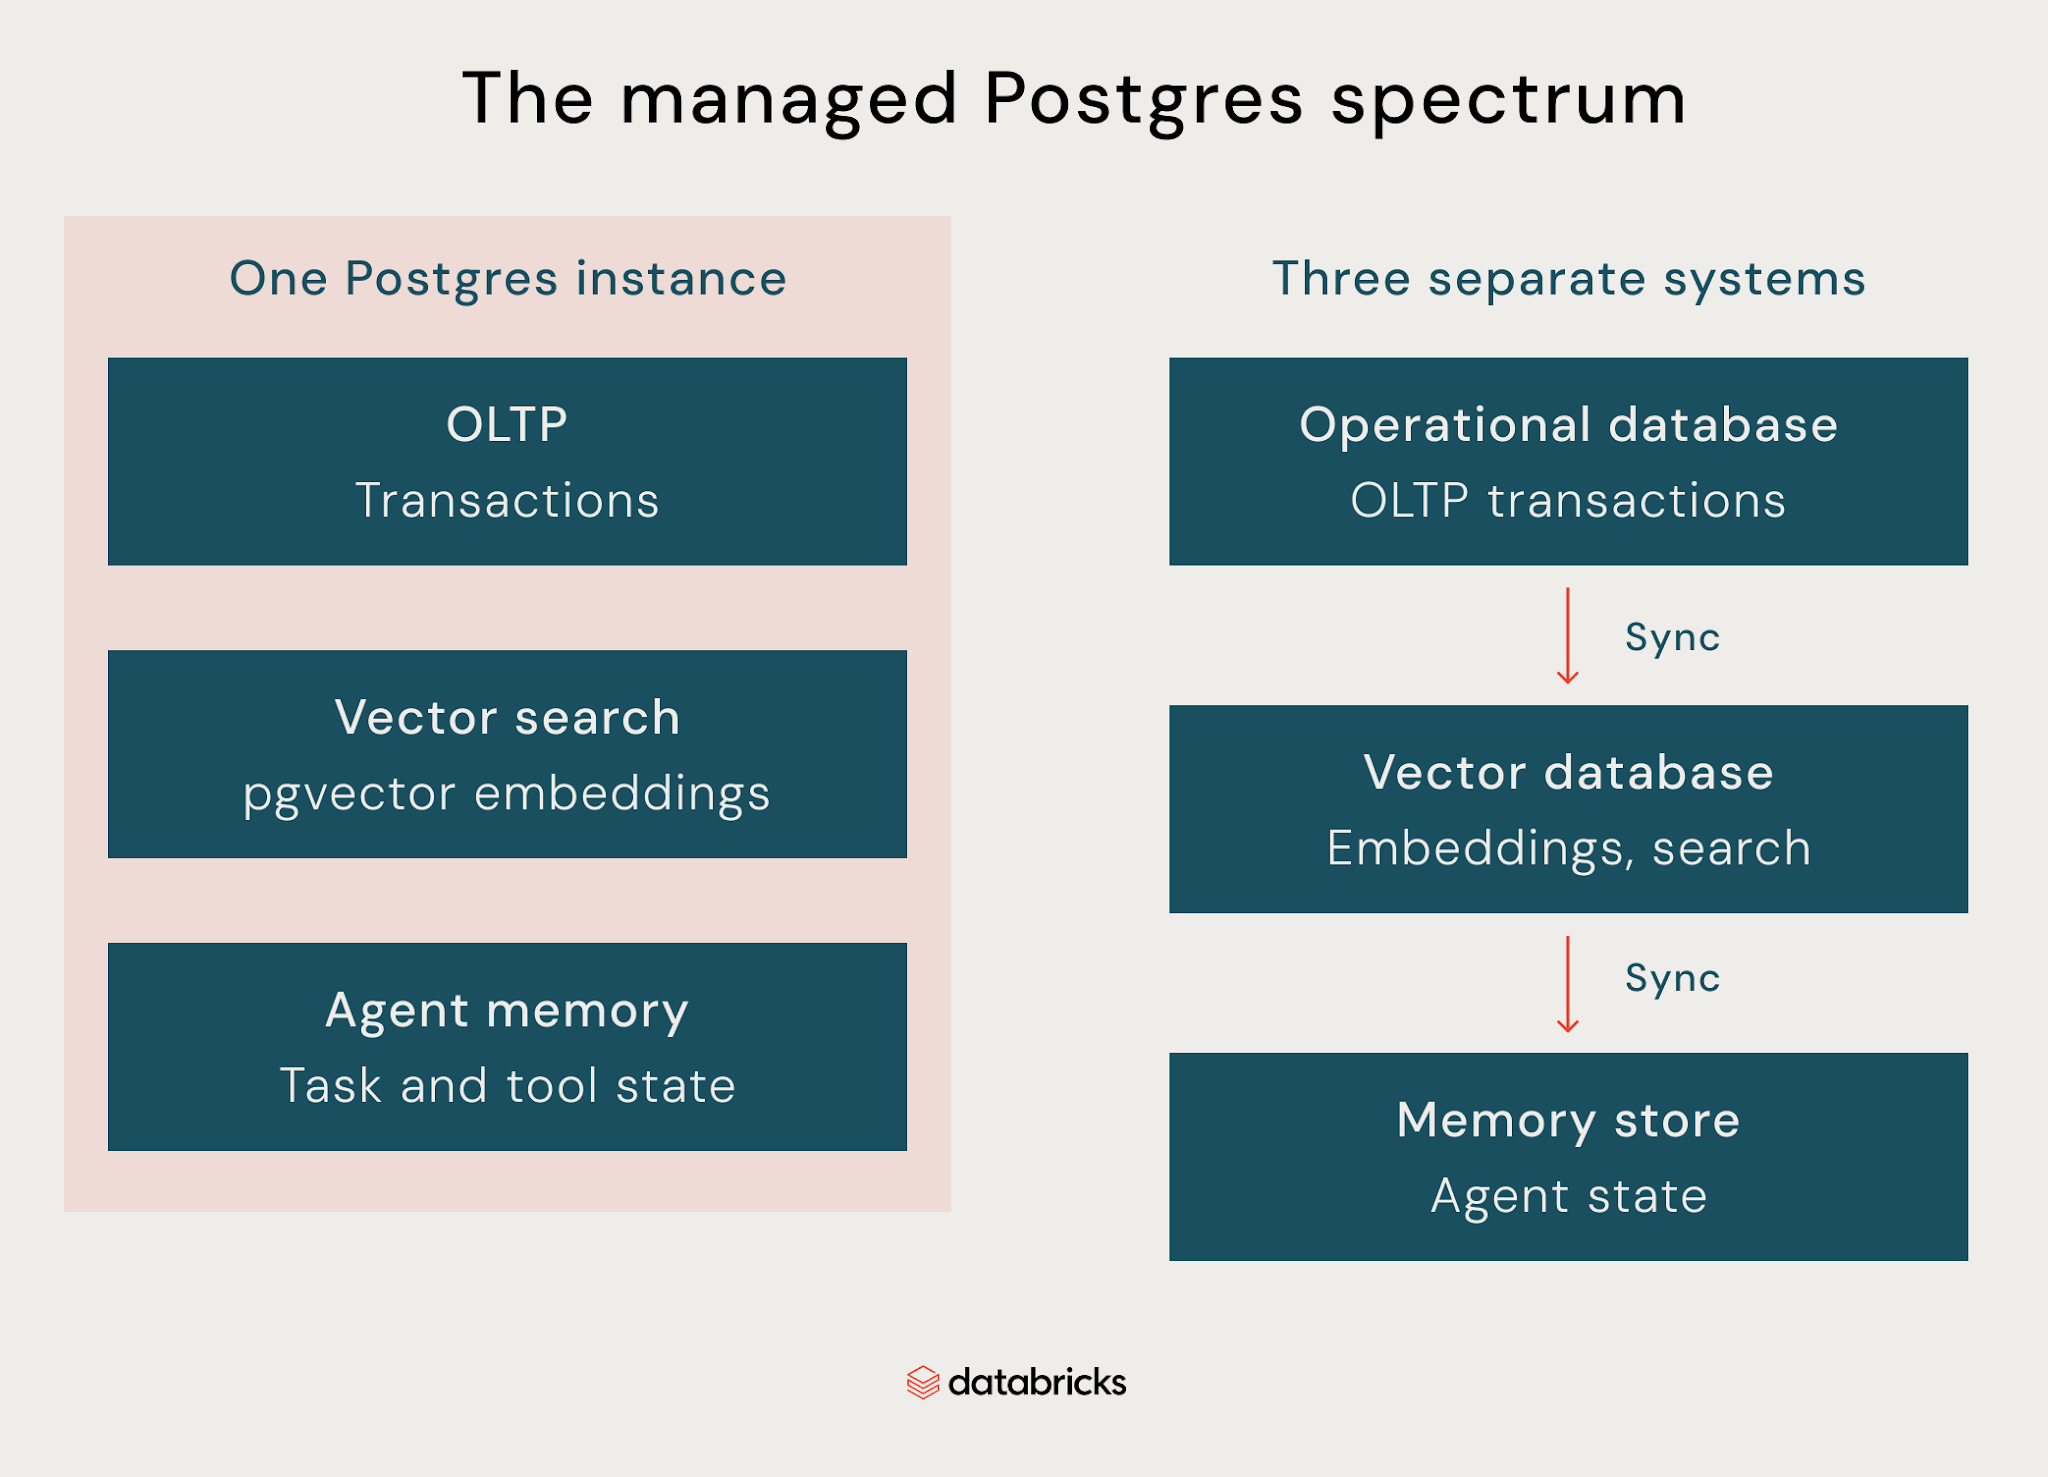
Databricks Lakebase 是全托管无服务器 Postgres,自动处理补丁、扩缩容、故障转移和备份,写入速度比标准 Postgres 快 5 倍,内置时间点恢复、安全、连接池和数据库分支,支持 pgvector 向量检索与 LLM 状态存储,适合 AI 应用。跨区域灾难恢复仍处私有预览,需手动故障转移。
本文比较了Redis与专用向量数据库(如Pinecone、Milvus、Qdrant)及pgvector的优劣。Redis作为统一实时平台,整合向量搜索、语义缓存、会话管理等功能,可降低基础设施复杂性和LLM成本,适合混合工作负载。专用数据库在超大规模或特殊调优时更优,pgvector适合小规模场景。选择取决于架构需求、运维能力和成本考量。
本文介绍Postgres与pgvector实现混合搜索(向量相似度+标量过滤)的模式。核心问题是向量索引返回近似排序结果,无法直接与WHERE过滤结合。pgvector 0.8提供迭代索引扫描,但需权衡召回率与性能。其他方案包括:部分HNSW索引(适合低基数稳定过滤)、过采样后过滤(适合高基数)、缓存响应(适合重复查询)。文章还提供EXPLAIN诊断方法和选择指南。
pgvector v0.8.0将HNSW索引作为PostgreSQL索引访问方法实现,向量以varlena存储于8KB页中,与业务表共享WAL、缓冲区和VACUUM。相比Milvus,它支持同进程事务和SQL,但受限于页装箱、默认后过滤和资源争用。选型应基于隔离需求与生命周期管理,而非单纯比较ANN算法性能。
本文介绍了如何使用检索增强生成(RAG)技术处理大型API文档。通过将文档分块和提取向量,用户可以快速查询相关信息。系统使用Node.js、PostgreSQL和Google Gemini等技术,支持用户上传PDF并通过自然语言提问,返回相关答案。教程详细说明了项目设置、数据库连接、文档处理和查询流程,旨在提高文档的可用性和查询效率。
本文讨论了向量检索引擎Milvus的架构与功能,重点介绍了HNSW、DiskANN、IVF-PQ等算法的应用,以及向量库的选型与RAG召回机制。内容涵盖写路径、读路径和索引内核,适合RAG和AI平台工程师、数据平台工程师等专业人士阅读。
本文总结了构建完整AI系统的过程,包括数据库设置、索引创建、文档嵌入和相似性搜索等步骤。使用pgvector与PostgreSQL集成,设计决策关注工具选择、记忆管理和多步骤推理。未来将探讨评估、可观察性和安全性等主题。
pgvector 0.8.2 fixes CVE-2026-3172, a heap buffer overflow in parallel HNSW index builds that can leak data or crash the server.
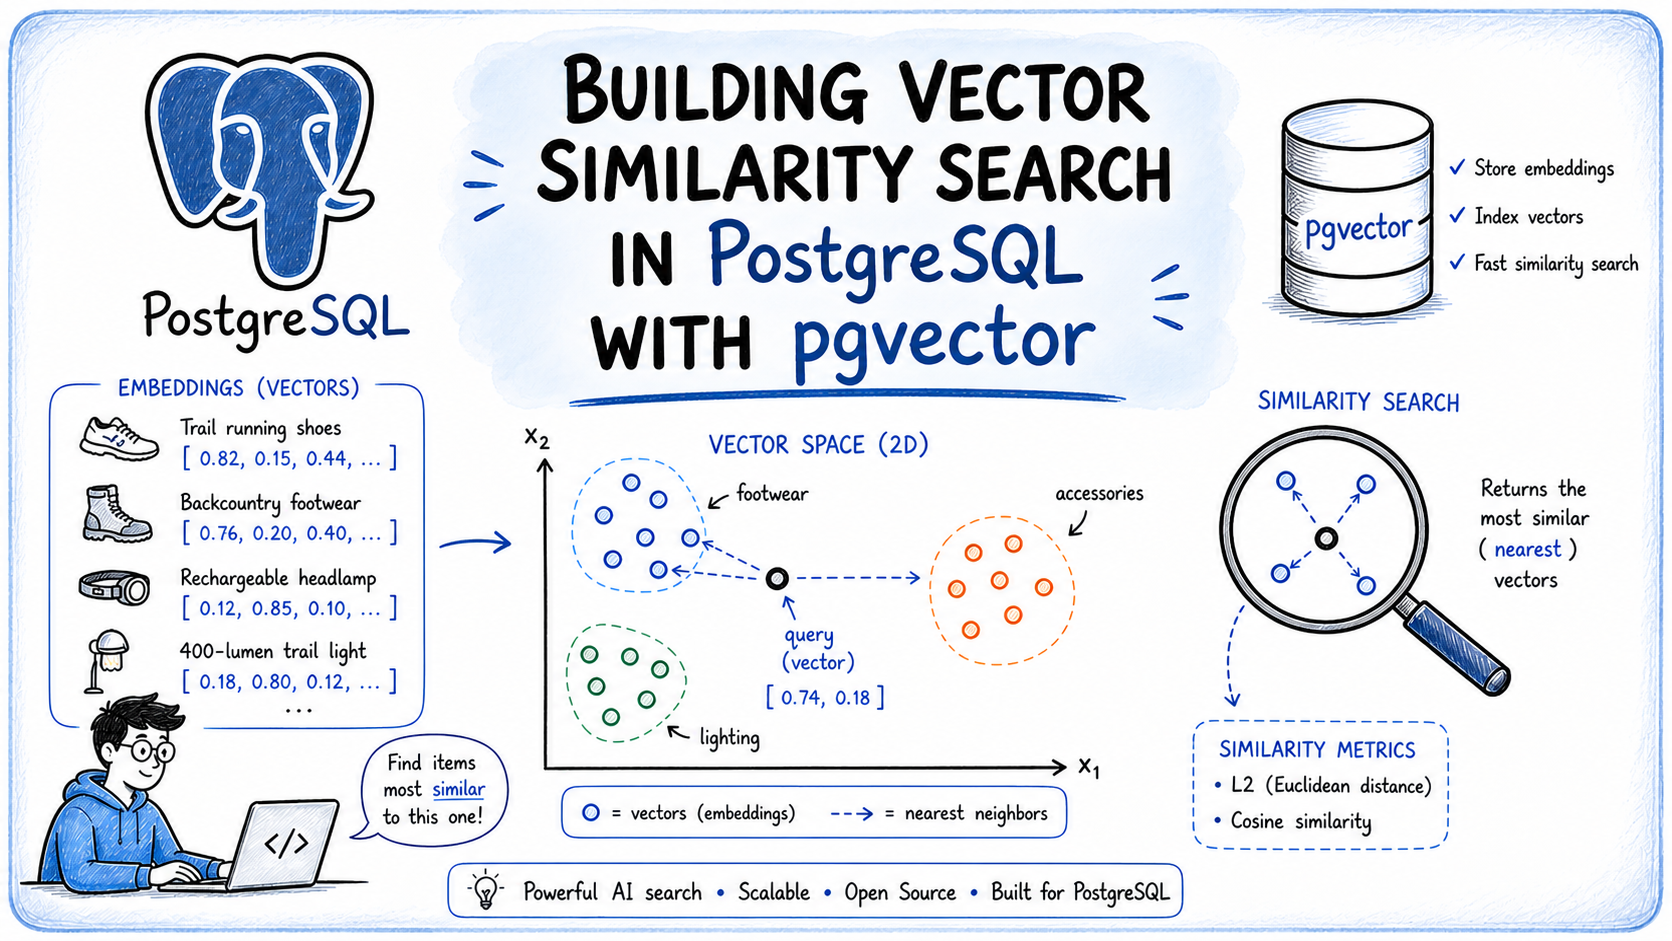
本文介绍了如何在PostgreSQL中使用pgvector扩展进行向量相似性搜索。pgvector支持将向量嵌入与关系数据存储,提供多种距离度量和索引类型。通过示例,展示了创建表、插入数据和执行相似性查询的方法,并结合SQL过滤器提升搜索效果。选择合适的嵌入模型和距离度量至关重要。
Instacart的搜索系统经历了多次演变,最初使用Elasticsearch,但因数据频繁变动导致性能问题,最终转向Postgres并整合语义搜索。通过pgvector,Instacart实现了更高效的搜索,减少了写入负担,提高了搜索速度和结果相关性,显著提升了用户体验和收入。
pgvector是一个开源的PostgreSQL扩展,支持存储和搜索向量嵌入,适用于语义搜索和推荐功能。它简化了相似性搜索,能够处理数百万到数千万个向量,支持余弦相似度,并可与Postgres全文搜索结合使用。对于高性能需求,pgvectorscale可扩展pgvector的能力。
许多AI项目失败并非因为模型本身,而是由于现实环境的限制。成功的AI系统需要与现实保持紧密联系,使用PostgreSQL和pgvector存储嵌入,并通过SQL确保数据的有效性和可用性。书中提供实用模式,帮助开发者在生产中构建智能应用,避免后期添加定价和库存等功能。
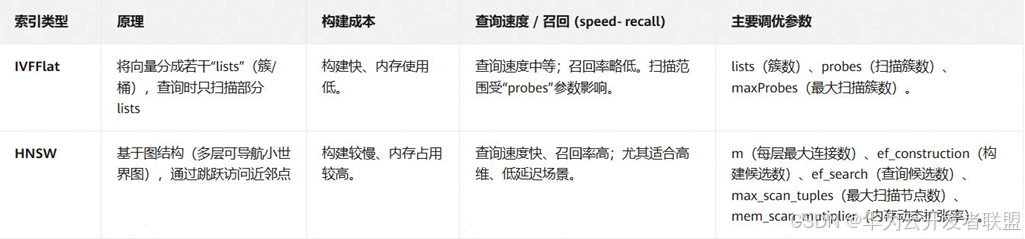
pgvector是一个开源Postgres扩展,支持在关系数据中存储和查询向量嵌入。最近的改进,如HNSW索引,提升了查询性能。成功使用pgvector需要基准测试、调整索引参数,并结合SQL操作来优化性能,特别关注冷缓存性能和数据分区策略。
大多数建议是先使用pgvector,后续再升级。但分析表明,pgvector适合处理小于100万向量的数据集,并需满足六个条件。超出这些条件后,应用可能会遇到查询缓慢和过滤失效等问题。专用向量存储在过滤、混合搜索和扩展性方面更具优势。
本文介绍了DWS通过集成pgvector插件,实现高维向量数据检索,解决传统数据库在处理非结构化数据时的局限,提升商品推荐系统的语义搜索与相似度计算能力。
完成下面两步后,将自动完成登录并继续当前操作。