Meta将其新商业条款的生效日期推迟至11月20日。该条款被指允许Meta抓取新闻网站内容用于AI训练,引发全球出版商以及欧盟和英国广告商的抗议,新闻/媒体联盟已致信扎克伯格要求修改。Meta表示延期是为了解释网络爬虫的使用方式,并强调内容所有者仍可通过robots.txt表达偏好。
Meta在受到批评后修改商业条款,删除了暗示可抓取新闻网站内容用于训练AI的表述。此前该条款被解读为允许免费使用抓取内容并绕过robots.txt限制。Meta高管曾否认改变爬虫做法,后澄清该条款仅适用于广告和商业产品,不影响爬虫使用,内容所有者仍可通过robots.txt表达偏好,此次更新未赋予超越该偏好的新权利。
Cloudflare 推出新系统,持续评估已验证机器人是否遵守网站偏好:检查其是否遵循 robots.txt、收到 429 后是否降速,并据此形成可解释的信任等级。信任需长期行为积累,而非仅凭身份验证。该机制与 Bot Preference Sync、Bot Management 共同构成问责闭环,未来将向所有客户开放。
作者使用Claude 20x套餐重写博客时,发现因改名导致robots.txt正式生效,使网站被搜索引擎屏蔽四个月。随后进行全面优化:弃用Bootstrap和jQuery,将Markdown改为服务端渲染,增加PWA离线阅读、搜索、后台草稿与标签管理,并修复SEO问题,共发布11个版本。作者认为AI虽能耐心穷举但常出错,需人工把控方向,并担忧程序员岗位将大幅缩减。
Cloudflare推出新设置,允许网站禁止AI训练爬虫,同时保持搜索引擎收录。该设置通过robots.txt区分搜索、训练和代理三类爬虫行为。苹果、谷歌、微软已承诺遵守。原有阻止设置也适用于混合用途爬虫,可能影响搜索。新域名将获推荐配置,广告变现网站默认更严格。
Cloudflare推出Bot Preference Sync功能,帮助网站所有者同步AI机器人偏好设置与robots.txt文件。该功能允许用户配置搜索、代理和训练类机器人的访问权限,并自动更新robots.txt。新客户默认启用,出版网站可选择默认禁止训练。此功能旨在提高透明度,让网站所有者更好地控制内容使用。
本文探讨了如何优化网站以便AI智能体理解和访问,主要步骤包括审查robots.txt文件、创建/llms.txt文件、提供Markdown版本页面和实现内容协商。这些措施可以提高网站在AI工具中的可见性,确保内容被有效读取和利用。
文章讨论了如何优化内容以提高AI的可见性,强调结构化数据的重要性。通过合理配置robots.txt和llms.txt,确保AI能有效抓取和理解网站内容。AI搜索关注内容的清晰性和可靠性,建议创建知识端点以便AI更好地引用和理解内容。
Cloudflare推出了isitagentready.com工具,帮助网站优化以适应AI代理。分析显示,大多数热门网站的代理准备度不高。该工具提供评分和反馈,鼓励网站采用新标准,如robots.txt和内容信号,以提升与AI代理的互动。网站所有者可以通过该工具了解如何提高代理友好性。
如果网站没有 robots.txt 文件,谷歌搜索将删除所有搜索结果。谷歌爬虫会检查该文件,若不存在则视为拒绝抓取,已收录的内容也会被清除。站长应定期检查网站流量和 robots.txt 状态。
作者分享了维护个人网站的经验,探讨了AI爬虫对内容采集的影响。通过配置Nginx和使用robots.txt,限制不守规矩的爬虫访问,并记录封禁其IP,表达了对AI爬虫的不满。
RSL 联盟由雅虎等公司成立,推出 RSL 1.0 版,旨在让 AI 公司为抓取网站内容付费。该标准扩展了 robots.txt 文件,虽然无法直接阻止爬虫抓取,但支持的网络服务商可以拦截未付费的爬虫,从而平衡 AI 技术与内容出版商的利益。
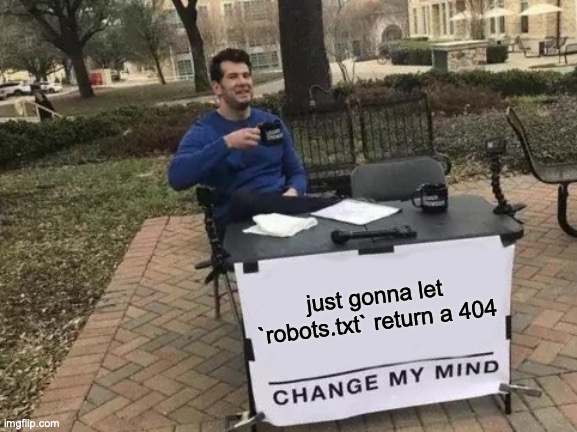
/robots.txt是博客上最常请求的资源,过去30天请求次数达15,553次。尽管返回404错误,作者不打算修复,因为对遵守该文件的人缺乏信心。
文章讨论了大型语言模型(LLM)爬虫对网站的影响,指出这些爬虫常常忽视robots.txt规则,导致网站流量激增和资源消耗,给小型网站带来困扰。文章还探讨了防范爬虫的技术手段。
Cloudflare推出内容信号政策,允许网站运营者在robots.txt中表达对内容使用的偏好,以保护内容创作者的权益,解决数据抓取问题,增强创作者对数据使用的控制。
一家大型金融机构发现其网站出现异常的机器人流量,经过分析发现流量来自谷歌的合法爬虫。调查显示,早期的SEO攻击导致谷歌索引了恶意搜索页面。机构通过更新robots.txt和提交移除请求解决了问题,强调了识别合法爬虫的重要性。
Perplexity的爬虫行为隐蔽,试图绕过网站限制,修改用户代理并忽视robots.txt文件。尽管被网站阻止,Perplexity仍能获取受限内容。相对而言,良好的爬虫应遵守规则。Cloudflare已将其列为非认证爬虫并采取阻止措施。
Cloudflare为网站所有者提供了两种新工具,以控制AI爬虫对其内容的访问,用户可以选择让Cloudflare管理robots.txt文件,或仅在广告部分阻止AI爬虫。这些措施旨在保护内容创作者的权益,防止其内容被用于AI模型训练。
网络爬虫自1993年起存在,随着AI的发展,其角色变得复杂。爬虫分为“好”与“坏”,约30%的网络流量来自爬虫。AI爬虫如GPTBot迅速崛起,数据收集用于训练AI模型,带来内容权利和隐私问题。网站通过robots.txt管理爬虫访问,AI爬虫的使用日益增加,影响网络内容获取方式。
Ziff Davis起诉OpenAI,指控其未经许可复制作品并训练AI模型,称OpenAI违反robots.txt文件并删除版权信息。Ziff Davis要求法院停止侵权并销毁相关数据集。
完成下面两步后,将自动完成登录并继续当前操作。