Scikit-LLM 是一个 Python 库,将预训练大语言模型封装为 scikit-learn 风格的 fit() 和 predict() 接口,无需重新训练模型。文章以 IT 支持工单分类为例,演示少样本分类:仅需 3 至 5 个带标签示例即可引导模型准确分类新文本,效果优于零样本分类,尤其适合领域特定任务。
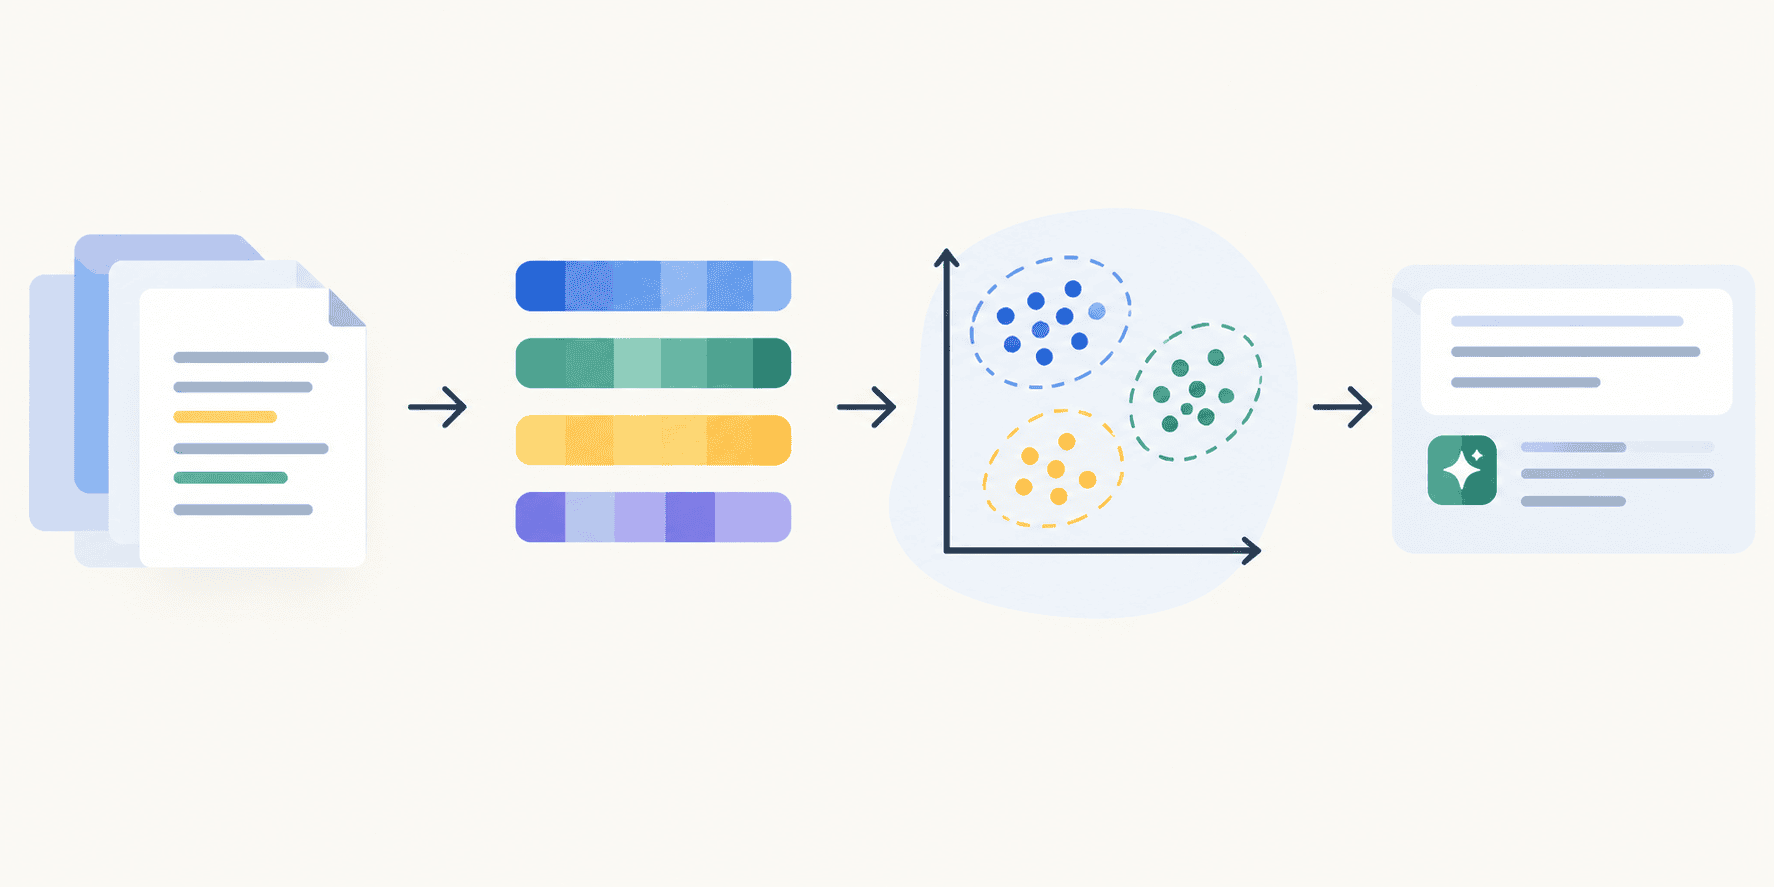
本文介绍用scikit-learn和开源模型搭建轻量级RAG流水线,无需付费API或重型框架。流程为:下载文档数据集并分块,用sentence-transformers生成嵌入,用NearestNeighbors以余弦距离构建检索器,再接入Qwen2.5-0.5B-Instruct生成答案,适合原型验证和低成本部署。
Scikit-LLM 将大语言模型封装为 scikit-learn 估计器,提供 fit 与 predict/transform 接口,可无缝接入 Pipeline 和交叉验证。常用 ZeroShotGPTClassifier 以标签作为任务说明;DynamicFewShotGPTClassifier 按样本检索最接近的示例。GPTVectorizer 可将文本转为固定向量,GPTTranslator 支持跨语言分类。需注意 API 调用带来的 token 成本会随交叉验证和网格搜索成倍增加。
早期scikit-learn常见错误是预处理在交叉验证前泄露验证集数据。将特征工程纳入Pipeline,各步骤仅用训练数据拟合,可避免泄露。常用组件有ColumnTransformer、make_column_selector、SimpleImputer、OneHotEncoder和TargetEncoder;set_output与get_feature_names_out便于查看结果,GridSearchCV可一并调优预处理参数。
本文介绍机器学习基础概念,通过Python和scikit-learn构建决策树模型,预测学生是否通过考试。文章涵盖数据集、特征、标签、训练与测试数据划分、模型训练与评估等核心步骤,并解释过拟合、欠拟合、分类与回归的区别,强调理解基本工作流程比记忆算法更重要。
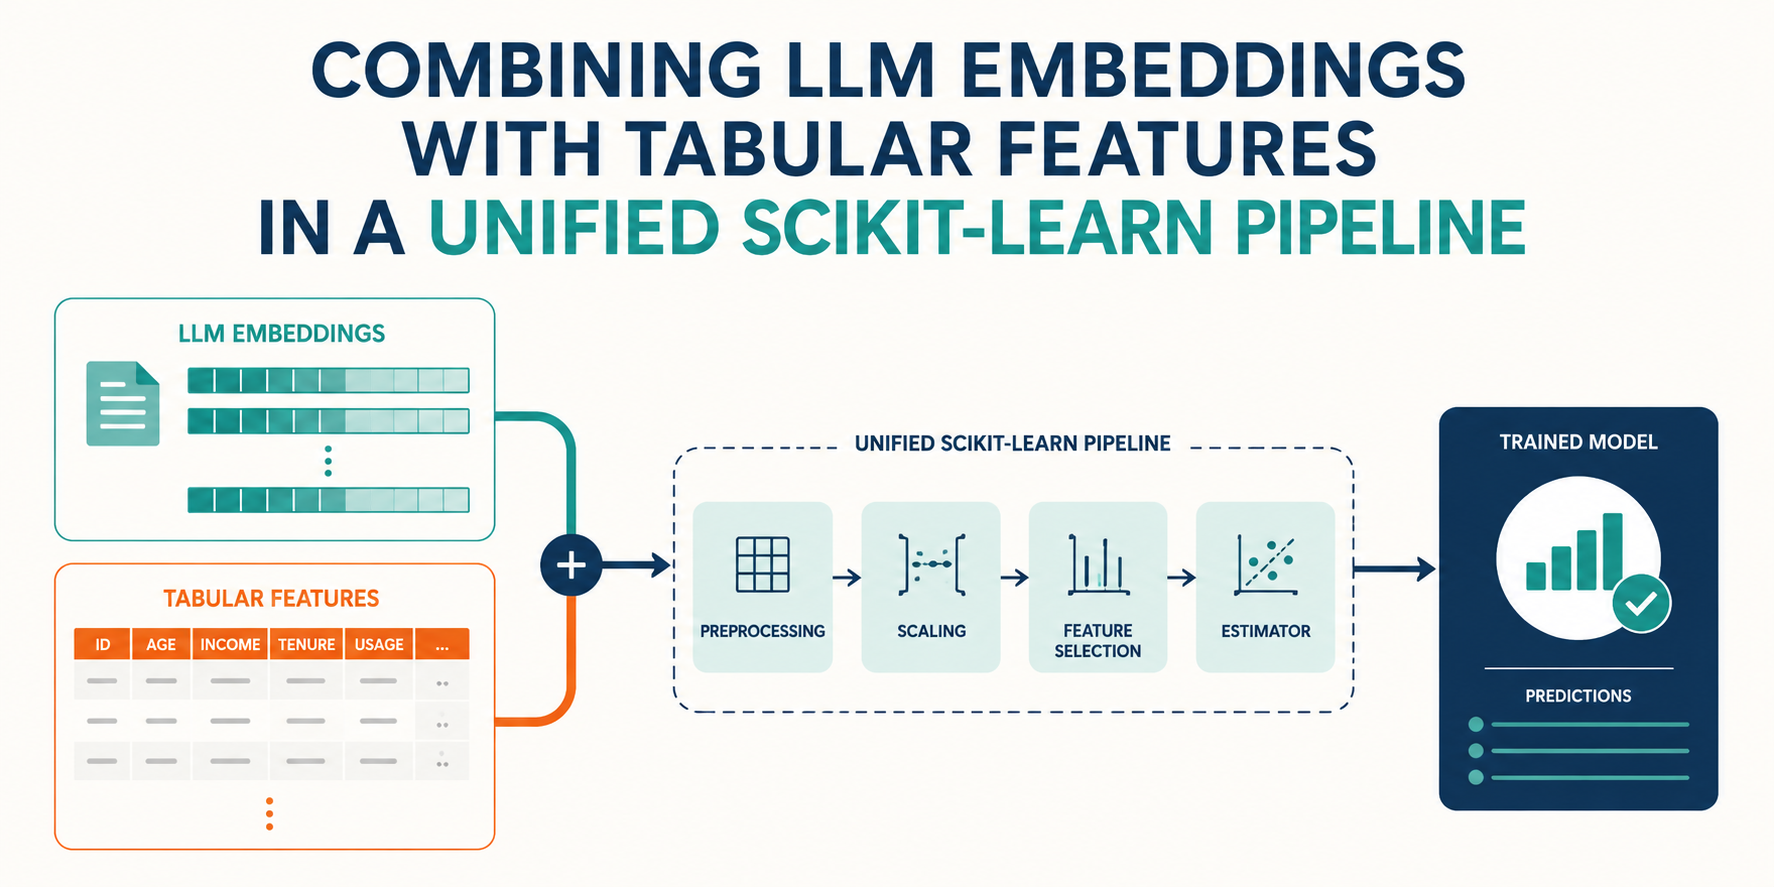
本文介绍如何构建统一的scikit-learn管道,结合轻量级开源语言模型生成的文本嵌入与表格特征进行分类。通过自定义Transformer封装Hugging Face的sentence-transformers,利用ColumnTransformer并行处理文本、数值和分类特征,最终用随机森林分类器评估。以垃圾短信检测为例,混合真实文本与合成表格数据,实现高精度分类,提供可复用的部署方案。
文章讨论了作者在使用Akismet反垃圾评论插件时遇到的授权问题,最终决定自建基于scikit-learn的垃圾评论检测系统。该系统利用开源数据和自有评论数据进行训练,适合小型WordPress站点,作者分享了项目的配置和使用方法。
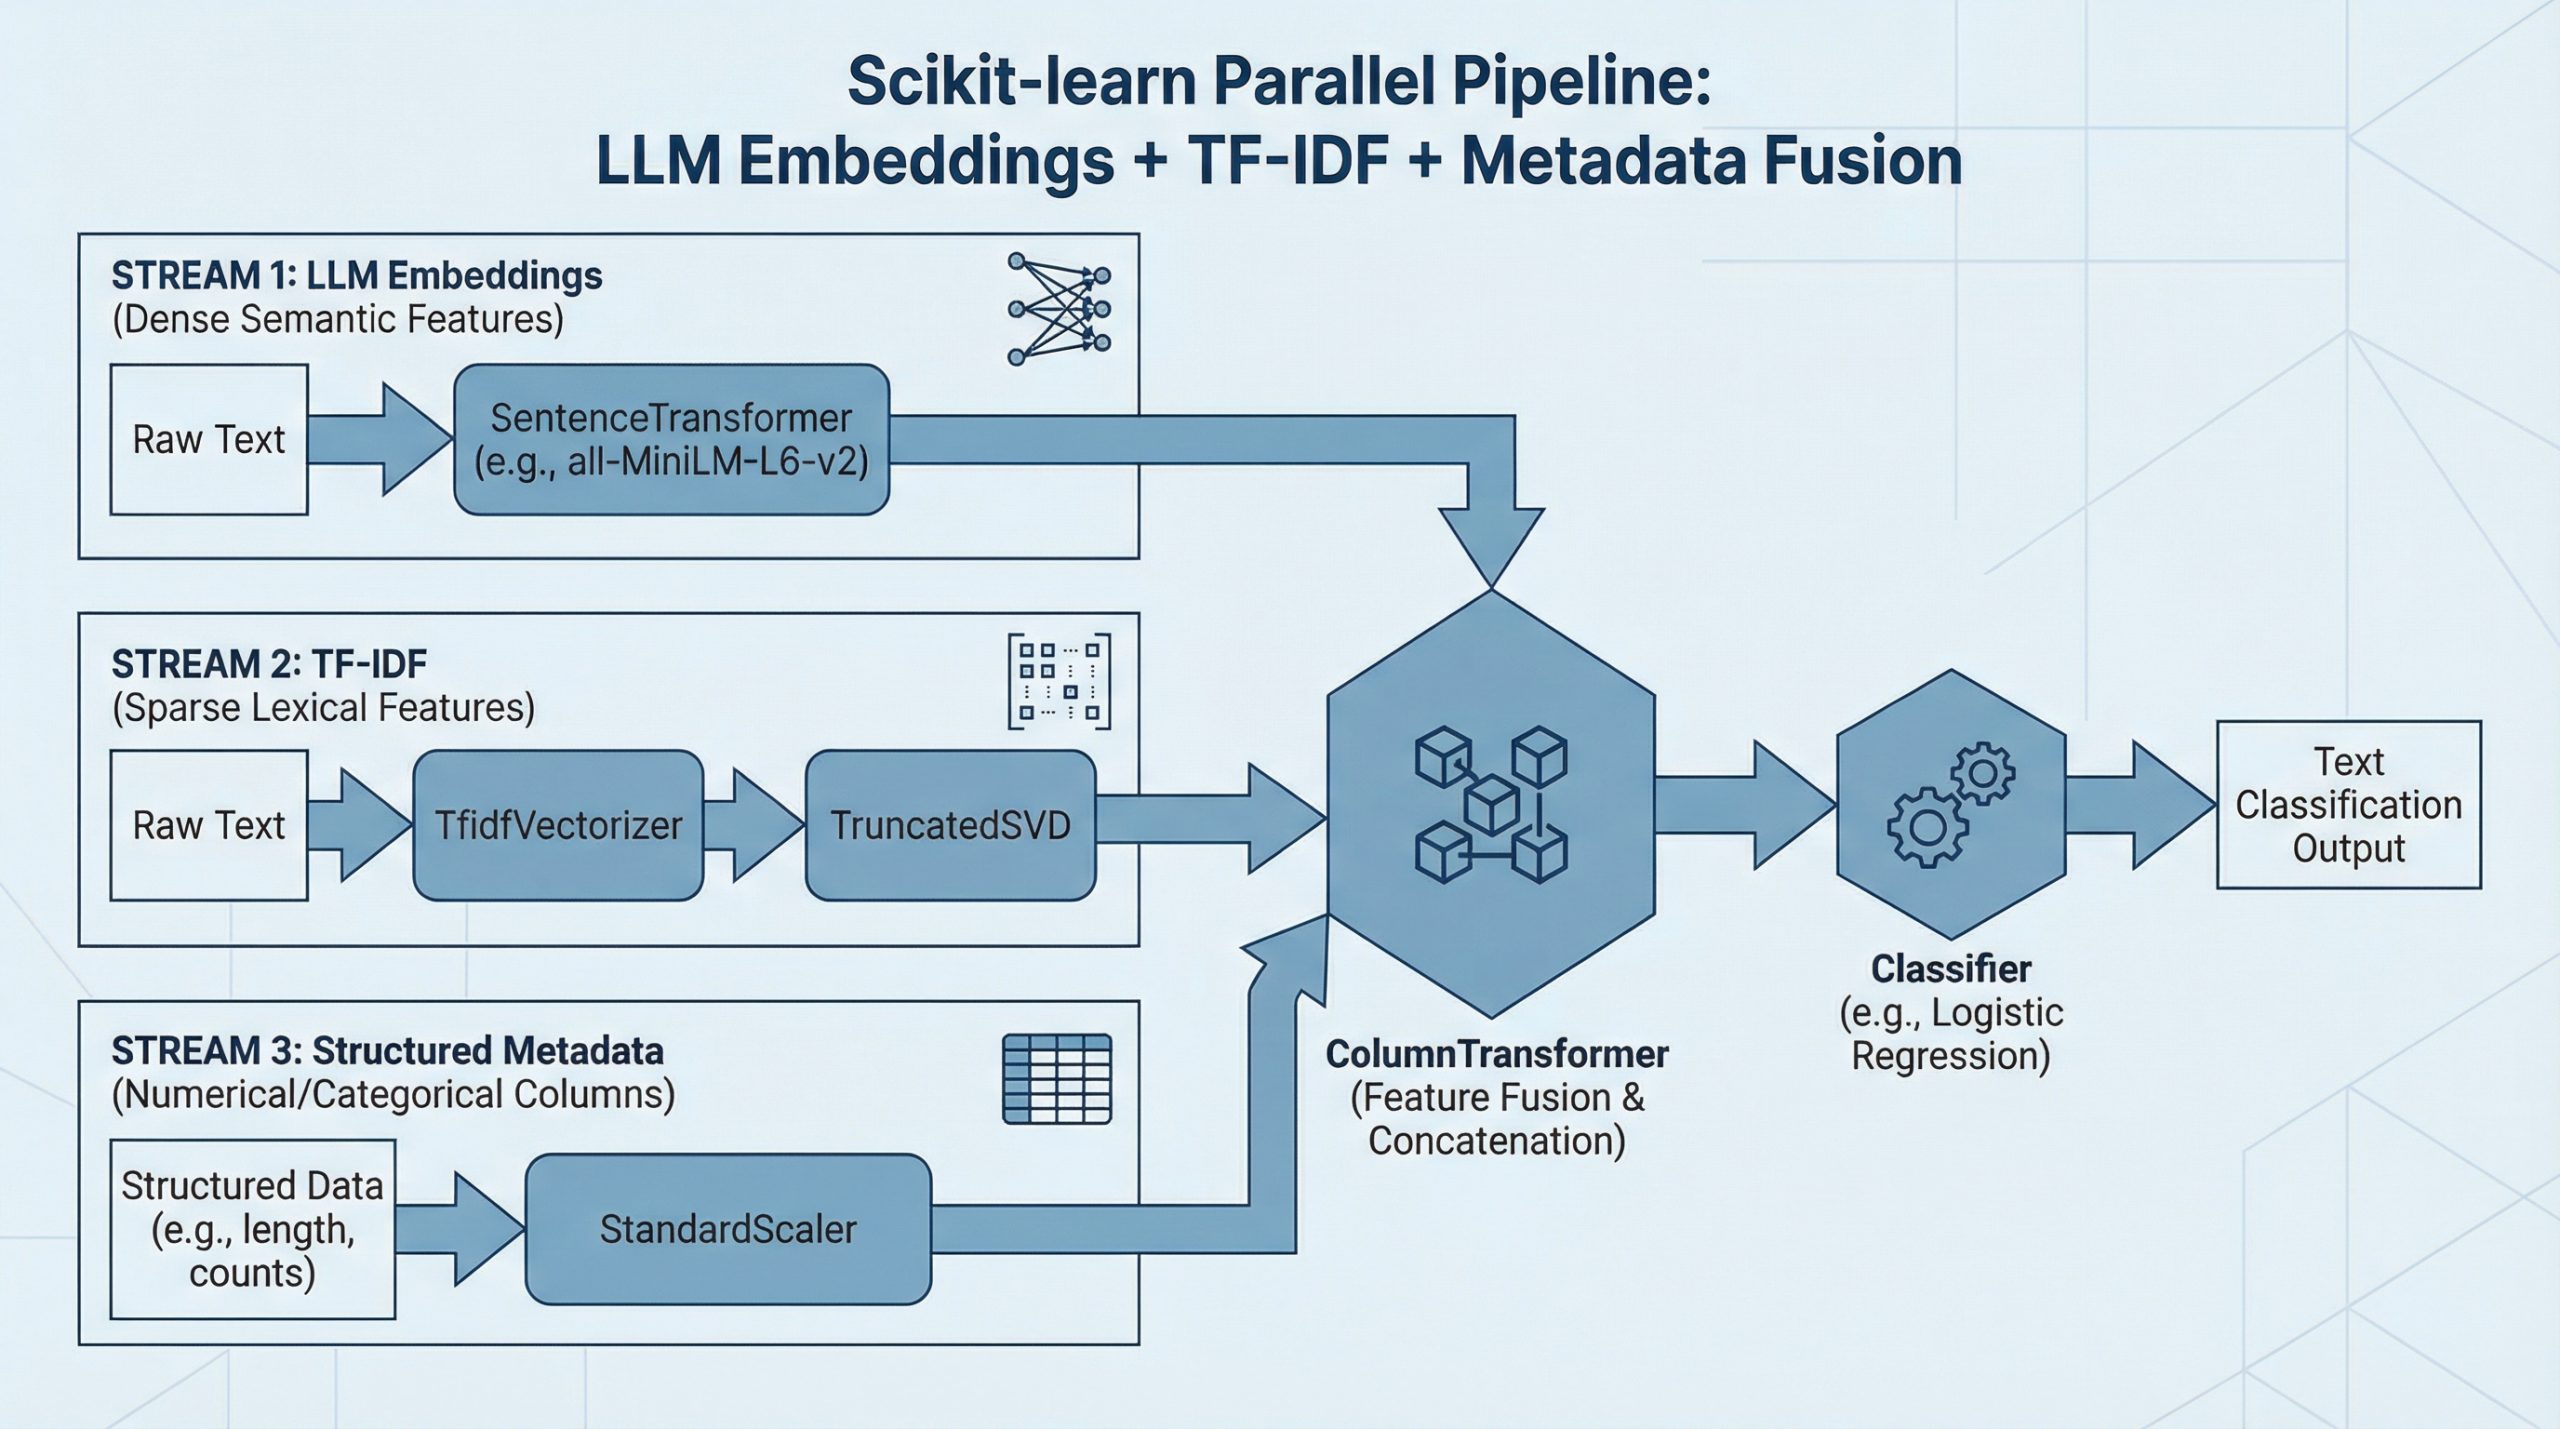
本文介绍了如何在scikit-learn管道中结合LLM嵌入、TF-IDF特征和结构化元数据进行文本分类。主要步骤包括加载数据集、构建特征管道、融合特征以及训练分类器,以实现高效的文本分类模型。
本文介绍了如何在有限硬件条件下使用Dask进行可扩展的数据处理。Dask与Python框架无缝集成,适合处理大数据集。通过示例,展示了数据的加载、清理和准备过程,并结合scikit-learn进行机器学习建模,以优化内存使用和加速处理流程。
本文介绍了cuML,一个用于GPU加速机器学习的开源库,提供与scikit-learn相似的API,支持多种算法如回归和分类,显著提高训练速度。通过对成人收入数据集的比较,cuML在分类准确率和训练时间上均优于传统的scikit-learn。
本文介绍了如何将Pandas、NumPy和scikit-learn结合,构建机器学习工作流。通过混凝土抗压强度数据集,展示了数据加载、处理、建模和评估的过程。Pandas用于数据处理,NumPy进行数值计算,scikit-learn用于模型构建和评估。整合这三者可以提高机器学习的效率和准确性,特别是通过特征工程提升模型性能。
创建文件夹结构并从Kaggle下载Iris数据集。编写Dockerfile以构建使用Python 3.9及其依赖项的Docker镜像,安装pandas、matplotlib和scikit-learn。使用COPY和CMD命令启动容器,最后通过'docker build -t username/filename:latest .'构建镜像。
Scikit-Learn是Python的主要机器学习库,提供分类、回归和聚类等工具,适合初学者和开发者。它开源、易用,支持数据预处理和模型选择,广泛应用于各行业。
人工智能(AI)和机器学习(ML)正在革新软件开发与决策。AI是机器智能的广泛概念,ML是其子集,通过数据进行学习。Python是主要编程语言,常用库有scikit-learn和TensorFlow。开发者可通过小项目和Kaggle竞赛入门,AI/ML已向大众开放,任何人均可参与。
本文介绍如何将 scikit-learn 训练的鸢尾花分类模型转换为 ONNX 格式,并利用 onnxruntime 开发交互式推理应用,最后使用 Nuitka 将应用打包成独立的 EXE 文件,实现跨平台部署。
本研究比较了GPU加速库(cuML)与传统CPU实现(scikit-learn)在物联网车辆入侵检测中的性能。结果表明,GPU加速显著提升了计算效率,训练时间缩短至最多159倍,预测速度提高至最多95倍,同时保持了检测准确性。
机器学习是现代技术的基础,Python因其简洁和丰富的库而成为首选语言。Scikit-Learn是一个强大且易用的Python库,适合构建机器学习模型。本文介绍了Scikit-Learn的基本概念、环境设置、数据处理、模型构建与评估,旨在帮助初学者快速入门。
本文介绍了六个不太为人知的Scikit-Learn特性,能够有效节省时间。包括验证曲线(评估模型在不同超参数下的表现)、模型校准(确保预测概率的可靠性)、置换重要性(评估特征对模型性能的贡献)、特征哈希(减少高维特征的内存占用)、鲁棒缩放(处理异常值影响)和特征联合(同时应用多个特征转换)。
本文介绍了10个Python一行代码示例,帮助用户在Scikit-Learn中高效处理机器学习任务,包括导入模块、加载数据集、数据分割、特征标准化、降维、训练SVM分类器、生成混淆矩阵、交叉验证、打印分类报告及创建数据处理和模型管道。这些代码片段旨在简化实验和提高代码清晰度。
本文介绍了如何使用Python的Scikit-Learn库训练KNN(K-最近邻)算法进行天气预测,利用澳大利亚气象数据集分类明天是否会下雨。强调了数据预处理的重要性,包括缺失值处理和特征标准化,并评估了模型的准确性、精确度和召回率,指出结果的实际意义。
完成下面两步后,将自动完成登录并继续当前操作。