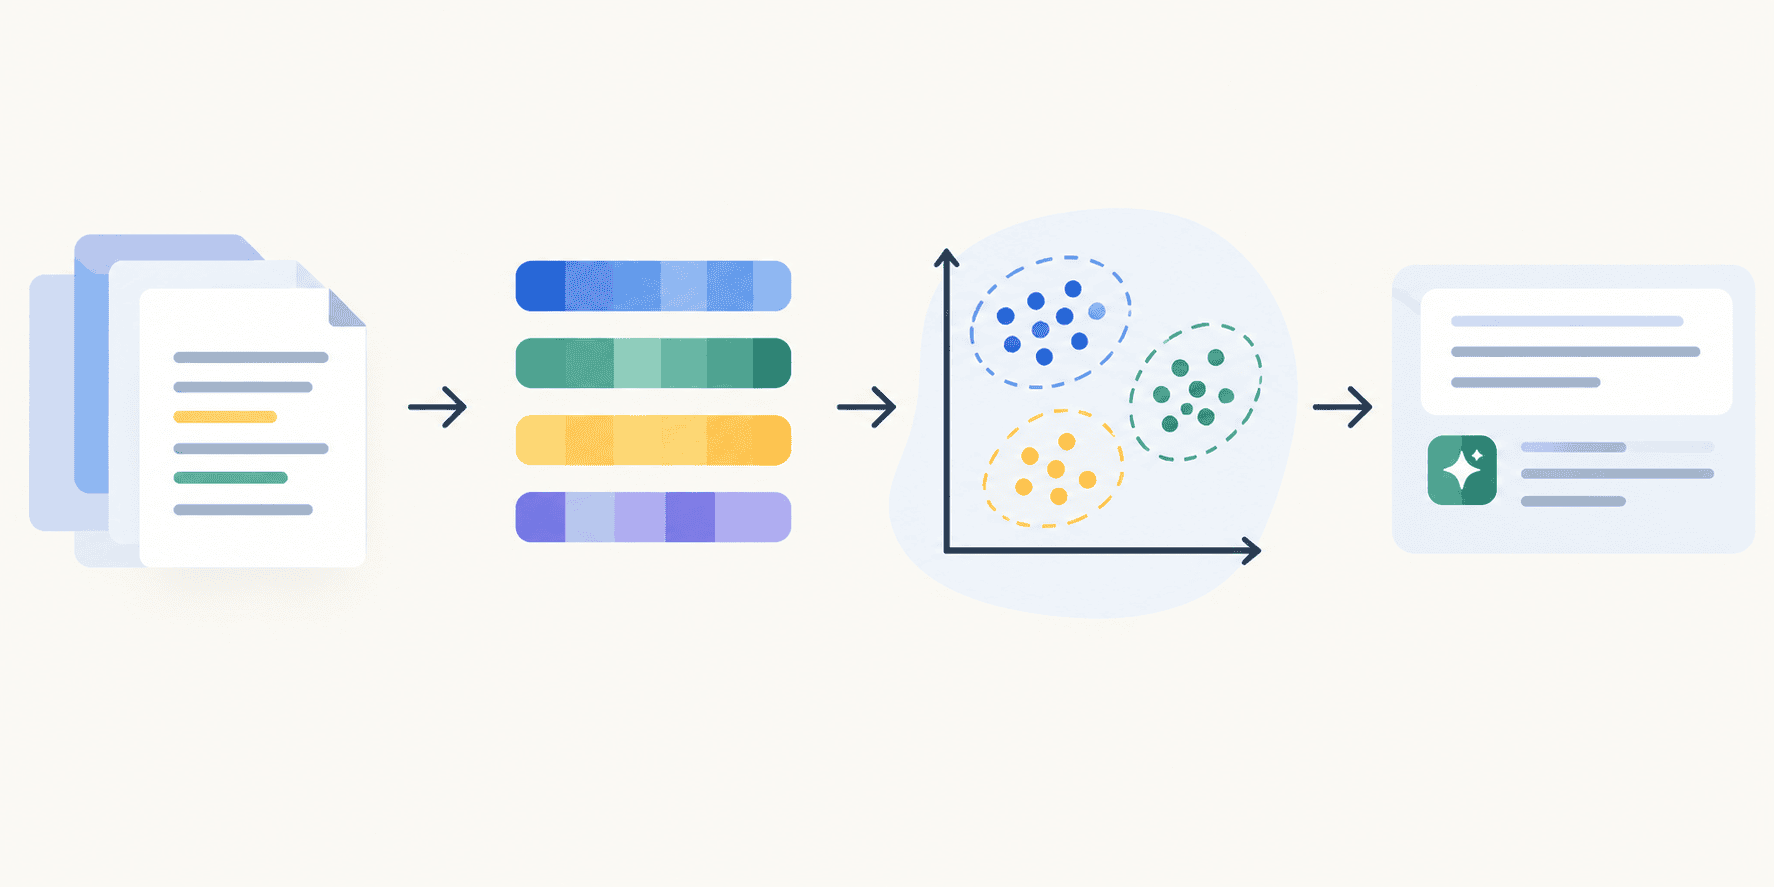
本文介绍用scikit-learn和开源模型搭建轻量级RAG流水线,无需付费API或重型框架。流程为:下载文档数据集并分块,用sentence-transformers生成嵌入,用NearestNeighbors以余弦距离构建检索器,再接入Qwen2.5-0.5B-Instruct生成答案,适合原型验证和低成本部署。
本周Python动态:K-Dense-AI可将AI代理升级为AI科学家,提供165项科学技能,覆盖生物、化学、医学等领域;Sentence Transformers 6.0新增多向量编码器,支持ColBERT式检索模型训练;另有文章讲解LLM的KV、前缀、提示与语义缓存,以及NumPy内部实现、Django自定义迁移操作等。
本文介绍了1bit量化embedding模型,强调其在相似度计算中的优势,具有32倍的压缩率和25倍的检索速度,同时保持95%的检索准确率。此外,提到Sentence Transformers库支持超过1万个embedding模型。
完成下面两步后,将自动完成登录并继续当前操作。