


使用LLM嵌入和Scikit-learn构建RAG流水线
内容提要
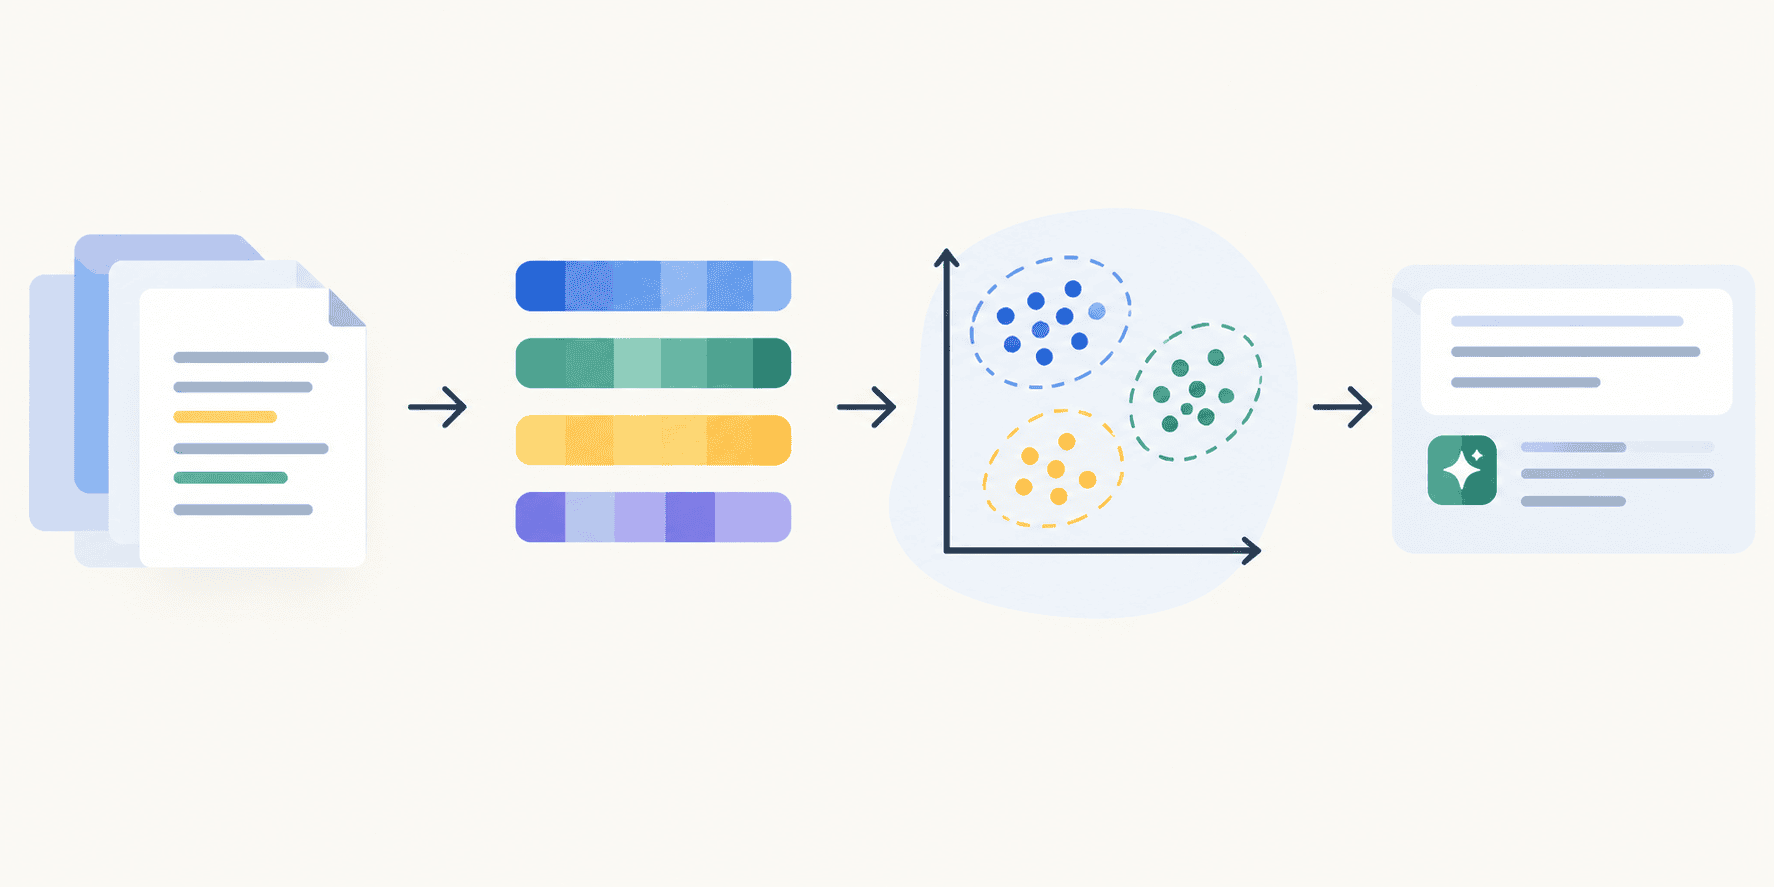
本文介绍用scikit-learn和开源模型搭建轻量级RAG流水线,无需付费API或重型框架。流程为:下载文档数据集并分块,用sentence-transformers生成嵌入,用NearestNeighbors以余弦距离构建检索器,再接入Qwen2.5-0.5B-Instruct生成答案,适合原型验证和低成本部署。
延伸解读
轻量级RAG的适用边界
文章明确该方案适合小到中等规模语料、原型验证或成本受限环境。它用scikit-learn的NearestNeighbors模拟向量数据库,避免付费API和重型框架,但作者也提醒不要期待商业LLM级效果。因此,若文档量巨大或需高并发生产部署,仍需评估专用向量数据库和更大模型。
分块策略的演示意义
示例中chunk_size=25、overlap=5远小于实际常用值,目的是在9篇短文档上观察分块效果。作者指出真实应用应使用更大参数。这提示读者:分块大小和重叠需根据文档长度与语义密度调整,过小会割裂上下文,过大则降低检索精度。
检索与生成组件的选型逻辑
检索器用余弦距离,因为嵌入向量通过角度衡量语义相似;生成器选Qwen2.5-0.5B-Instruct,因其小到能在Colab免费GPU运行而不爆内存。这种组合牺牲了生成质量,换取了透明、快速和零成本,适合验证检索策略而非追求最终答案质量。
提示词约束与答案可靠性
生成函数在系统提示中要求模型仅依据提供的上下文回答,若找不到则明确说无法找到。这降低了幻觉风险,但受限于小模型和少量检索片段,答案仍可能不完整。读者可借鉴此约束设计,同时注意检索结果的质量直接决定生成上限。
Q&A
如何用scikit-learn和开源模型搭建一个轻量级RAG流水线?
首先下载文档数据集并分块,然后用sentence-transformers生成嵌入,接着用scikit-learn的NearestNeighbors以余弦距离构建检索器,最后接入Qwen2.5-0.5B-Instruct生成答案。整个过程无需付费API或重型框架。
在RAG中,为什么使用余弦距离作为相似度度量?
因为LLM嵌入向量之间的语义相似度是基于向量之间的夹角来衡量的,余弦距离能有效捕捉这种角度关系,适合用于嵌入向量的检索。
构建RAG时,文档分块有什么最佳实践?
通常将文档分成较小的语义片段,以便嵌入模型更有效地处理。分块时需设置块大小和重叠量,实际应用中应使用比示例更大的值。
Qwen2.5-0.5B-Instruct模型在RAG中如何生成答案?
该模型通过text-generation管道加载,接收包含检索上下文和用户问题的提示,使用聊天模板格式化,并设置max_new_tokens=150、do_sample=False、temperature=0.1来生成答案,且仅基于提供的上下文回答。
这种轻量级RAG方案适合哪些应用场景?
适合小到中型语料库、原型验证、概念验证以及成本受限的部署环境,能提供透明、快速且完全可用的RAG流水线。
这个RAG流水线有哪些局限性?
由于使用小模型和微型知识库,输出结果可能无法达到商业LLM的水平,更适合作为起点进行原型设计和实验,而非直接用于生产环境。
