文章介绍如何用Scikit-LLM结合大语言模型实现命名实体识别(NER):以Groq免费API为例,配置自定义实体字典(如高管、公司、产品、城市),用GPTExplainableNER从科技商业文本中提取结构化实体,并用正则表达式清理输出。结果表明,无需从零训练模型,仅少量配置即可获得不错效果。
Scikit-LLM 是一个 Python 库,将预训练大语言模型封装为 scikit-learn 风格的 fit() 和 predict() 接口,无需重新训练模型。文章以 IT 支持工单分类为例,演示少样本分类:仅需 3 至 5 个带标签示例即可引导模型准确分类新文本,效果优于零样本分类,尤其适合领域特定任务。
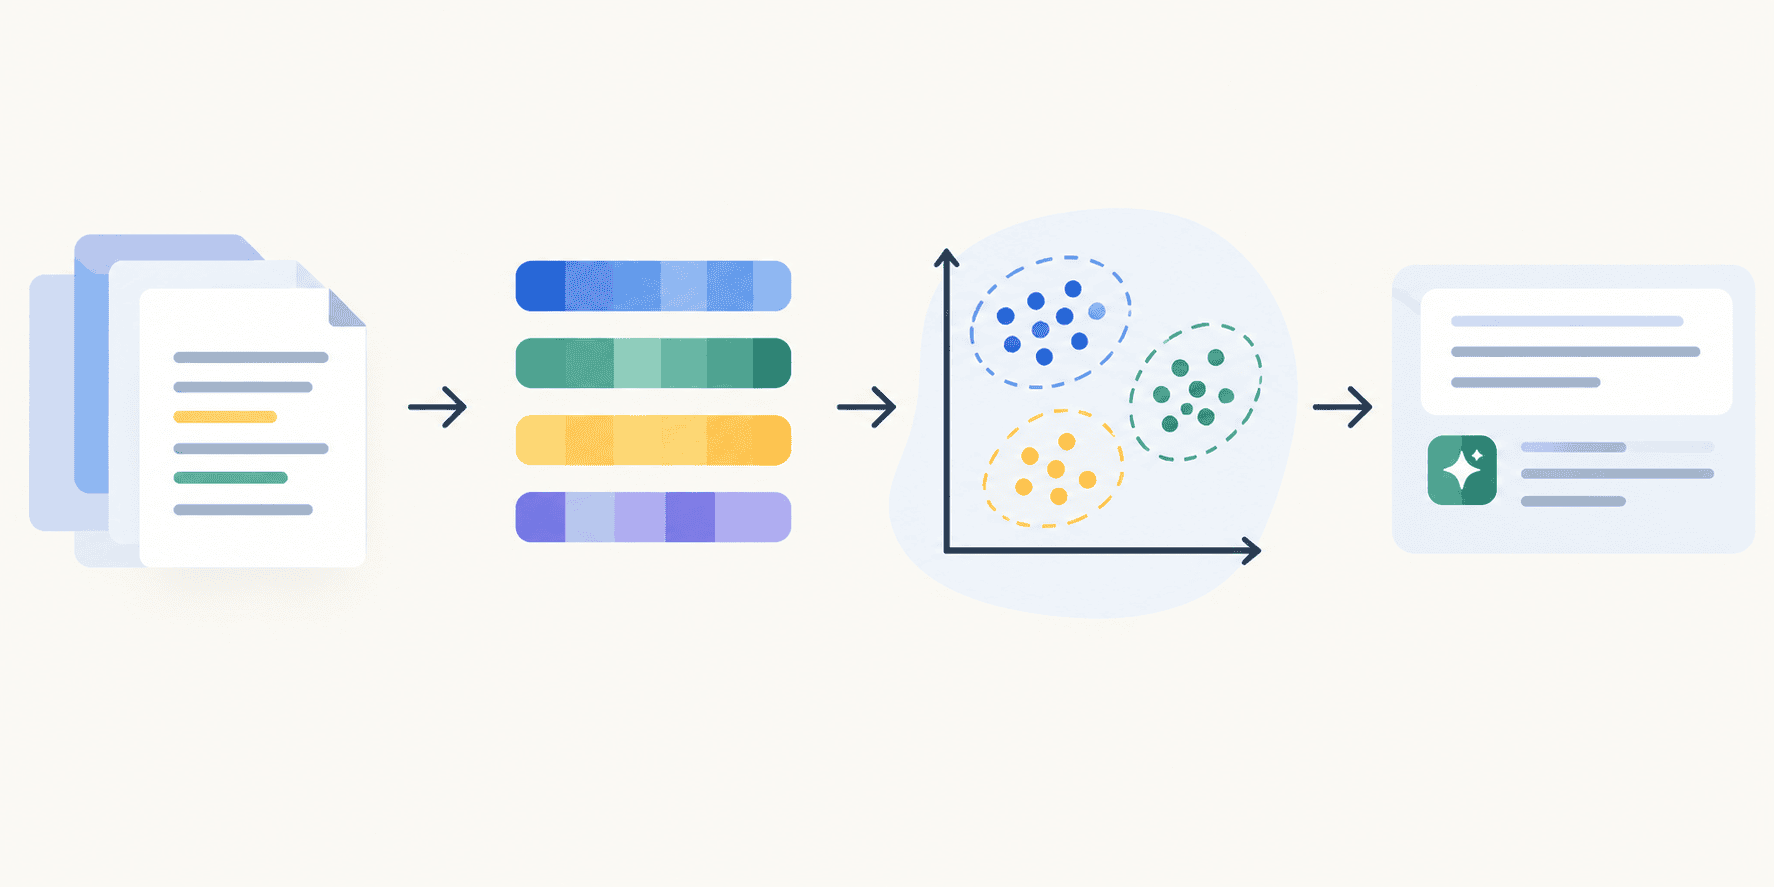
本文介绍用scikit-learn和开源模型搭建轻量级RAG流水线,无需付费API或重型框架。流程为:下载文档数据集并分块,用sentence-transformers生成嵌入,用NearestNeighbors以余弦距离构建检索器,再接入Qwen2.5-0.5B-Instruct生成答案,适合原型验证和低成本部署。
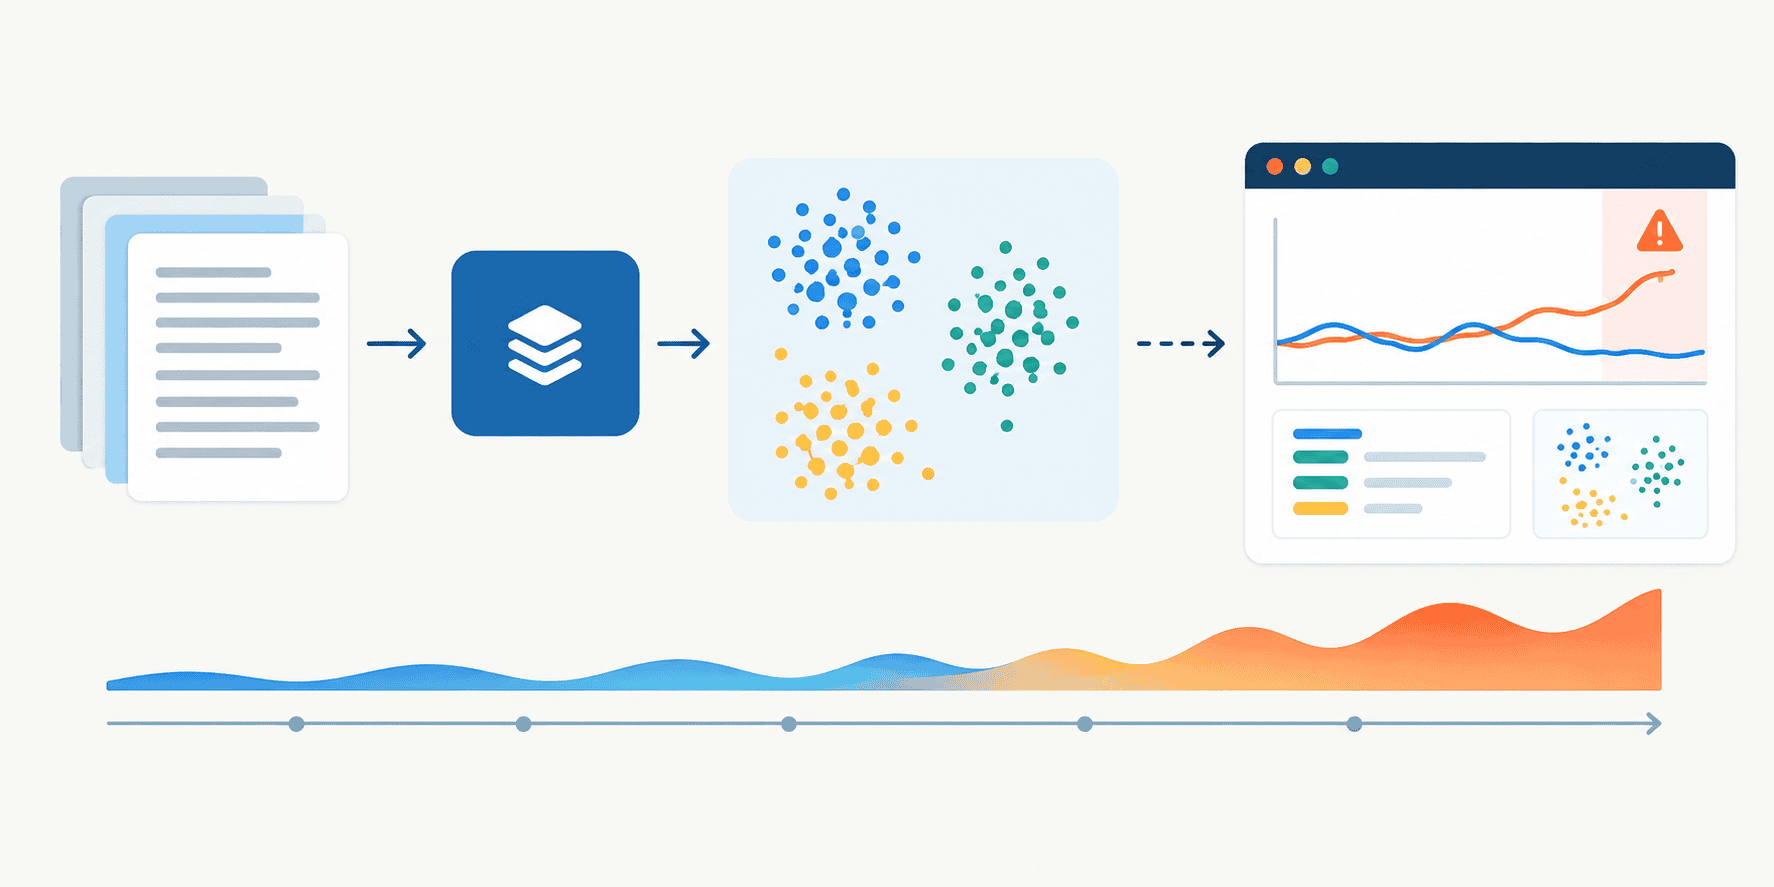
本文介绍生产环境中LLM嵌入漂移的检测方法,重点讲解两种技术:基于模型的检测(训练随机森林分类器区分基线与生产嵌入,ROC-AUC超阈值即告警)和质心距离法(计算两组嵌入质心的余弦距离)。文中用模拟384维嵌入及Scikit-LLM结合SentenceTransformer生成的真实文本嵌入演示,均成功检测到漂移。
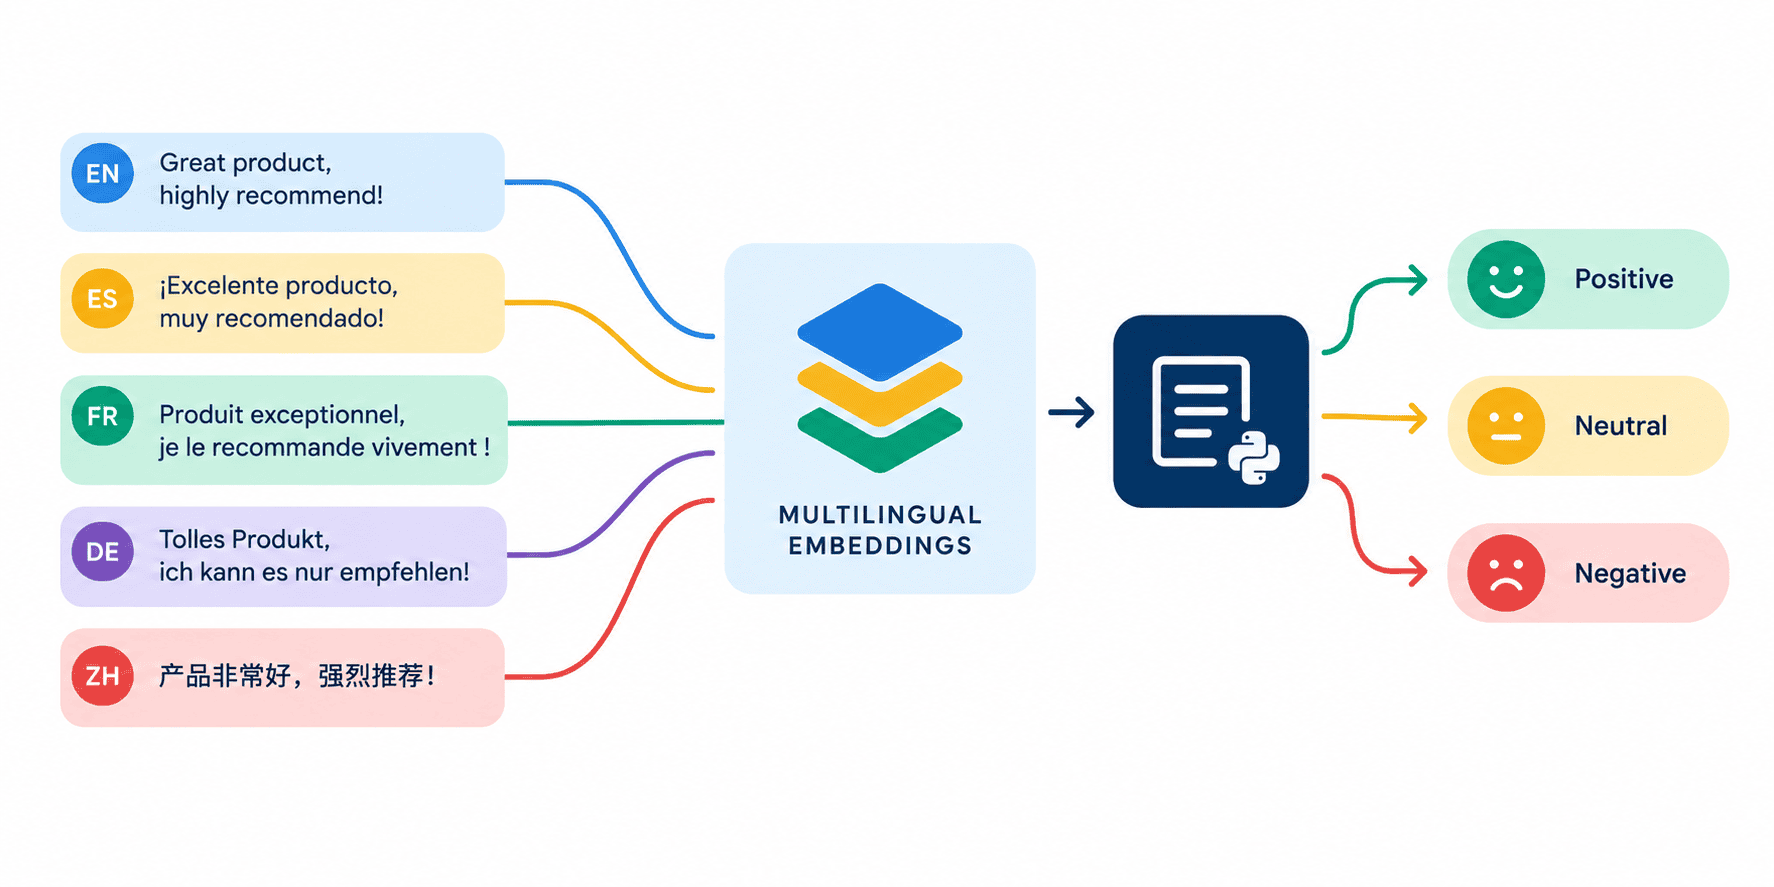
本文介绍使用Scikit-LLM与多语言嵌入构建多语言文本分类流程:通过Ollama本地运行BGE-M3模型,将英西双语评论映射到统一向量空间,再训练逻辑回归分类器,无需为每种语言单独建模。在2000条亚马逊评论上准确率约57%,极端评分预测较好,中等评分较难区分。
Scikit-LLM 将大语言模型封装为 scikit-learn 估计器,提供 fit 与 predict/transform 接口,可无缝接入 Pipeline 和交叉验证。常用 ZeroShotGPTClassifier 以标签作为任务说明;DynamicFewShotGPTClassifier 按样本检索最接近的示例。GPTVectorizer 可将文本转为固定向量,GPTTranslator 支持跨语言分类。需注意 API 调用带来的 token 成本会随交叉验证和网格搜索成倍增加。
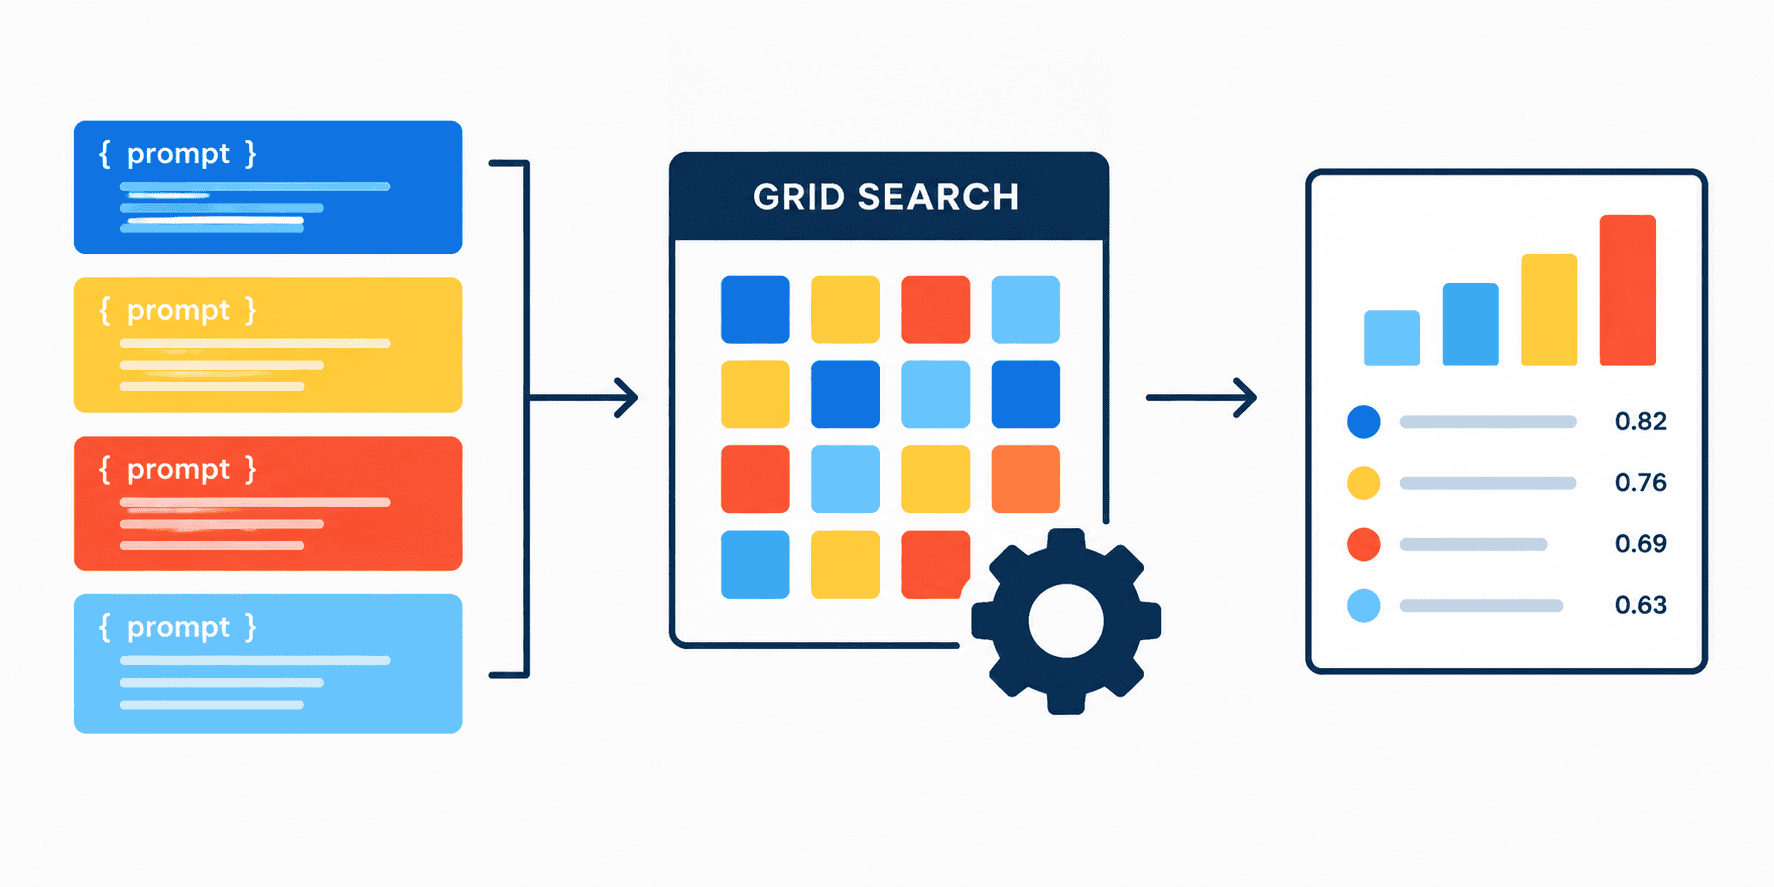
本文介绍将提示模板作为可调超参数,通过scikit-learn的GridSearchCV为语言模型寻找最佳提示。作者把模型封装成兼容scikit-learn的零样本分类器,定义候选提示网格,在小型情感数据集上交叉验证网格搜索,选出准确率最高的提示模板。
早期scikit-learn常见错误是预处理在交叉验证前泄露验证集数据。将特征工程纳入Pipeline,各步骤仅用训练数据拟合,可避免泄露。常用组件有ColumnTransformer、make_column_selector、SimpleImputer、OneHotEncoder和TargetEncoder;set_output与get_feature_names_out便于查看结果,GridSearchCV可一并调优预处理参数。
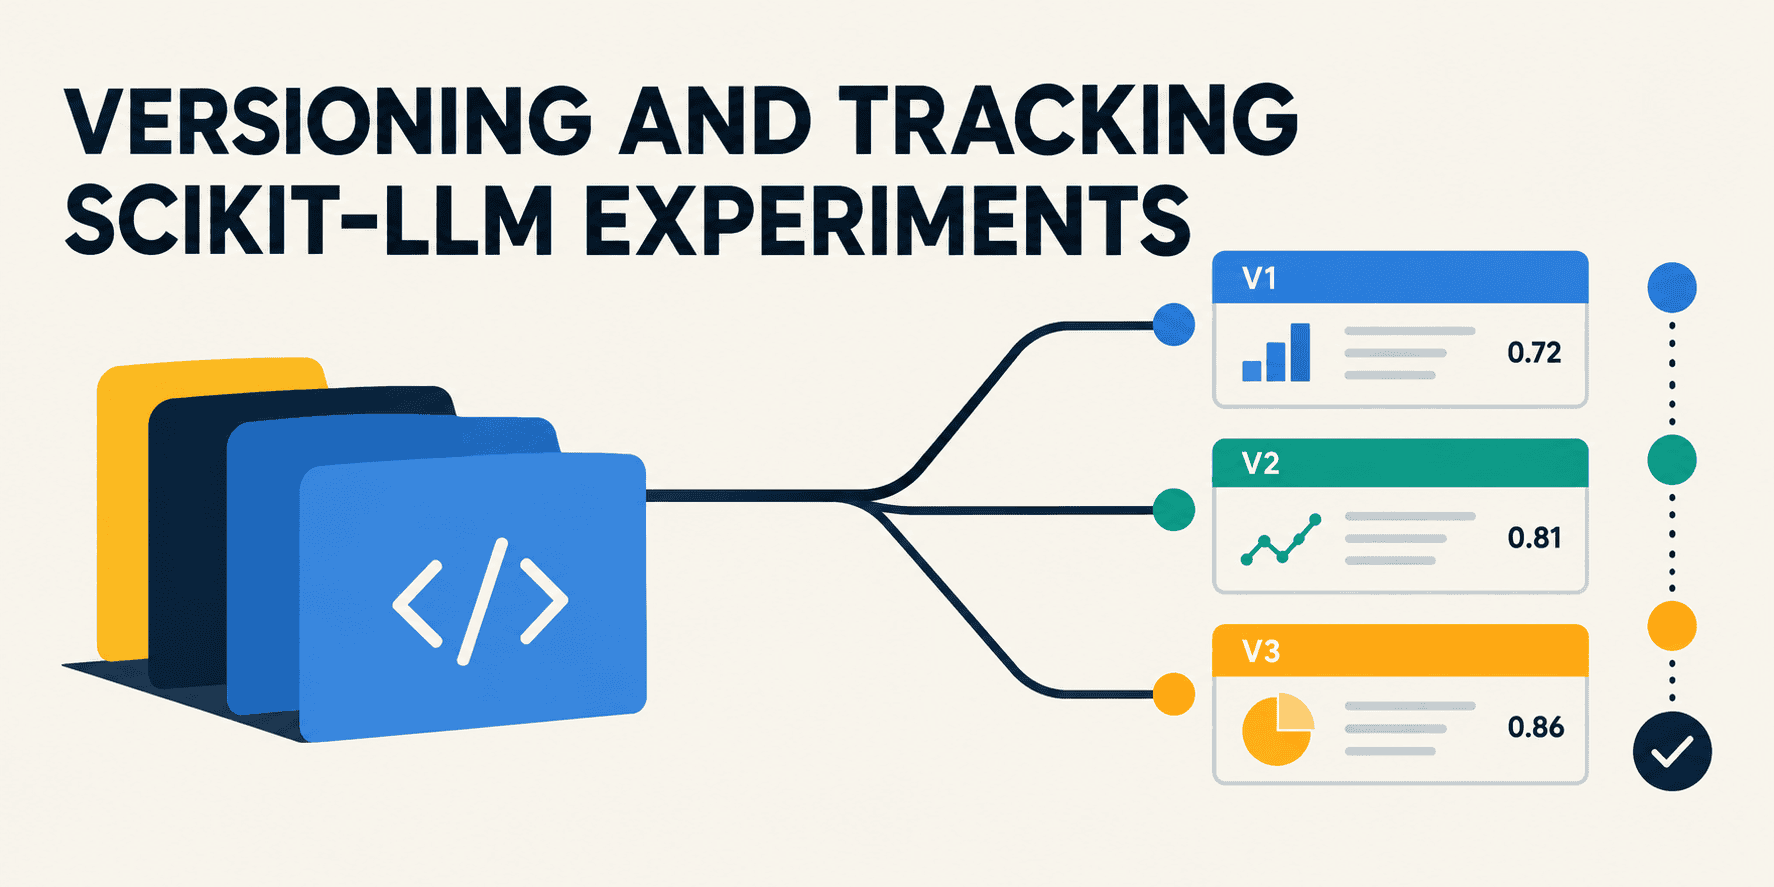
本文介绍如何使用Scikit-LLM与MLflow构建、跟踪、比较和注册集成大语言模型的scikit-learn管道。通过配置本地gpt4all模型执行和MLflow跟踪,记录基线及升级版管道版本,利用搜索API审计运行状态,并基于性能指标选择最佳模型注册至Model Registry,确保版本可复现和部署管理。
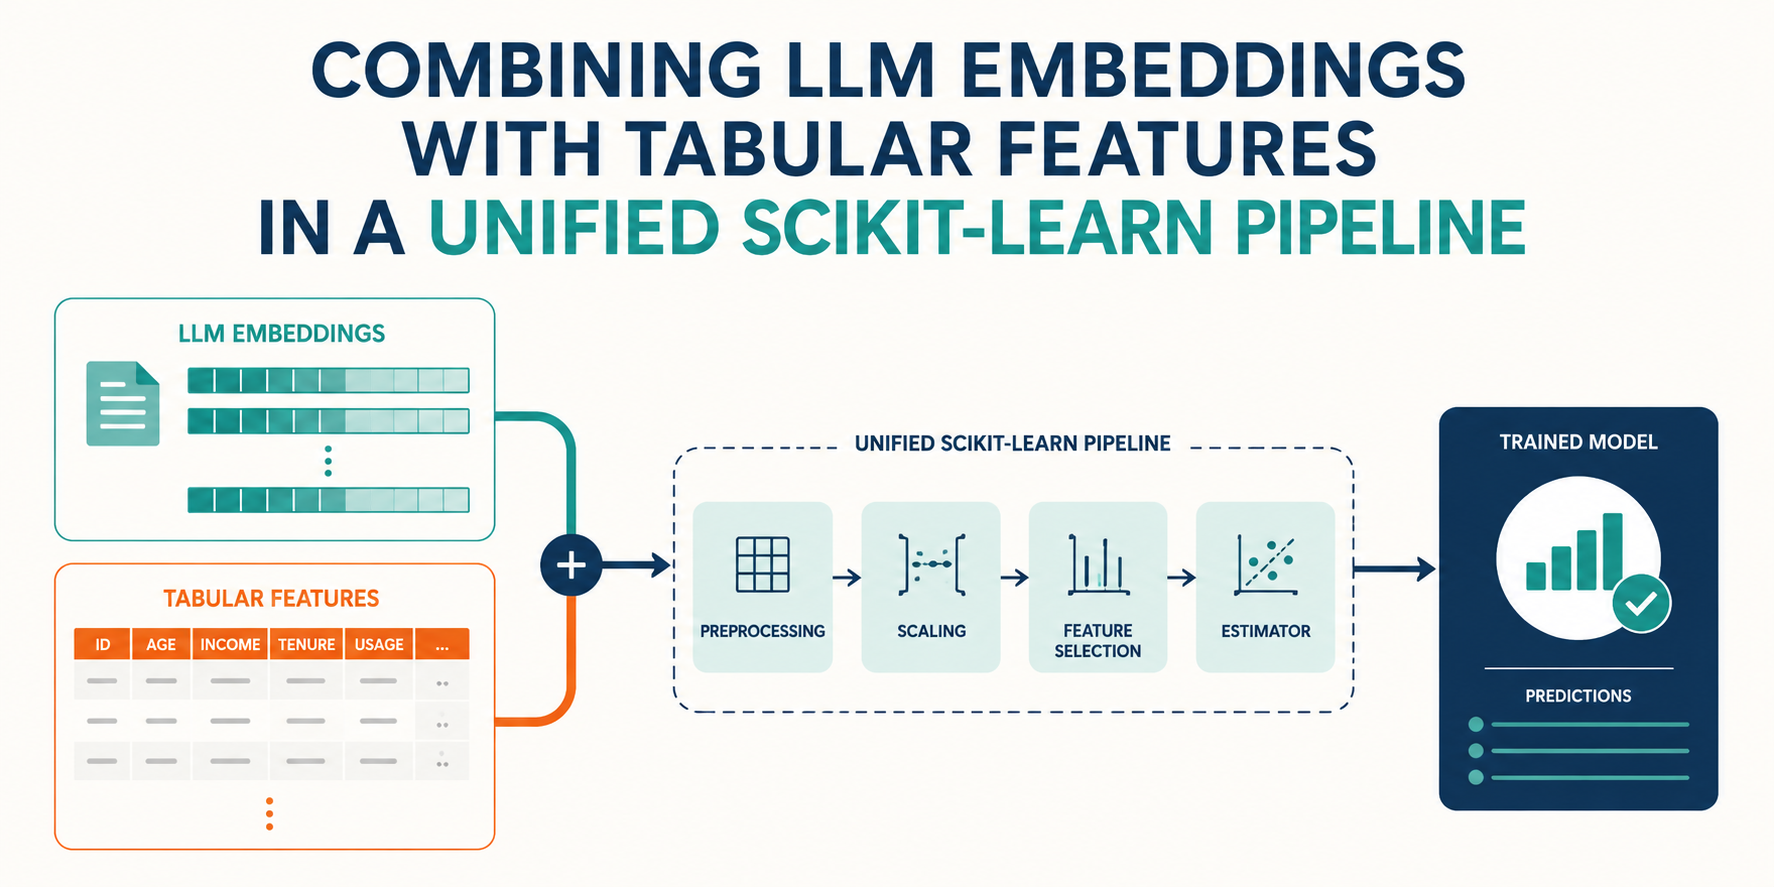
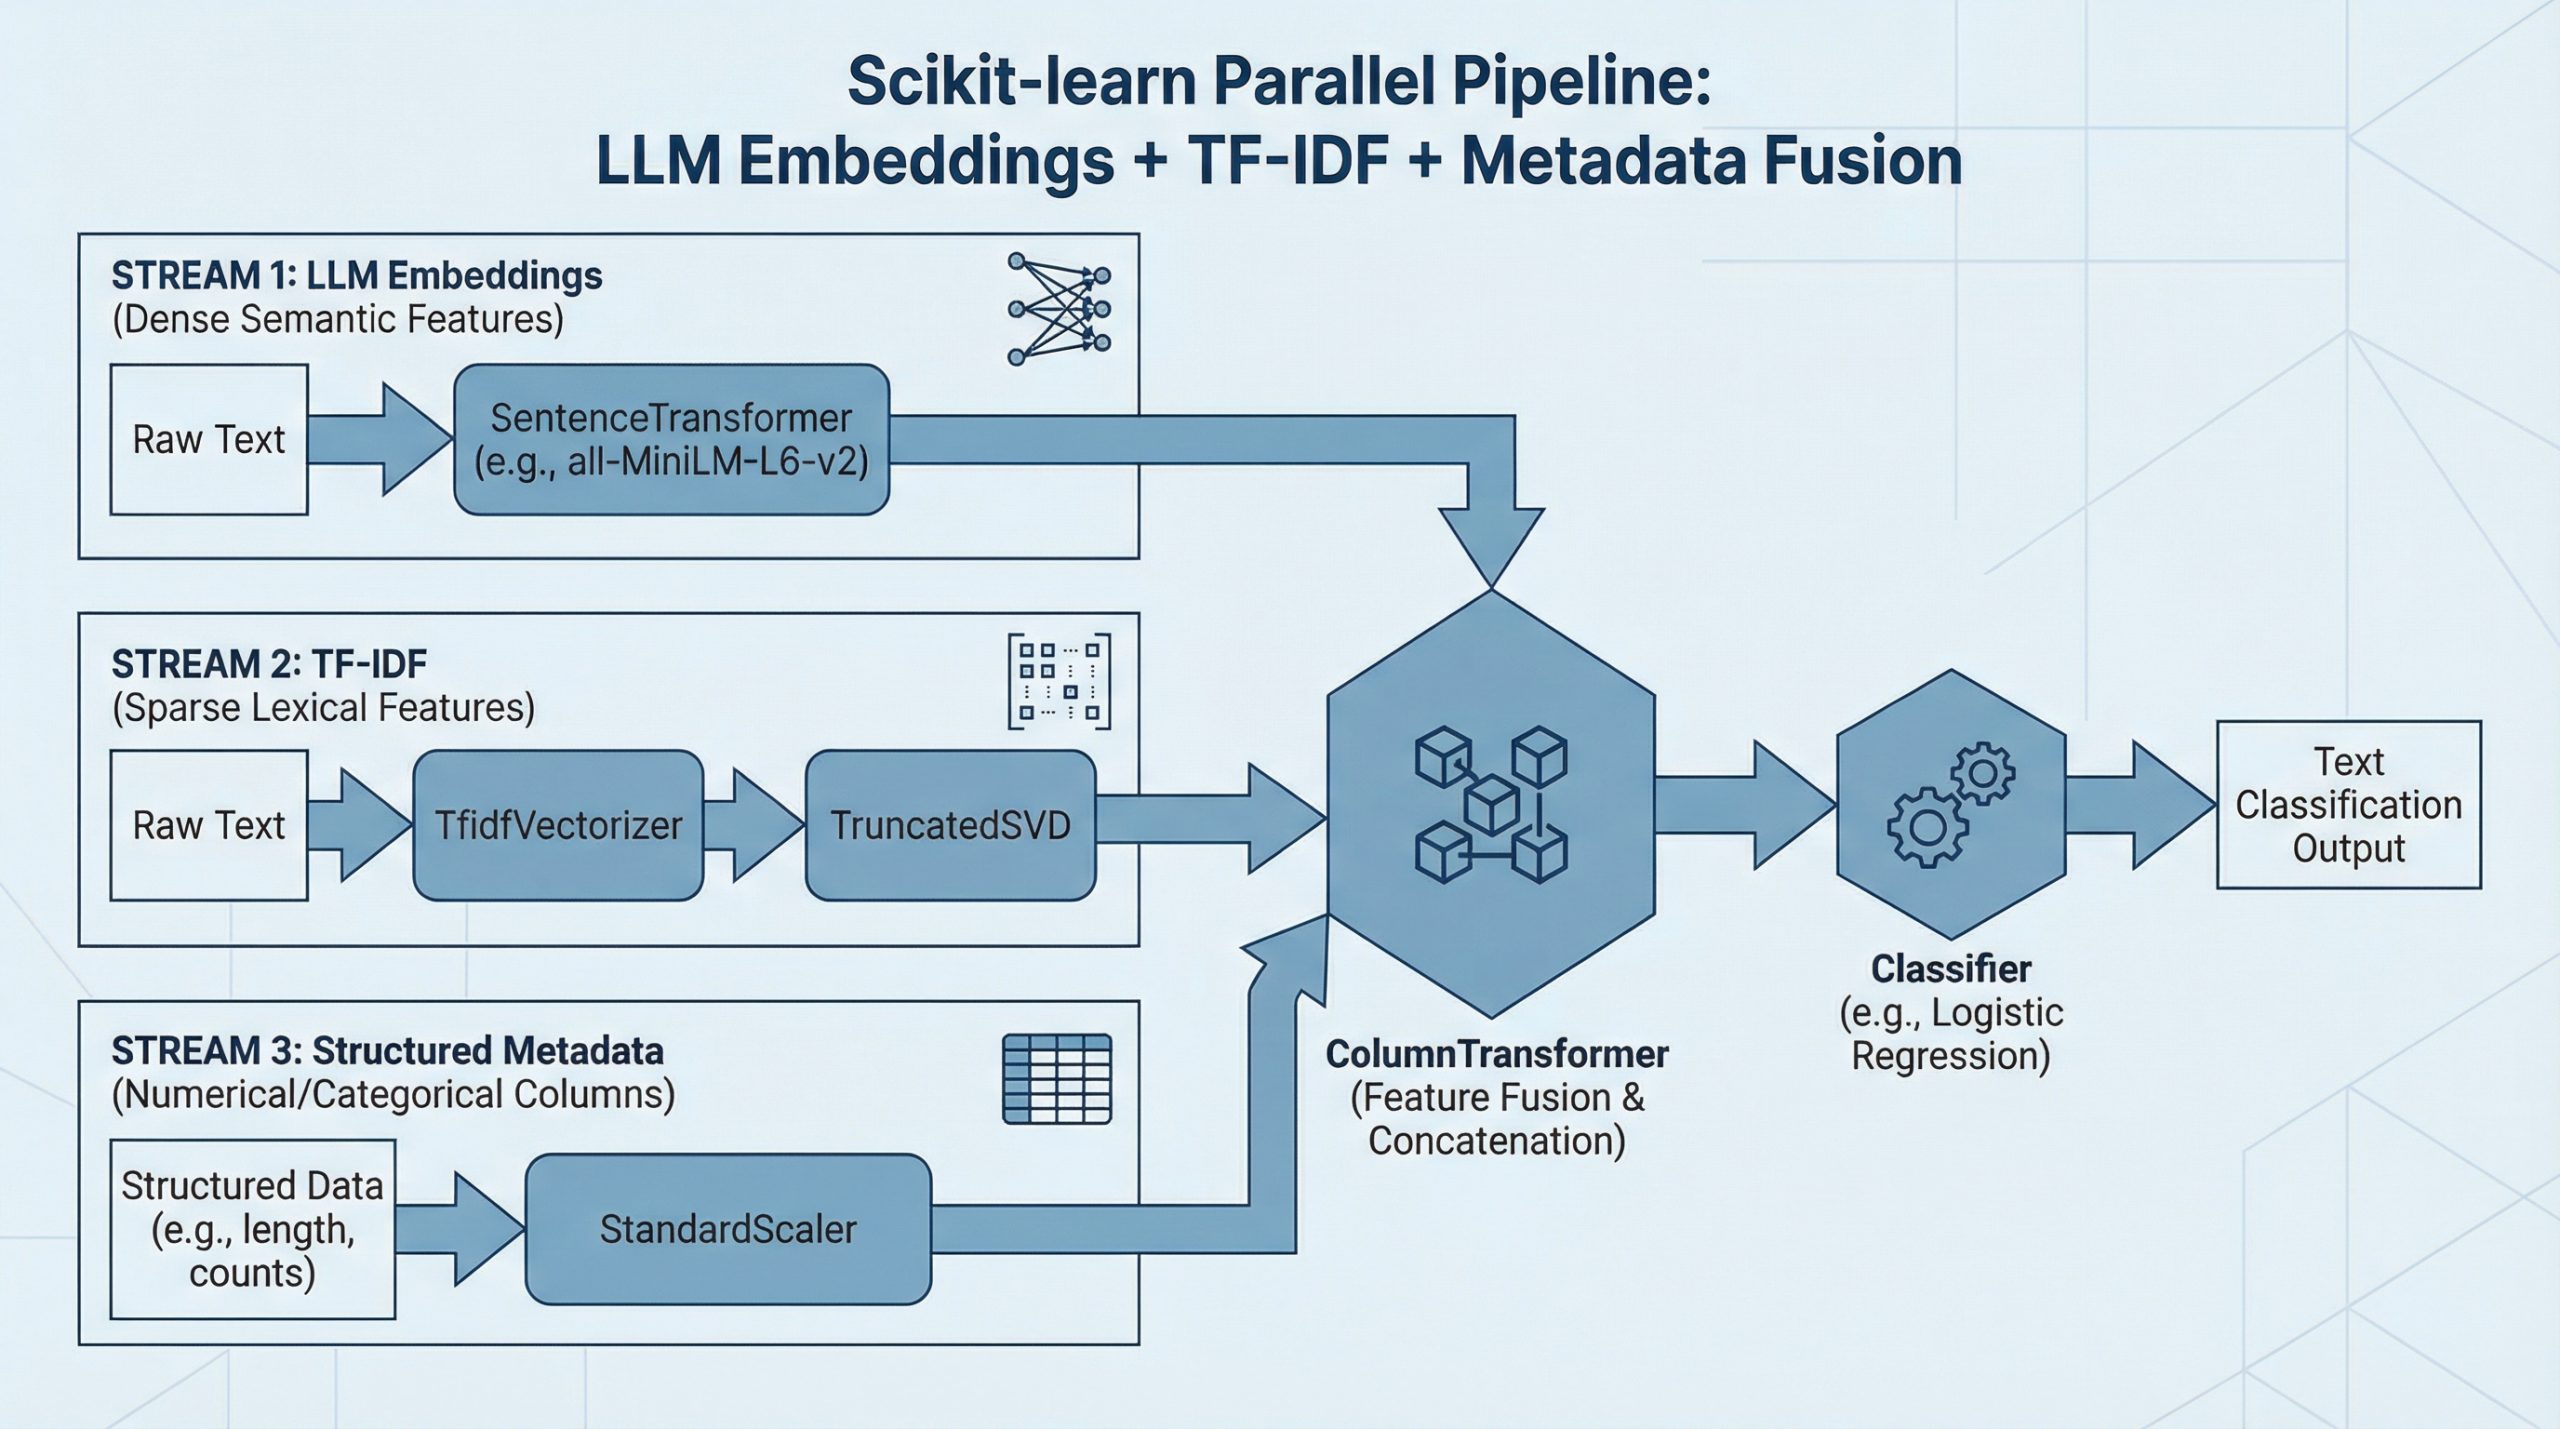
本文介绍如何构建统一的scikit-learn管道,结合轻量级开源语言模型生成的文本嵌入与表格特征进行分类。通过自定义Transformer封装Hugging Face的sentence-transformers,利用ColumnTransformer并行处理文本、数值和分类特征,最终用随机森林分类器评估。以垃圾短信检测为例,混合真实文本与合成表格数据,实现高精度分类,提供可复用的部署方案。
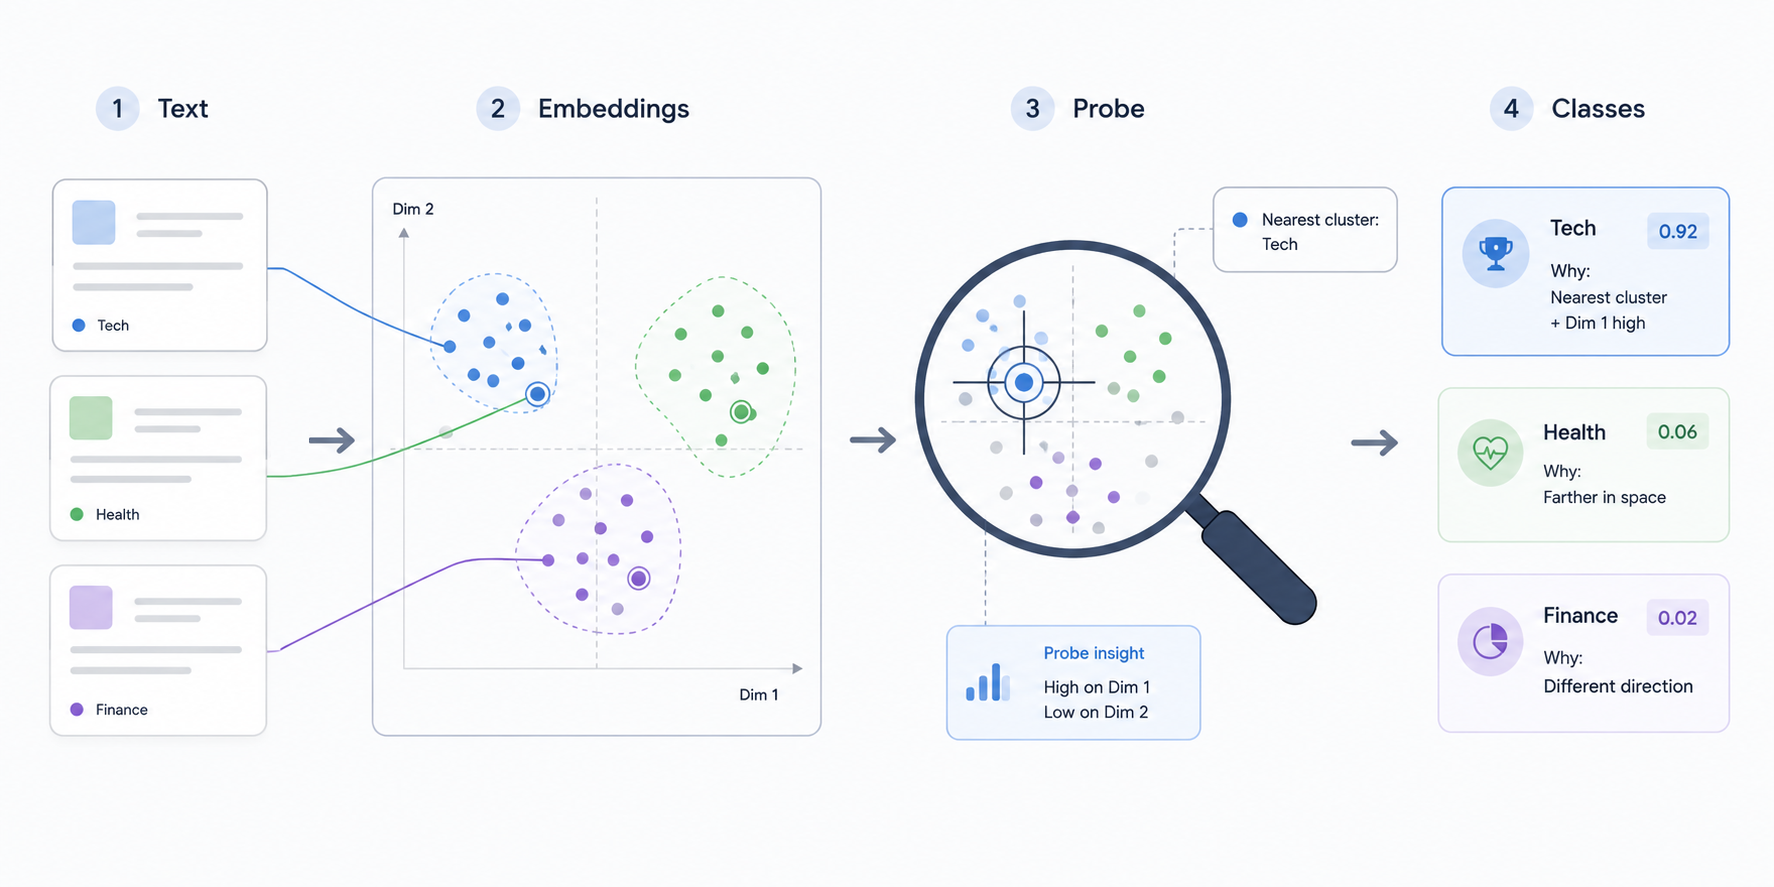
本文介绍如何利用Scikit-LLM和本地Ollama模型生成电影评论嵌入,训练逻辑回归分类器评估质量,并通过UMAP降维可视化语义结构,最后使用SHAP值识别关键嵌入维度,以提升LLM文本分类的可解释性。
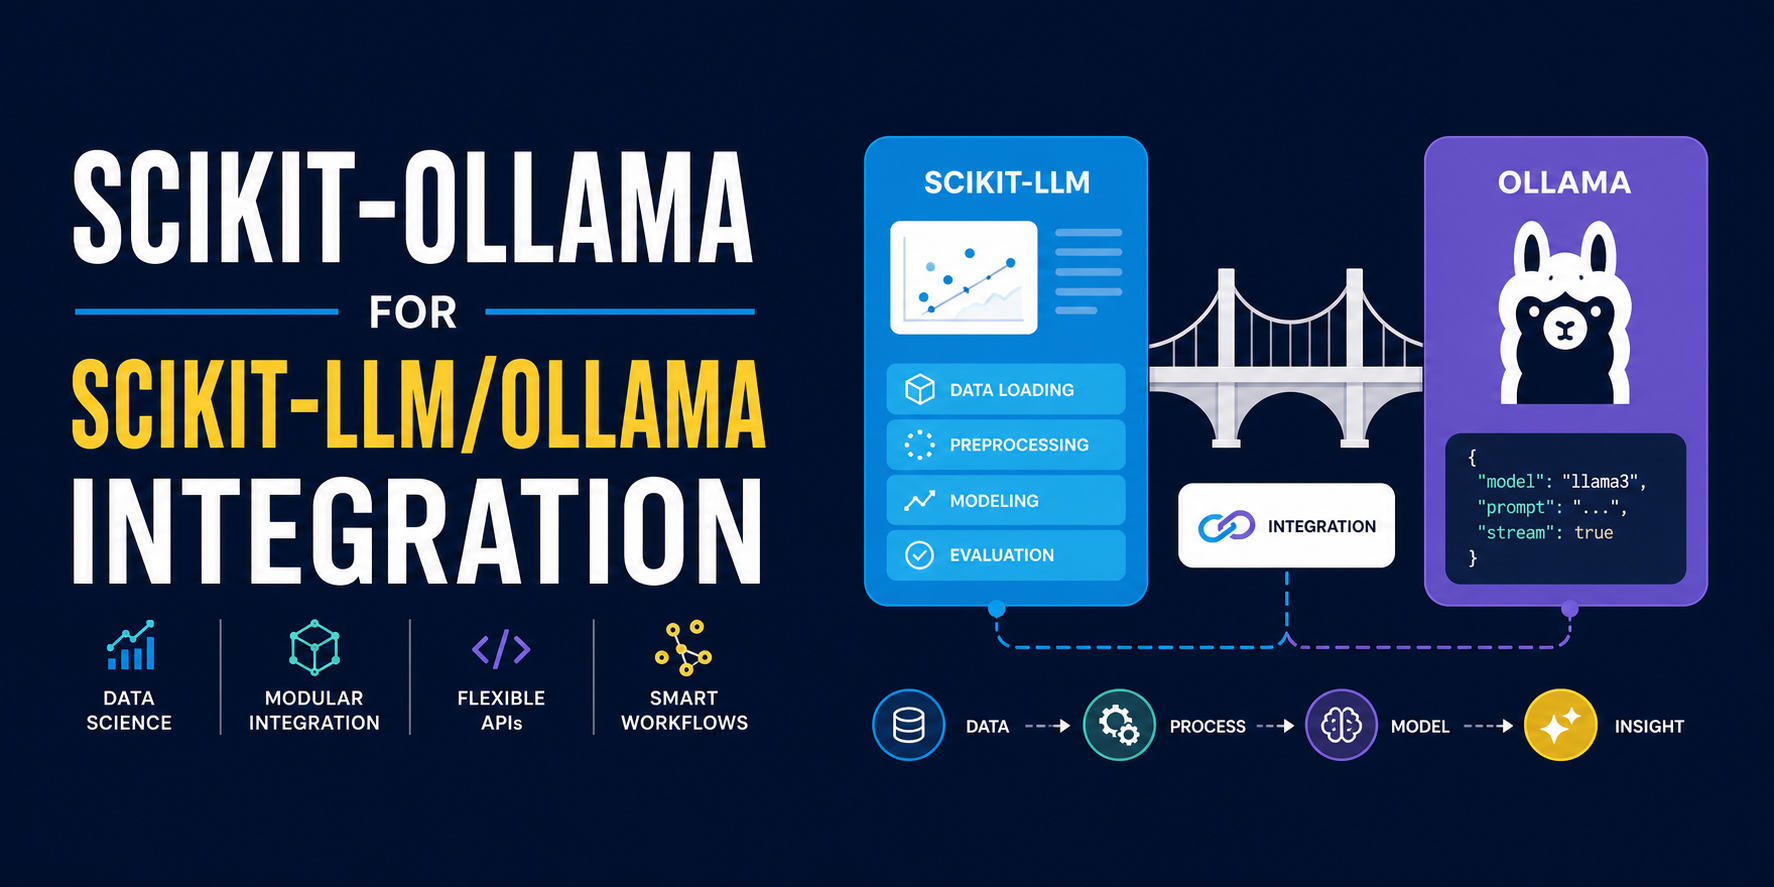
本文介绍了scikit-ollama如何将scikit-learn接口与本地Ollama模型结合,实现零-shot文本分类,无需云API。用户可以使用本地Llama 3模型加载电影评论情感数据集,并创建情感预测分类器,从而简化传统机器学习流程,避免数据隐私问题和订阅费用。
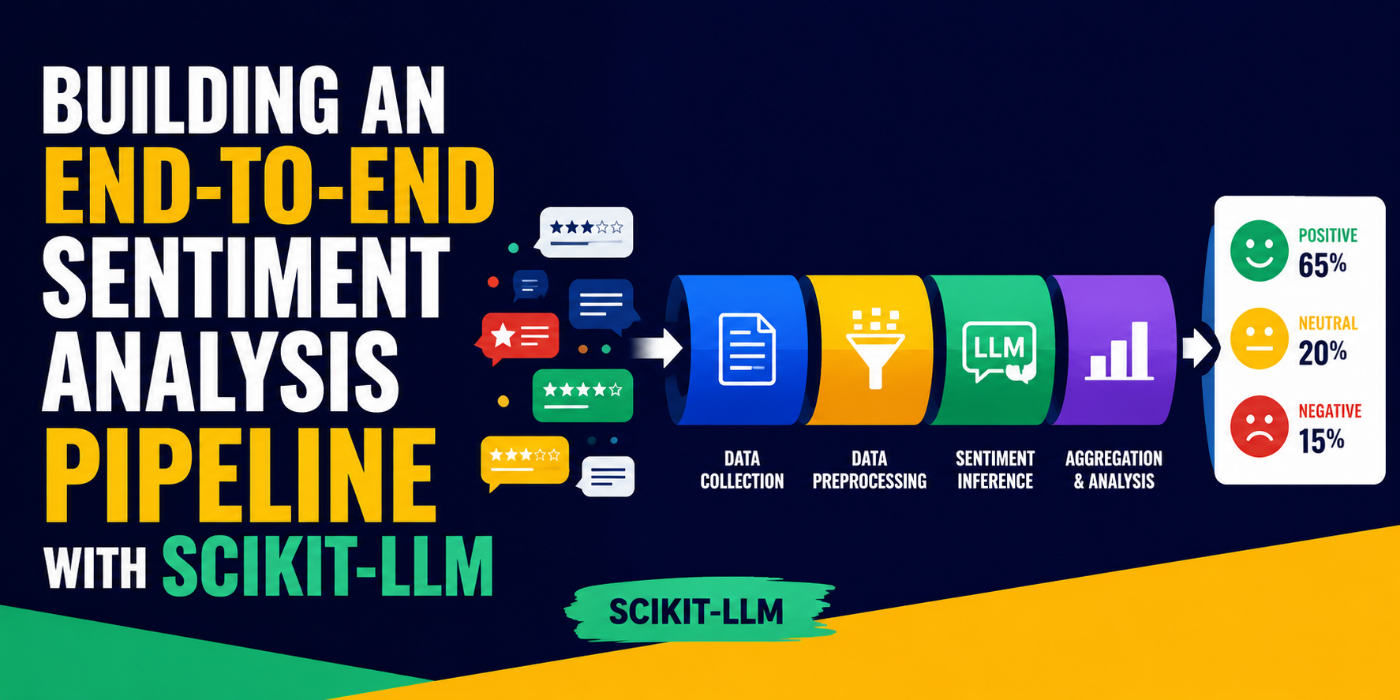
本文介绍了如何使用Scikit-LLM和Groq API构建情感分析管道,包括设置Scikit-LLM、准备IMDB电影评论数据集、构建零样本情感分类管道,并展示模型的预测性能。通过清洗文本数据和使用预训练模型,管道实现了高效的情感分类。
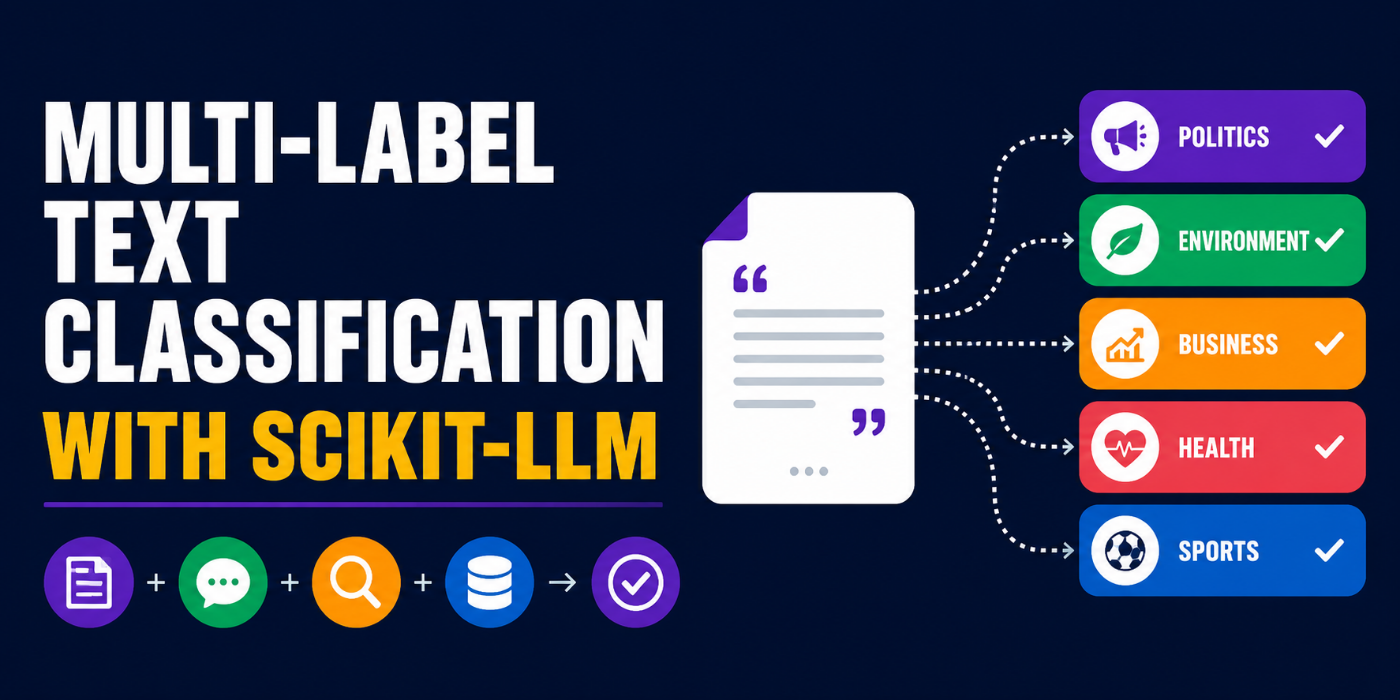
本文介绍了如何使用scikit-LLM库进行多标签文本分类,利用大型语言模型(LLM)进行零-shot推理,无需标记训练数据。文章阐述了多标签分类的定义及其重要性,配置scikit-LLM的方法,以及如何加载真实数据集进行情感预测。通过示例,展示了为文本分配多个情感标签的简便性和高效性。
本文介绍如何使用Ollama本地托管的开源语言模型(如Llama 3、Mistral和Gemma)进行文本分类,避免支付API费用。内容包括Ollama的安装、Scikit-LLM库的配置,以及构建零样本文本分类器的步骤。通过简单的Python代码,用户可以实现模型的训练和预测,展示如何高效使用大型语言模型。
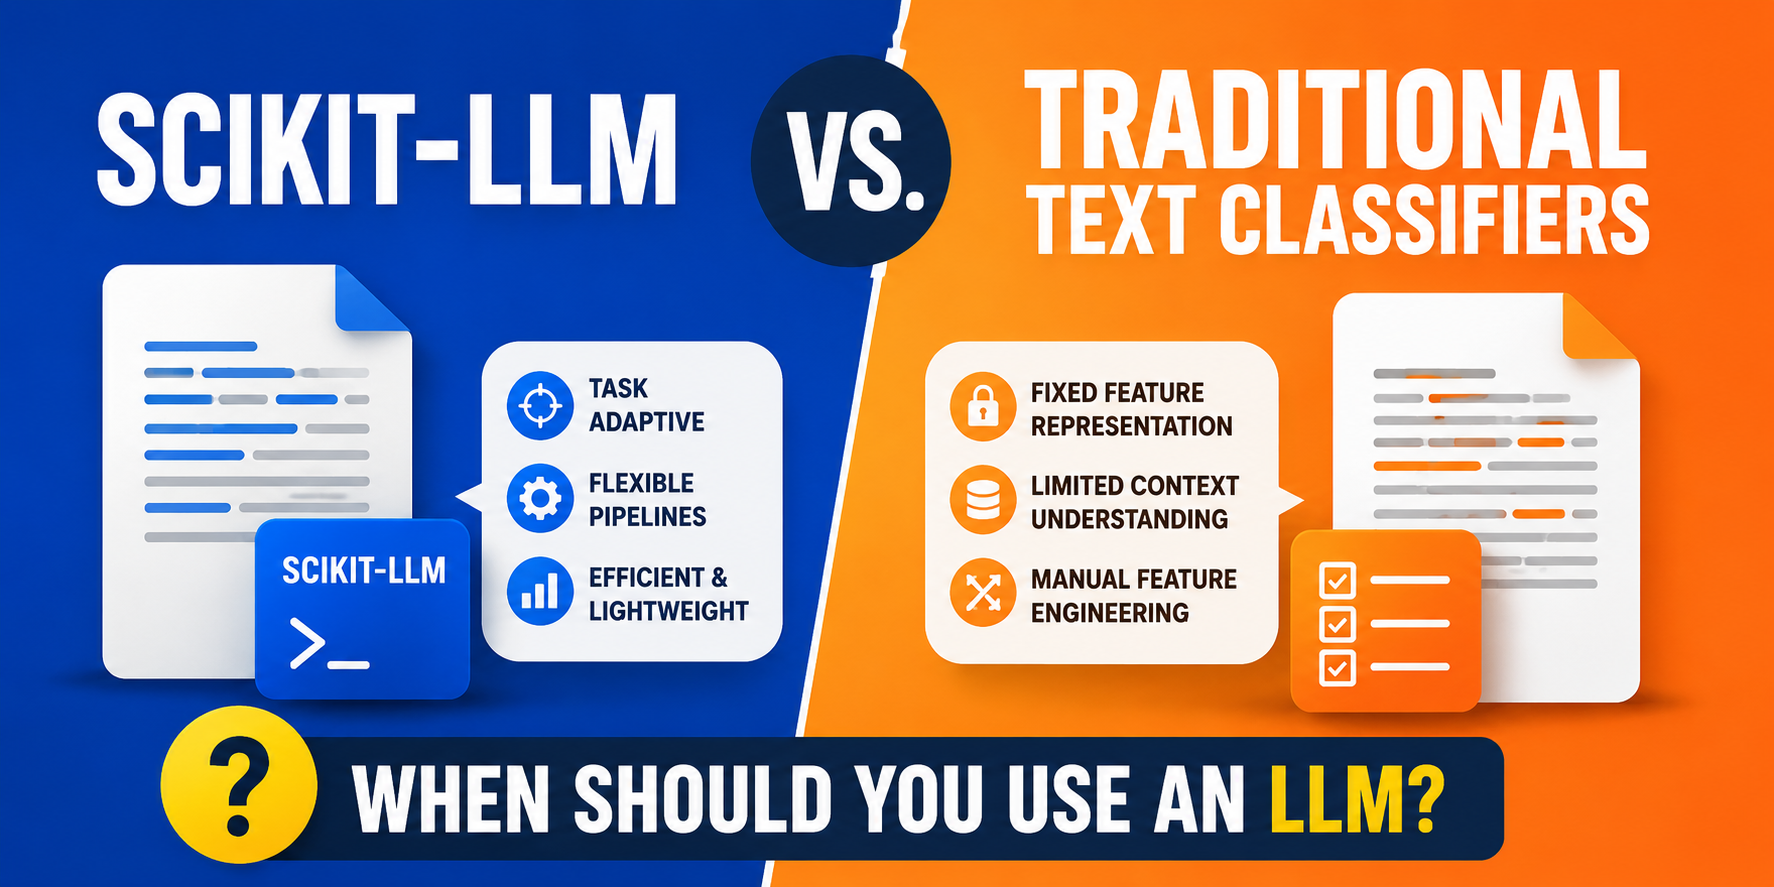
本文比较了三种文本分类方法:传统的TF-IDF与逻辑回归、基于BART的零-shot分类和使用scikit-LLM的零-shot分类。研究表明,scikit-LLM在分类准确性(0.86-0.87)和速度上优于其他方法,适合处理数据量小且需要深度语言理解的任务。
在数字时代,垃圾邮件成为安全威胁。开发者利用机器学习构建智能过滤器,本文介绍了一个无服务器垃圾邮件分类器项目,结合Scikit-learn和AWS服务,实现实时消息分类。该系统模块化且成本效益高,支持独立更新模型,展示了机器学习实验与实际应用之间的桥梁。
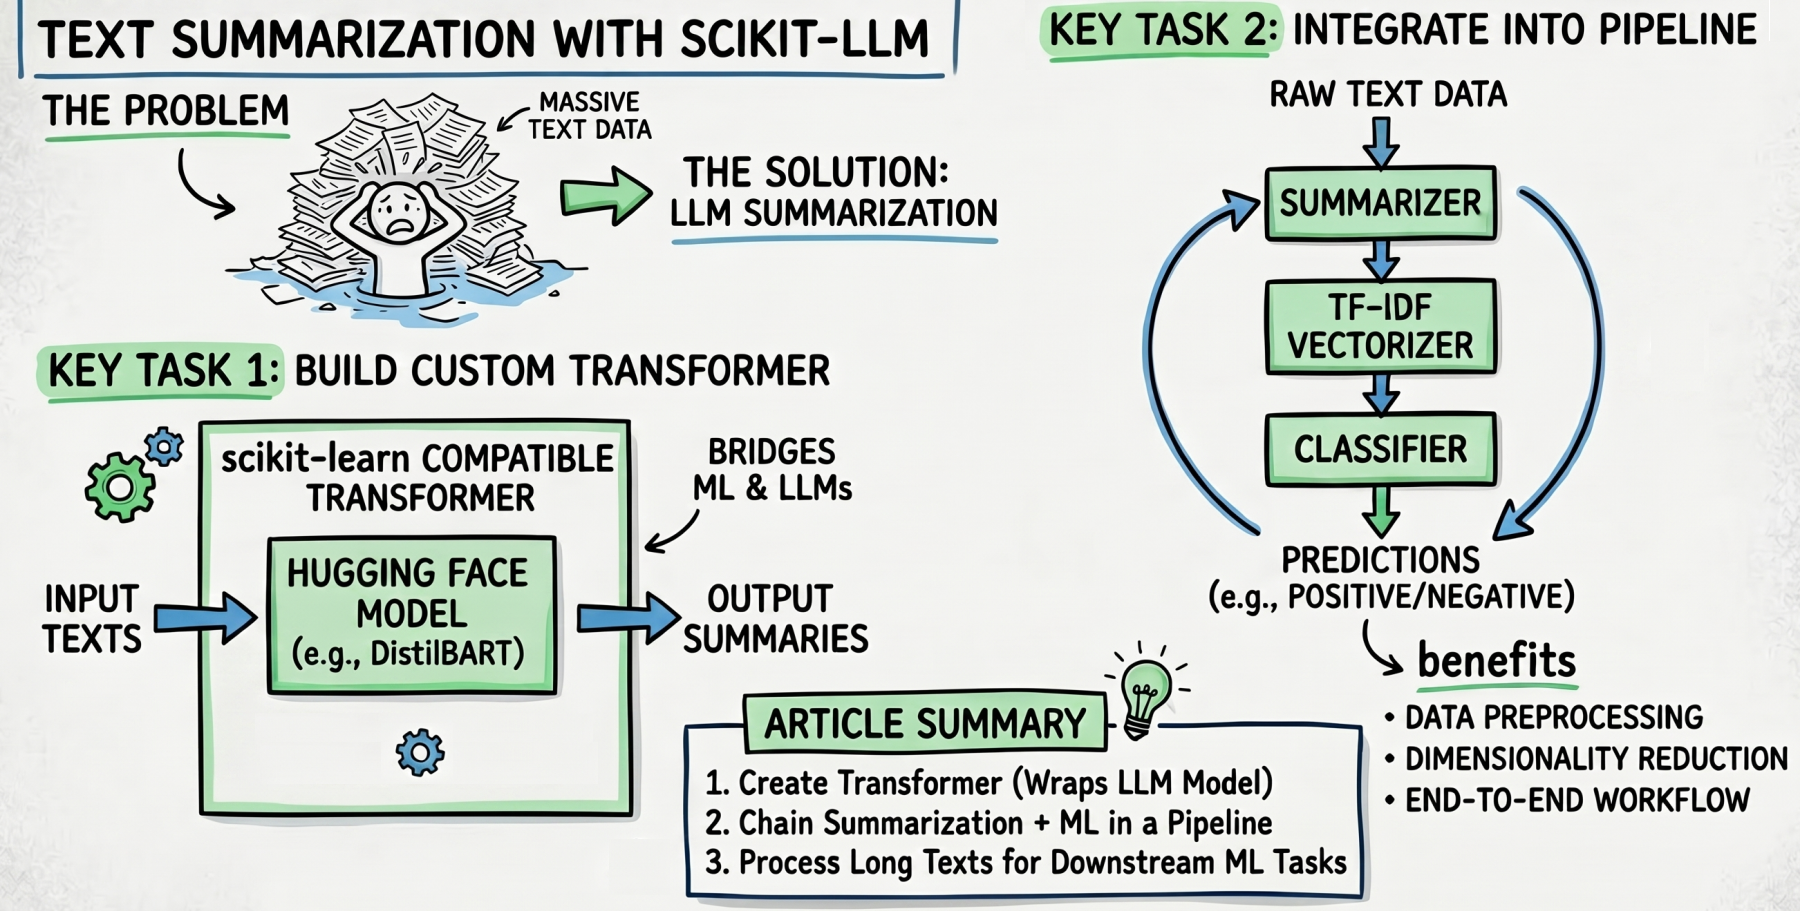
本文介绍了如何使用scikit-LLM库进行文本摘要,以解决机器学习中处理大量文本的问题。内容包括构建自定义转换器、将摘要集成到scikit-learn管道中,以及将摘要、TF-IDF向量化和分类器结合成完整流程。通过使用Hugging Face的预训练模型,用户可以有效提取文本摘要,提高文本分类效率。
本文介绍了如何使用FastAPI训练、服务和部署Scikit-learn模型。首先,创建项目结构并安装依赖。然后,使用乳腺癌数据集训练随机森林分类器并保存模型。接着,构建FastAPI服务器,提供健康检查和预测接口。最后,测试本地API并将其部署到FastAPI Cloud,确保API可用以处理生产流量。
本文介绍了如何在scikit-learn管道中结合LLM嵌入、TF-IDF特征和结构化元数据进行文本分类。主要步骤包括加载数据集、构建特征管道、融合特征以及训练分类器,以实现高效的文本分类模型。
完成下面两步后,将自动完成登录并继续当前操作。