xclang 是开箱即用的交叉编译 Clang 工具链,约 90MB 的包内含 6 个平台的 sysroot 与运行时,全平台统一 Clang + libc++,支持静态链接,import std 在 CMake、Bazel 中开箱可用。Apple 与微软 SDK 需用户自行下载。Clang 和 lld 经 PGO + ThinLTO 优化,编译速度与官方版持平,Windows 上更快。项目历时两周多完成,代码几乎全由 agent 编写。
GitHub Copilot CLI 的 C++ 代码智能现已支持全代码库索引(WCI),由微软 C++ 语言服务器驱动,基于 compile_commands.json 建立持久符号索引,无需打开 IDE 即可理解整个项目。该功能可加快定义、引用、实现和符号搜索,减少重复解析,更好支持大型仓库与并行代理工作流。索引默认启用,首次构建可能耗时并暂时增加内存,之后可复用并动态更新。
Qt Bridges发布C#桥接0.4.0 Beta版,最大亮点是无需C++编译器即可开发C#与QML应用,改为运行时导出类型元数据配置原生包装器,构建速度大幅提升。该功能目前仅在Windows平台实验性提供。新版本还新增对macOS及Windows on ARM的支持,相关包已上线NuGet。
Visual Studio 2026 强化 C++ 开发,结合 GitHub Copilot 实现代码导航、现代化与调试等 AI 辅助工作流;MSVC v14.52 完整支持 C++23;新增 Copilot CLI 终端代理,并提升构建与运行时性能。
xAI的Colossus集群拥有55万块GPU,但模型浮点运算利用率仅约11%,远低于行业35%至45%的水平。为此,xAI放弃JAX和PyTorch,改用C++和CUDA重写训练栈,并大量使用内联PTX直接控制GPU以逼近裸金属性能。Grok 4.8参数达2.5万亿,训练成本极高。更关键的是,xAI正让较弱模型参与编写训练更强模型的代码,形成递归自我改进循环,但AI生成代码的正确性验证仍是巨大风险。
Visual Studio 2026 的 18.7 至 18.10 版本为 C++ 开发者带来多项更新:GitHub Copilot 现代化代理正式发布,可协助升级 MSVC 项目;新增原生 NuGet PackageReference 支持、跨安装发现固定 MSVC 工具集版本;全代码库索引加速代码导航;Git 支持工作树与子模块;调试器可附加 Podman 容器并支持测试驱动排查;Copilot 还支持组织级指令、自选模型与自带密钥。
GSoC 2026 项目为 Clang API Notes 扩展 C++ 重载专用注解:在 YAML 中新增 Where 块,可按参数类型和对象限定符(const、引用等)精确匹配单个函数或方法重载,并支持类型别名与空参数列表。实现涵盖解析、序列化、Sema 集成与诊断,同时保持原有仅按名称匹配行为的兼容性。
Rust社区近期热议语言复杂度上升问题。有开发者列举命名参数、开放枚举等提案,担忧Rust重蹈C++覆辙。语言团队回应称对复杂度保持谨慎,部分提案实为简化。社区提出三轴判断法评估新特性,调查显示40%受访者希望优先简化。
微软在C++23中使标准库数学函数支持编译期求值,并在MSVC 14.52中实验性实现。由于UCRT数学函数精度不足且结果随系统变化,微软改用LLVM libc数学库,以兼顾精度、稳定性、一致性与性能,同时用于编译期和运行时。该功能默认关闭,需启用相关选项,微软希望收集用户反馈。
OpenClaw.NET 是开源的 .NET AI Agent 运行时与网关,内置鉴权、记忆和多渠道接入,支持 NativeAOT 编译为无依赖单文件原生二进制。文章面向 C++ 开发者,通过类比 C# 概念讲解系统组成与消息流转,并演示如何编写工具、技能、插件和渠道适配器。
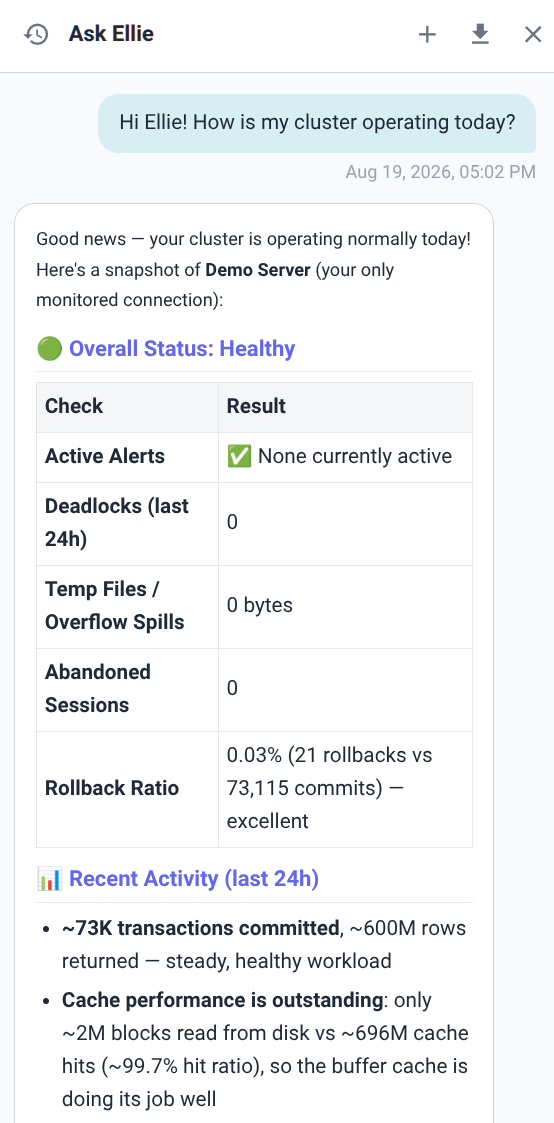
本文介绍如何用 Docker 搭建 pgEdge AI DBA Workbench 全本地化技术栈,共七个容器:Postgres、负载生成器、llama.cpp 模型服务、工作台服务器、采集器、告警器和客户端。使用 Qwen3.8-27B 推理模型与 nomic-embed-text 嵌入模型,通过 OpenAI 兼容接口调用,无需外部 AI 服务,适合气隙或敏感环境,可低成本实现 Postgres 智能监控与诊断。
Rust官方语言团队在Nightly版本中启动函数重载实验,旨在解决Rust调用C++重载函数时的命名问题。实验引入临时语法`#[rustc_splat]`,允许重载函数像普通函数一样调用,如`hypot(2.0, 3.0, 6.0)`,无需元组包装。该特性基于Rust-C++互操作计划,由谷歌资助,目前仍不完整,可能变更。团队提出四条设计公理,未来或推出`#[overload]`属性简化调用。
TensorSharp 是纯 .NET LLM 推理引擎,三天内接入 GLM-5.3-Flash 和 Qwen3.8-Flash-Next 新架构。它支持进程内推理,性能上 decode 速度翻倍,prefill 持平,并强调正确性验证和部署便捷性。对 .NET 团队,这标志着前沿模型架构跟进加速,值得纳入 PoC 评估。
vLLM的并行限制源于注意力头数需被TP大小整除,而非固定1/2/4/8卡;llama.cpp采用层切分,通信量小,卡数影响不大,关键在互联类型。TensorSharp引擎同时支持层切分和张量并行,3卡跑744B模型性能超llama.cpp,但TP对互联敏感,2卡仅提升1.4倍。核心结论:层切分对卡数免疫,TP对互联敏感。
Muse Glimmer是Meta推出的本地AI编码模型,性能优于Qwen 27B类模型。本文指导用户通过llama.cpp和DFlash加速运行,并连接Pi代理实现本地编码。测试显示速度达127 tokens/秒,能自主构建、测试和调试项目,但HTML生成略逊于Qwen。推荐RTX 3090/4090/5090用户尝试,本地AI编码已接近付费模型体验。
该文章介绍了一个名为“Awesome C++ Blogs”的精选技术博客集合,旨在系统整理值得反复阅读的C++相关文章,类似必读书目。目前内容初步规划,已列出百度C++工程师的极限优化系列,涵盖内存和并发两个主题,后续将逐步补充更多内容。
本文介绍SonarQube社区版通过cxx插件检测C++项目的方法。内容包括插件特性、安装步骤(下载兼容版本、复制jar包、重启服务)、卸载方式,以及源代码扫描流程、项目配置、SonarScanner使用和日志解读,并附故障排查建议。
2026年,.NET生态出现三个本地大模型推理引擎:LLamaSharp借力llama.cpp,性能稳定但依赖原生库;dotLLM纯C#实现,CPU解码追平C++,但预填充慢,零原生依赖;TensorSharp融合GGML内核,GPU吞吐领先,支持多模态和集群。三者各具优势,求稳选LLamaSharp,求纯选dotLLM,求全选TensorSharp,C#本地推理已成熟。
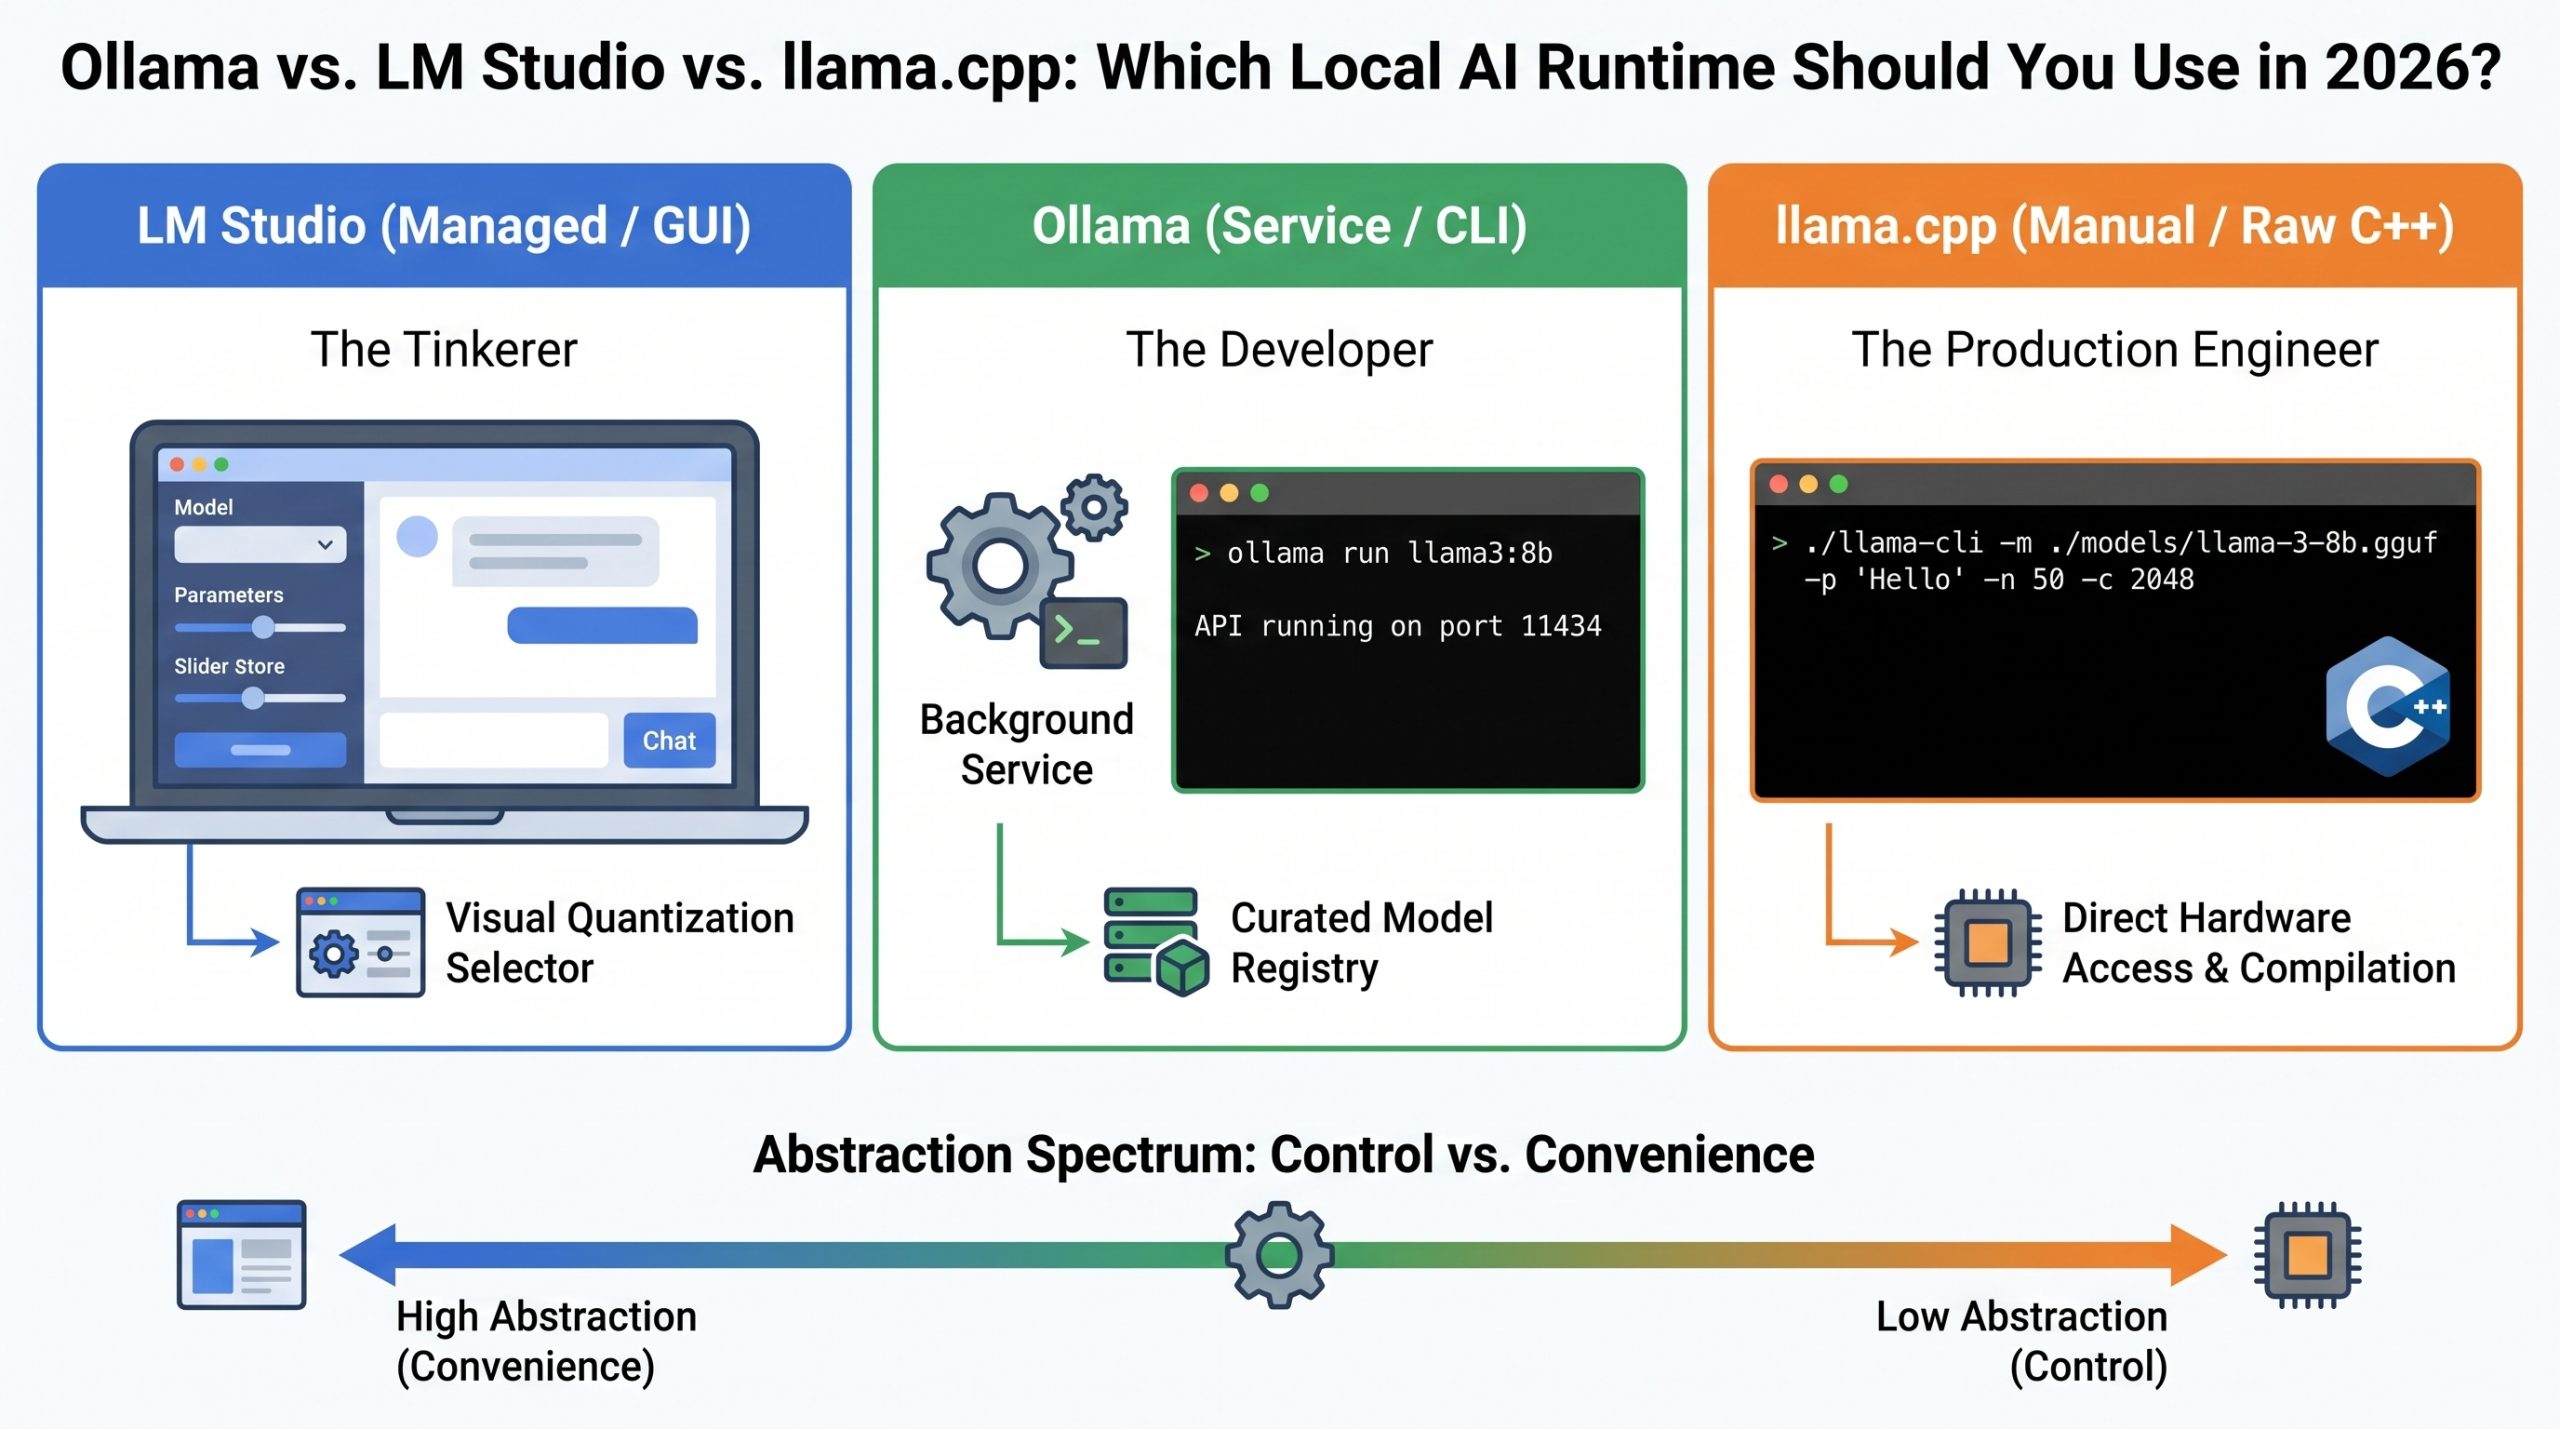
本文比较了Ollama、LM Studio和llama.cpp三种本地AI运行时。LM Studio适合初学者,提供图形界面和可视化量化控制;Ollama适合开发者,提供简洁CLI和API集成;llama.cpp适合追求极致控制的生产工程师,支持手动量化。三者共享同一推理引擎,用户可按需从LM Studio迁移至Ollama再至llama.cpp。
C/C++项目迁移到Rust应谨慎,推荐增量迁移而非全量重写。从模块依赖图的叶子节点开始,先解决构建、链接、测试等集成问题,逐步扩大Rust代码范围。迁移难点在于FFI边界管理,需明确所有权和释放规则。适合迁移的项目包括性能敏感、并发或安全关键系统,迁移前需评估维护成本和测试基础设施。
完成下面两步后,将自动完成登录并继续当前操作。