


深度神经网络是否严重过拟合?
内容提要
深度神经网络参数量大却能泛化,传统偏差-方差权衡难以解释。文章基于奥卡姆剃刀、最小描述长度和柯尔莫哥洛夫复杂度指出,参数量并非复杂度的有效度量。双下降风险曲线、内在维度、层间鲁棒性差异及彩票假设表明,网络实际有效复杂度远低于表面,仅少数关键子结构决定性能。
延伸解读
传统复杂度度量为何失效
文章指出,传统机器学习用参数量衡量模型复杂度,但深度神经网络参数量巨大却仍能泛化。奥卡姆剃刀、最小描述长度和柯尔莫哥洛夫复杂度表明,参数量并非有效复杂度度量。MDL将学习视为数据压缩,模型描述长度也计入总长度,因此不能仅看参数量。这解释了为何过参数化网络不一定严重过拟合。
双下降风险曲线的启示
经典偏差-方差权衡呈现U形风险曲线,但深度网络表现出双U形曲线。当参数量超过插值阈值后,测试误差反而再次下降。文章认为,这是因为参数量不是归纳偏置的好度量,且大模型可能找到范数更小、更简单的插值函数。这提醒我们,过拟合不能简单以训练误差为零来判断。
有效复杂度远低于表面
内在维度测量显示,许多问题的内在维度远小于参数量,例如CIFAR10上全连接网络有65万参数,内在维度仅9千。层间鲁棒性实验表明,只有少数层对性能关键,重置高层参数影响很小。彩票假设进一步指出,密集网络中只有少数子网络是“中奖彩票”,单独训练即可达到原性能。这些证据共同说明,网络实际有效复杂度远低于表面。
对实践者的启示
文章强调,显式正则化并非泛化的根本原因,数据增强、权重衰减和dropout等虽有用,但非必要或充分。理解深度网络的泛化,需要关注有效复杂度而非参数量。实践中,可尝试剪枝或寻找关键子网络,但需注意彩票假设中奖彩票的初始化依赖,直接从头训练剪枝网络可能困难。
Q&A
深度神经网络参数这么多,为什么还能泛化而不严重过拟合?
因为参数数量并不是模型复杂度的有效度量。深度神经网络的实际有效复杂度远低于表面参数量,仅少数关键子结构决定性能,因此即使训练误差为零,仍能泛化到未见数据。
什么是双下降风险曲线?它和传统偏差-方差权衡有什么不同?
双下降风险曲线是深度神经网络中观察到的风险曲线,呈双U形。传统偏差-方差权衡是U形曲线,模型复杂度超过阈值后测试误差上升;而双下降曲线在模型参数足够多时,测试误差会再次下降,进入另一个低风险区域。
内在维度如何解释深度神经网络的复杂度?
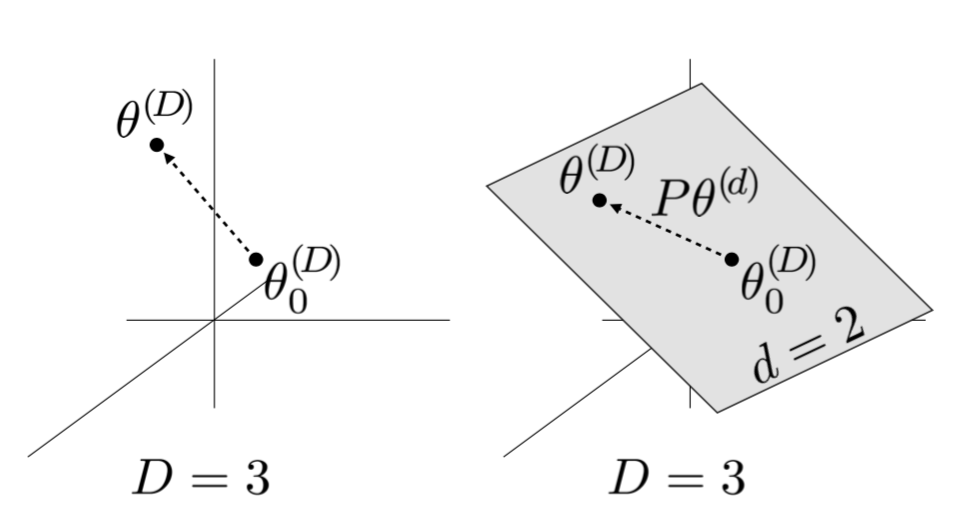
内在维度指在参数空间中,学习所需的有效子空间维度。实验表明,许多深度神经网络的内在维度远小于参数数量,例如CIFAR10上全连接网络有65万参数但内在维度仅9千,说明模型实际复杂度远低于表面。
彩票假设是什么?它如何支持深度神经网络没有严重过拟合?
彩票假设认为随机初始化的密集前馈网络包含许多子网络,其中只有少数“中奖彩票”子网络在独立训练时能达到最优性能。这表明最终解决方案不需要大量参数,但训练时需要大参数池提供初始化配置,因此网络并未严重过拟合。
深度神经网络中所有层都一样重要吗?
不一样。研究发现,重新随机初始化任何层都会完全破坏模型性能,但重新初始化时,只有靠近输入的前几层是关键层,重新初始化高层对性能影响很小。ResNet通过残差连接将敏感层分散到各残差块的第一层。
正则化是深度神经网络泛化的关键吗?
不是。研究表明,显式正则化(如数据增强、权重衰减、dropout)既不是减少泛化误差的必要条件,也不是充分条件。没有单一正则化项是独立关键的,因此正则化不太可能是泛化的根本原因。
