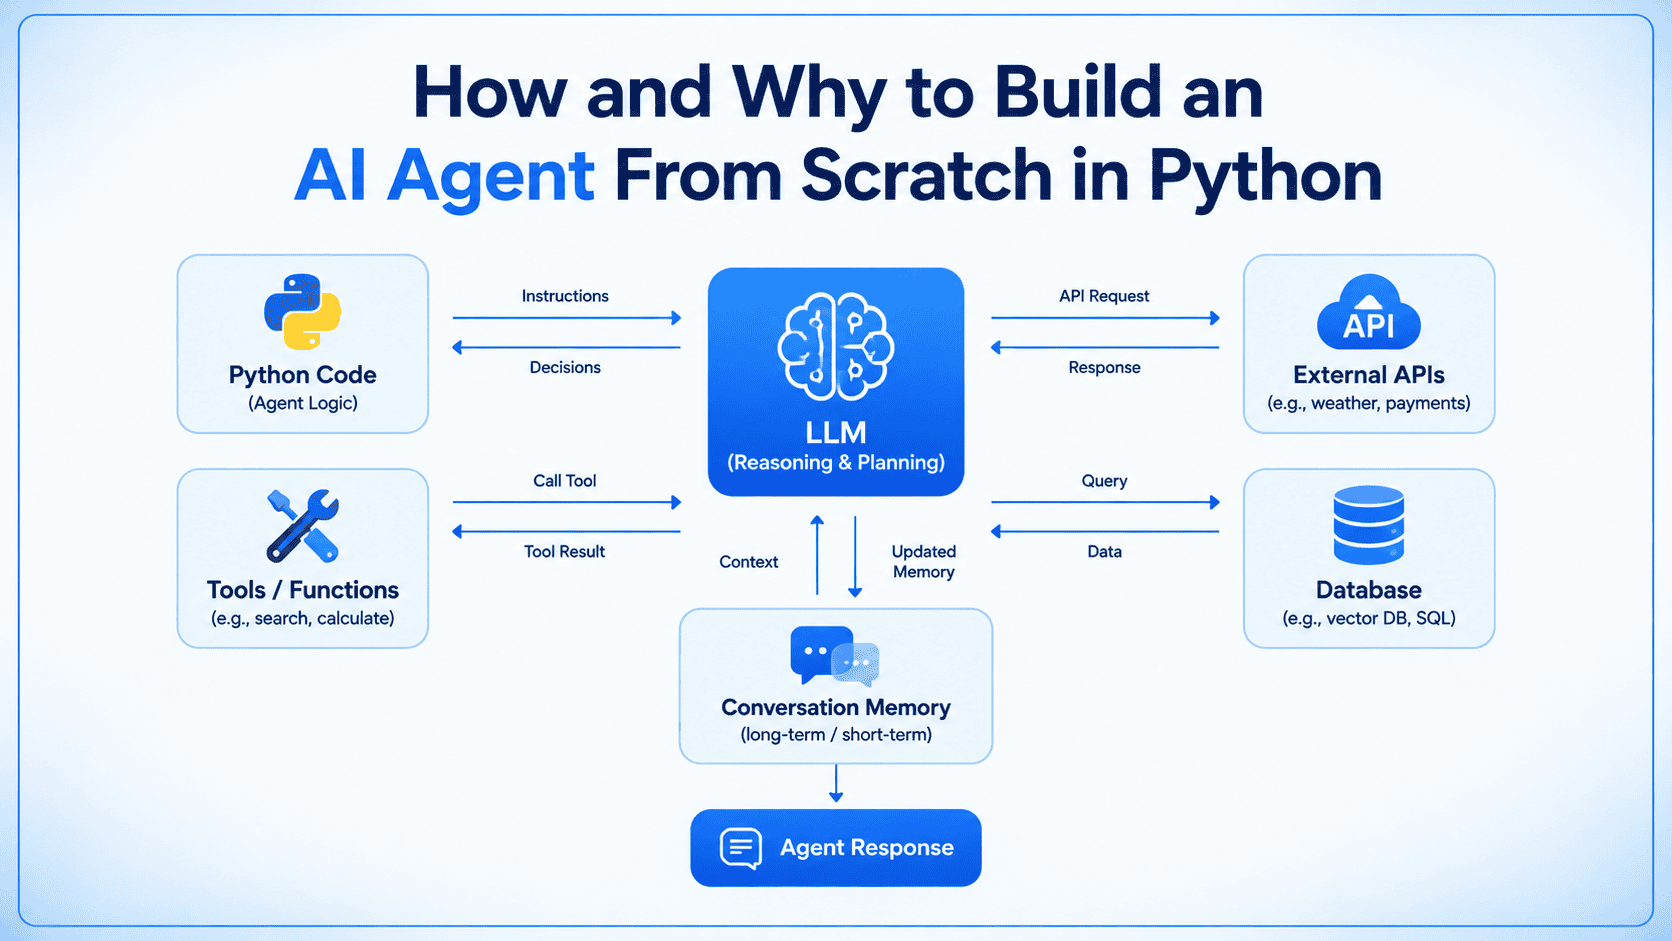

如何(以及为何)用 Python 从零构建 AI 智能体
内容提要
本文介绍如何仅用纯 Python 和 Anthropic API 从零构建 AI 智能体,不依赖编排框架。核心是工具调用:定义函数及其 schema,模型据此请求数据;通过“请求—执行—响应”循环反复调用工具,直到模型能作答,并设置最大迭代次数防止死循环。最后用类保存对话历史,实现跨轮次记忆。
延伸解读
工具调用:智能体的核心机制
文章强调,当问题需要模型训练数据之外的信息时,单纯调用大模型无法给出可靠答案。工具调用让模型能够请求外部数据,如查询订单状态。实现方式是定义函数及其 schema,模型根据描述决定是否调用。这揭示了智能体的本质:模型加循环加函数,而非复杂框架。理解这一点有助于把握智能体工作原理。
请求-执行-响应循环与迭代上限
智能体通过循环反复调用工具,直到模型能作答。每次循环中,模型返回工具调用请求,代码执行函数并将结果作为 tool_result 追加到对话,再次发送给模型。文章设置 max_iterations 防止模型陷入无限调用,避免资源浪费。这一设计提醒开发者,循环必须有终止条件,否则可能导致预算超支或系统卡死。
记忆实现与生产环境局限
文章用类保存对话历史,使智能体在多轮对话中保持上下文。但这种方式仅限单进程内存,进程重启或对话超出模型上下文窗口时会失效。生产环境通常需要修剪或总结历史,并将对话持久化到数据库或文件。这指出了从原型到生产的关键差距:内存管理与会话持久化是必须考虑的问题。
模型版本与代码可维护性
文章提醒,示例使用的 Claude Sonnet 4.5 将于 2026 年 11 月 30 日退役,之后需替换模型字符串。这反映了依赖外部 API 的智能体需要关注模型生命周期,及时更新以避免服务中断。同时,从零构建的代码完全透明,便于调试和修改,但也要自行处理错误、日志等生产级需求。
Q&A
为什么需要工具调用?
因为当答案依赖于模型训练数据之外的数据(如实时订单状态或数据库中的记录)时,单纯调用大语言模型无法获取这些信息,模型要么表示不知道,要么编造答案。工具调用让模型能够请求外部数据,从而给出基于真实数据的回答。
如何用 Python 从零构建一个 AI 智能体?
使用纯 Python 和 Anthropic API,不依赖编排框架。核心步骤包括:定义工具函数及其 schema,实现请求-执行-响应循环,并添加记忆机制。具体代码可参考文章中的示例。
如何定义工具让模型知道何时调用?
需要编写函数本身,并提供一个描述该函数的 schema,包括名称、描述和参数定义。描述应说明函数的作用以及何时使用,模型会根据 schema 决定是否调用。
请求-执行-响应循环是如何工作的?
循环中,首先向模型发送消息和工具列表,模型可能返回 tool_use 请求;然后执行对应的工具函数,将结果作为 tool_result 追加到消息历史;再次调用模型,直到模型不再请求工具并返回最终答案。循环设置最大迭代次数防止无限循环。
如何为智能体添加记忆以保持上下文?
将消息列表保存在一个类实例的属性中(如 self.messages),而不是每次调用都新建。这样在多次调用 run() 方法时,模型能看到完整对话历史,从而理解上下文。
构建智能体需要哪些前提条件?
需要 Python 3.10 或更高版本、Anthropic API 密钥,并安装 Anthropic Python SDK(pip install anthropic)。将 API 密钥设置为环境变量 ANTHROPIC_API_KEY。
为什么要在循环中设置最大迭代次数?
防止模型不断请求“再调用一次”工具而陷入无限循环,导致消耗过多资源或预算。设置上限并在达到时返回明确的回退消息,可以避免生产环境中的意外情况。
