
新AI模型 Jev 实战:概念、场景和两个实战
内容提要
Jev 是 TypeSafe 推出的非生成式 AI 模型,专注判断而非写作,接收状态与问题后返回类型化答案和校准概率,具有速度快、成本低的特点。文章介绍其三种原语、API 用法,并通过 Go 迁移代码对齐审查和浏览器操作两个实战案例,强调判断交模型、决策留代码的分工。
延伸解读
判断与生成的分工:Jev 的定位与边界
Jev 不做生成,只做判断。它接收状态和带选项的问题,返回类型化答案和校准概率,不写文本、不解释理由。这决定了它适合高频、候选有限、错了能补救的判断场景,如路由、筛选、风险检查。需要写作或复杂推理时,仍要交给 LLM。两者之间由普通代码衔接,用概率和阈值决定执行路径。理解这一分工,才能避免把它误用为通用助手。
校准概率的工程意义与使用前提
Jev 的核心优势是概率校准:给出 90% 概率的判断,长期应有约 90% 正确率。这让概率可直接作为代码阈值使用,而普通 LLM 的结构化输出并不保证校准。但校准是长期统计性质,单次可能出错,不能当作证明。厂商宣传的速度和成本数字来自自评测,未经第三方验证。实际使用前,应用自己的脱敏样本校准阈值,并同时统计漏检和误报。
两个实战案例揭示的落地要点
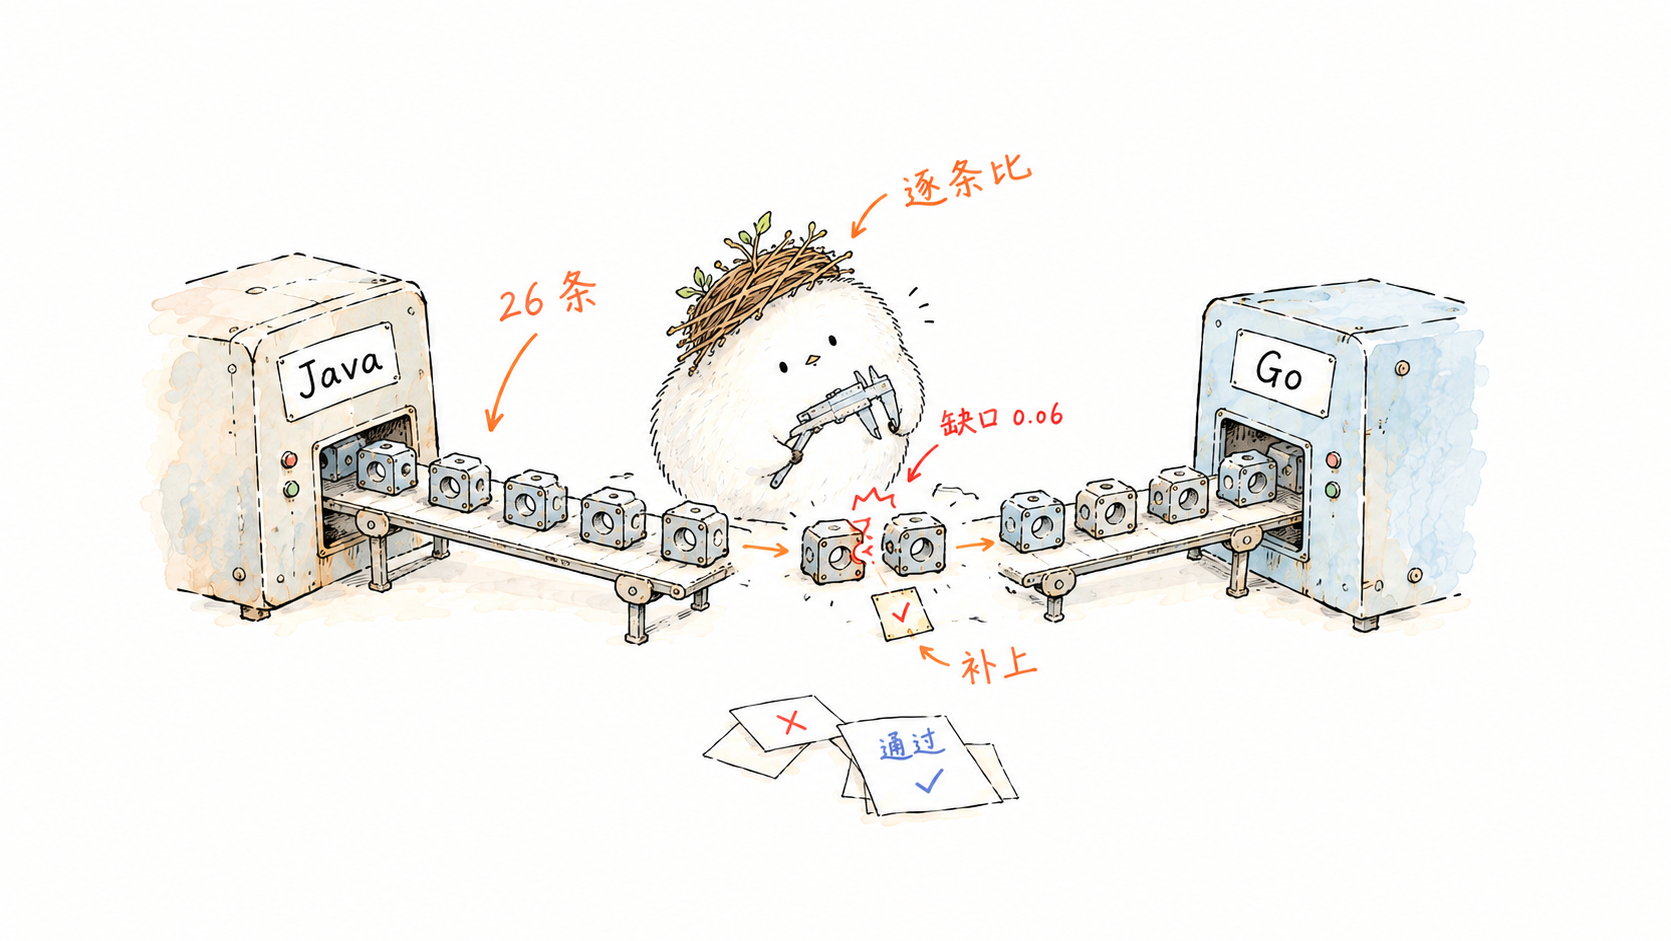
在 Go 迁移代码对齐审查中,Jev 将 26 条行为拆成 Noul 问题并行判定,发现一条真实缺口,成本不到半美分。关键经验是:低分项必须人工复核,跨语言判定需补充语言语义注,避免将写法差异误判为行为差异。在浏览器操作中,Jev 只负责在候选元素中选择,本地策略门过滤风险,大模型负责拆任务和核验。中文角色映射缺失曾导致候选遗漏,说明输入预处理同样影响准确率。
接入方式与生态工具的选择
Jev 提供 HTTP API、官方 Python/JavaScript SDK,社区也有 Go SDK,还可通过 Vercel AI Gateway 接入。社区已出现代码评审插件 jev-review、官方 TypeSafe Skill 和 Claude Code 的 PreToolUse hook 等工具。选择时需注意:插件读取的 API 密钥变量名可能与 SDK 不同;hook 只基于命令文本做附加检查,不能替代原有权限和沙箱。接入姿势通常是在既有流程中增加一个可替换的判断节点。
Q&A
Jev 是什么类型的 AI 模型?它和普通 LLM 有什么区别?
Jev 是 TypeSafe 推出的非生成式 AI 模型,专注判断而非写作。它接收状态和问题后返回类型化答案和校准概率,不生成自由文本。与 LLM 逐 token 生成不同,Jev 并行对每个问题独立采样,返回你定义的选项上的概率分布,速度快、成本低。
Jev 的三种原语分别是什么?各自返回什么?
三种原语:Noul(是非判断,返回 0-1 的 noul 概率)、Choice(从固定集合选一个,返回 choice、probabilities、confidence)、Score(在有序刻度上打分,返回 score、legend、probabilities、confidence)。
Jev 适合用在哪些场景?
适合高频判断、候选范围有限、需要理解语境且错了能发现补救的场景,如 Agent 调度、记忆筛选、代码质量检查、浏览器操作、业务分流、实时交互辅助、游戏控制等。
在 Go 迁移代码对齐审查中,Jev 是如何使用的?效果如何?
将 Java 和 Go 代码的逐字摘录作为 state,对每条行为构造 Noul 问题,并行判定。26 条行为中 25 条高分覆盖,1 条低分发现真实缺口(埋点 gRPC 分支未实现),2 条误报经补语言语义注后回升。成本约 1 万 input token,不到半美分。
在浏览器操作场景中,Jev 如何与 LLM 分工?
Jev 负责在候选元素中做选择(target、action、done、risk 四个问题),LLM(如 Codex)负责拆任务、准备参数、核验结果,运行时负责读取界面和执行。本地策略门再过滤风险。
使用 Jev 时有哪些关键设计原则?
问题只描述判断,组合、阈值和副作用由代码掌握;一次请求可并行问多个问题(投机扇出);置信度分三档路由(高置信自动执行、中置信确认、低置信转人工);阈值需在自有数据上校准。
