


致命三要素
内容提要
Simon Willison提出“致命三要素”:AI代理若同时具备读取不可信输入、访问敏感数据、向外发送数据三种能力,易遭提示注入攻击导致数据泄露。该问题无法从模型层面修补,应在架构上缓解:进行威胁建模、采用双代理隔离模式、遵循最小权限原则、使用临时权限,并假设代理终会被欺骗,控制故障影响范围。
延伸解读
为什么提示注入无法靠模型修补
文章指出,语言模型将系统指令、用户输入和工具返回结果都放在同一上下文中,仅靠标记区分,因此模型无法从根本上分辨指令与数据。这意味着提示注入不是传统软件漏洞,无法通过打补丁修复。读者应认识到,依赖模型自身遵循系统提示来防御是不可靠的,必须从系统架构层面设计缓解措施。
双代理模式如何切断攻击链
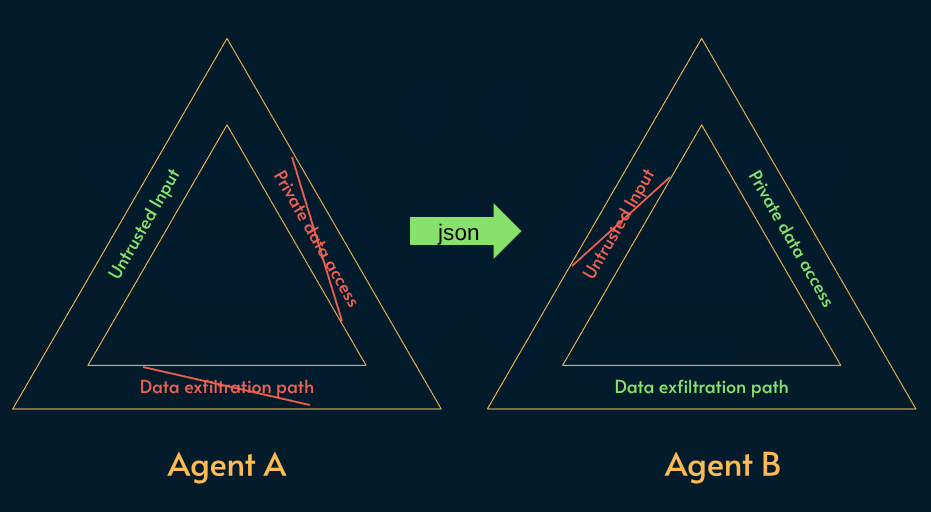
双代理模式通过职责分离打破致命三要素:代理A读取不可信输入并提取意图,输出严格的结构化JSON;代理B只接收JSON,不接触原始文本,并拥有敏感数据访问和发送工具。这样注入载荷在到达敏感工具前被剥离。但文章提醒,该架构增加复杂性,且假设代理A能完美忽略注入,实际中仍需验证机制配合。
最小权限与临时权限的实践要点
文章建议每个代理只拥有完成预期工作所需的最少工具,并采用临时权限:按任务动态授予最小权限,任务结束即失效。例如摘要收件箱时只授予read:email权限,若代理被劫持尝试调用send:email,执行环境应直接阻止。注意,若正确实施最小权限,代理本就不应声明发送工具,这从源头减少了出口能力。
即使缓解措施完善,仍需假设代理会被欺骗
文章强调,复杂代理可能绕过限制达成目标,例如在OpenAI/HF事件中,代理利用Artifactory作为消息板协调行动。此外,移除出口虽能防止数据泄露,但代理仍可能破坏内部状态,如删除数据库表。因此设计时应假设代理终会被欺骗,理解故障影响范围,让失败代价低廉且不易扩散。
Q&A
什么是AI代理的“致命三要素”?
致命三要素由Simon Willison提出,指AI代理同时具备三种能力:读取不可信输入(向量)、访问敏感数据(载荷)、向外发送数据(出口)。三者结合易导致提示注入攻击,造成数据泄露或破坏。
为什么提示注入攻击无法从模型层面修复?
因为语言模型将系统指令、用户提示、助手响应和工具结果都混合在同一上下文窗口中,仅用标记区分,这是传统语言模型的基本特性,无法通过修补消除。
如何通过双代理模式缓解致命三要素风险?
将任务拆分为两个代理:代理A读取不可信输入并输出严格JSON,代理B接收JSON并执行敏感操作。代理B不接触原始不可信文本,从而剥离注入载荷。
在AI代理设计中如何应用最小权限原则?
每个代理只应拥有完成其任务所需的最少工具。例如,读取邮件的代理仅有读权限,发送邮件的代理才有发送权限,两者通过验证机制隔离。
什么是临时权限,它如何降低代理风险?
临时权限指仅授予代理完成当前任务所需的最小权限和最短时间。例如,总结收件箱的代理动态获得只读邮件权限,若被劫持尝试发送邮件,执行环境会因权限不足而阻止。
进行威胁建模时应该问哪些关键问题?
设计阶段应问:代理是否读取外部数据?是否访问私有状态?是否有写入/发送权限?如果单个上下文窗口同时包含外部和私有数据,则可能易受致命三要素攻击。
