


数据库内部的隐藏延迟
内容提要
云数据库通常采用网络附加存储(如AWS EBS),存储与计算分离,每次读写都需经过网络,带来隐藏延迟;SSD普及后网络延迟成为主要瓶颈。PlanetScale Metal改用本地NVMe磁盘,消除存储与计算间的网络跳转,并通过主库加至少两个跨可用区副本、提交需副本确认来保证持久性。本地磁盘无IOPS上限且成本更低,适合缓存未命中多或受IOPS限制的工作负载;若读数据能放入内存,网络存储仍够用。
延伸解读
网络存储的延迟从何而来
云数据库通常将存储放在独立服务器上,通过EBS等网络附加存储挂载。每次读写都要经过网络,即使同数据中心往返也需约1毫秒。SSD普及后磁盘操作快了约100倍,网络延迟反而成为主要瓶颈。AWS为此开发了专用硬件和SRD协议来缓解,但网络跳转本身并未消除。理解这一点,就能明白为何本地NVMe磁盘能带来实质性的延迟改善。
本地磁盘的持久性如何保障
本地NVMe磁盘直接连在主机上,读写无需网络跳转,但数据不会自动复制,主机故障即丢失。PlanetScale Metal的解法是每个集群至少一个主库加两个跨可用区副本,提交需至少一个副本确认后才向客户端返回成功。这虽然为每次提交引入一次网络跳转,但远少于EBS方案中每次磁盘操作都跨网络的情况。副本随时可提升为主库,切换期间查询会被缓冲。
IOPS上限与成本的实际差异
EBS默认IOPS上限为3000,超出需额外付费,这是为防 noisy neighbor 而设的人为限制。本地磁盘没有此上限。文中对比:r7i配700GB io2卷、16000 IOPS,按需每月1513.82美元;i7i配1.8TB本地NVMe、约30万IOPS,每月551.15美元。对于受IOPS限制的工作负载,本地磁盘不仅更快,也可能更便宜。但需注意这是特定配置下的对比,实际成本随规模变化。
什么情况下不必换本地磁盘
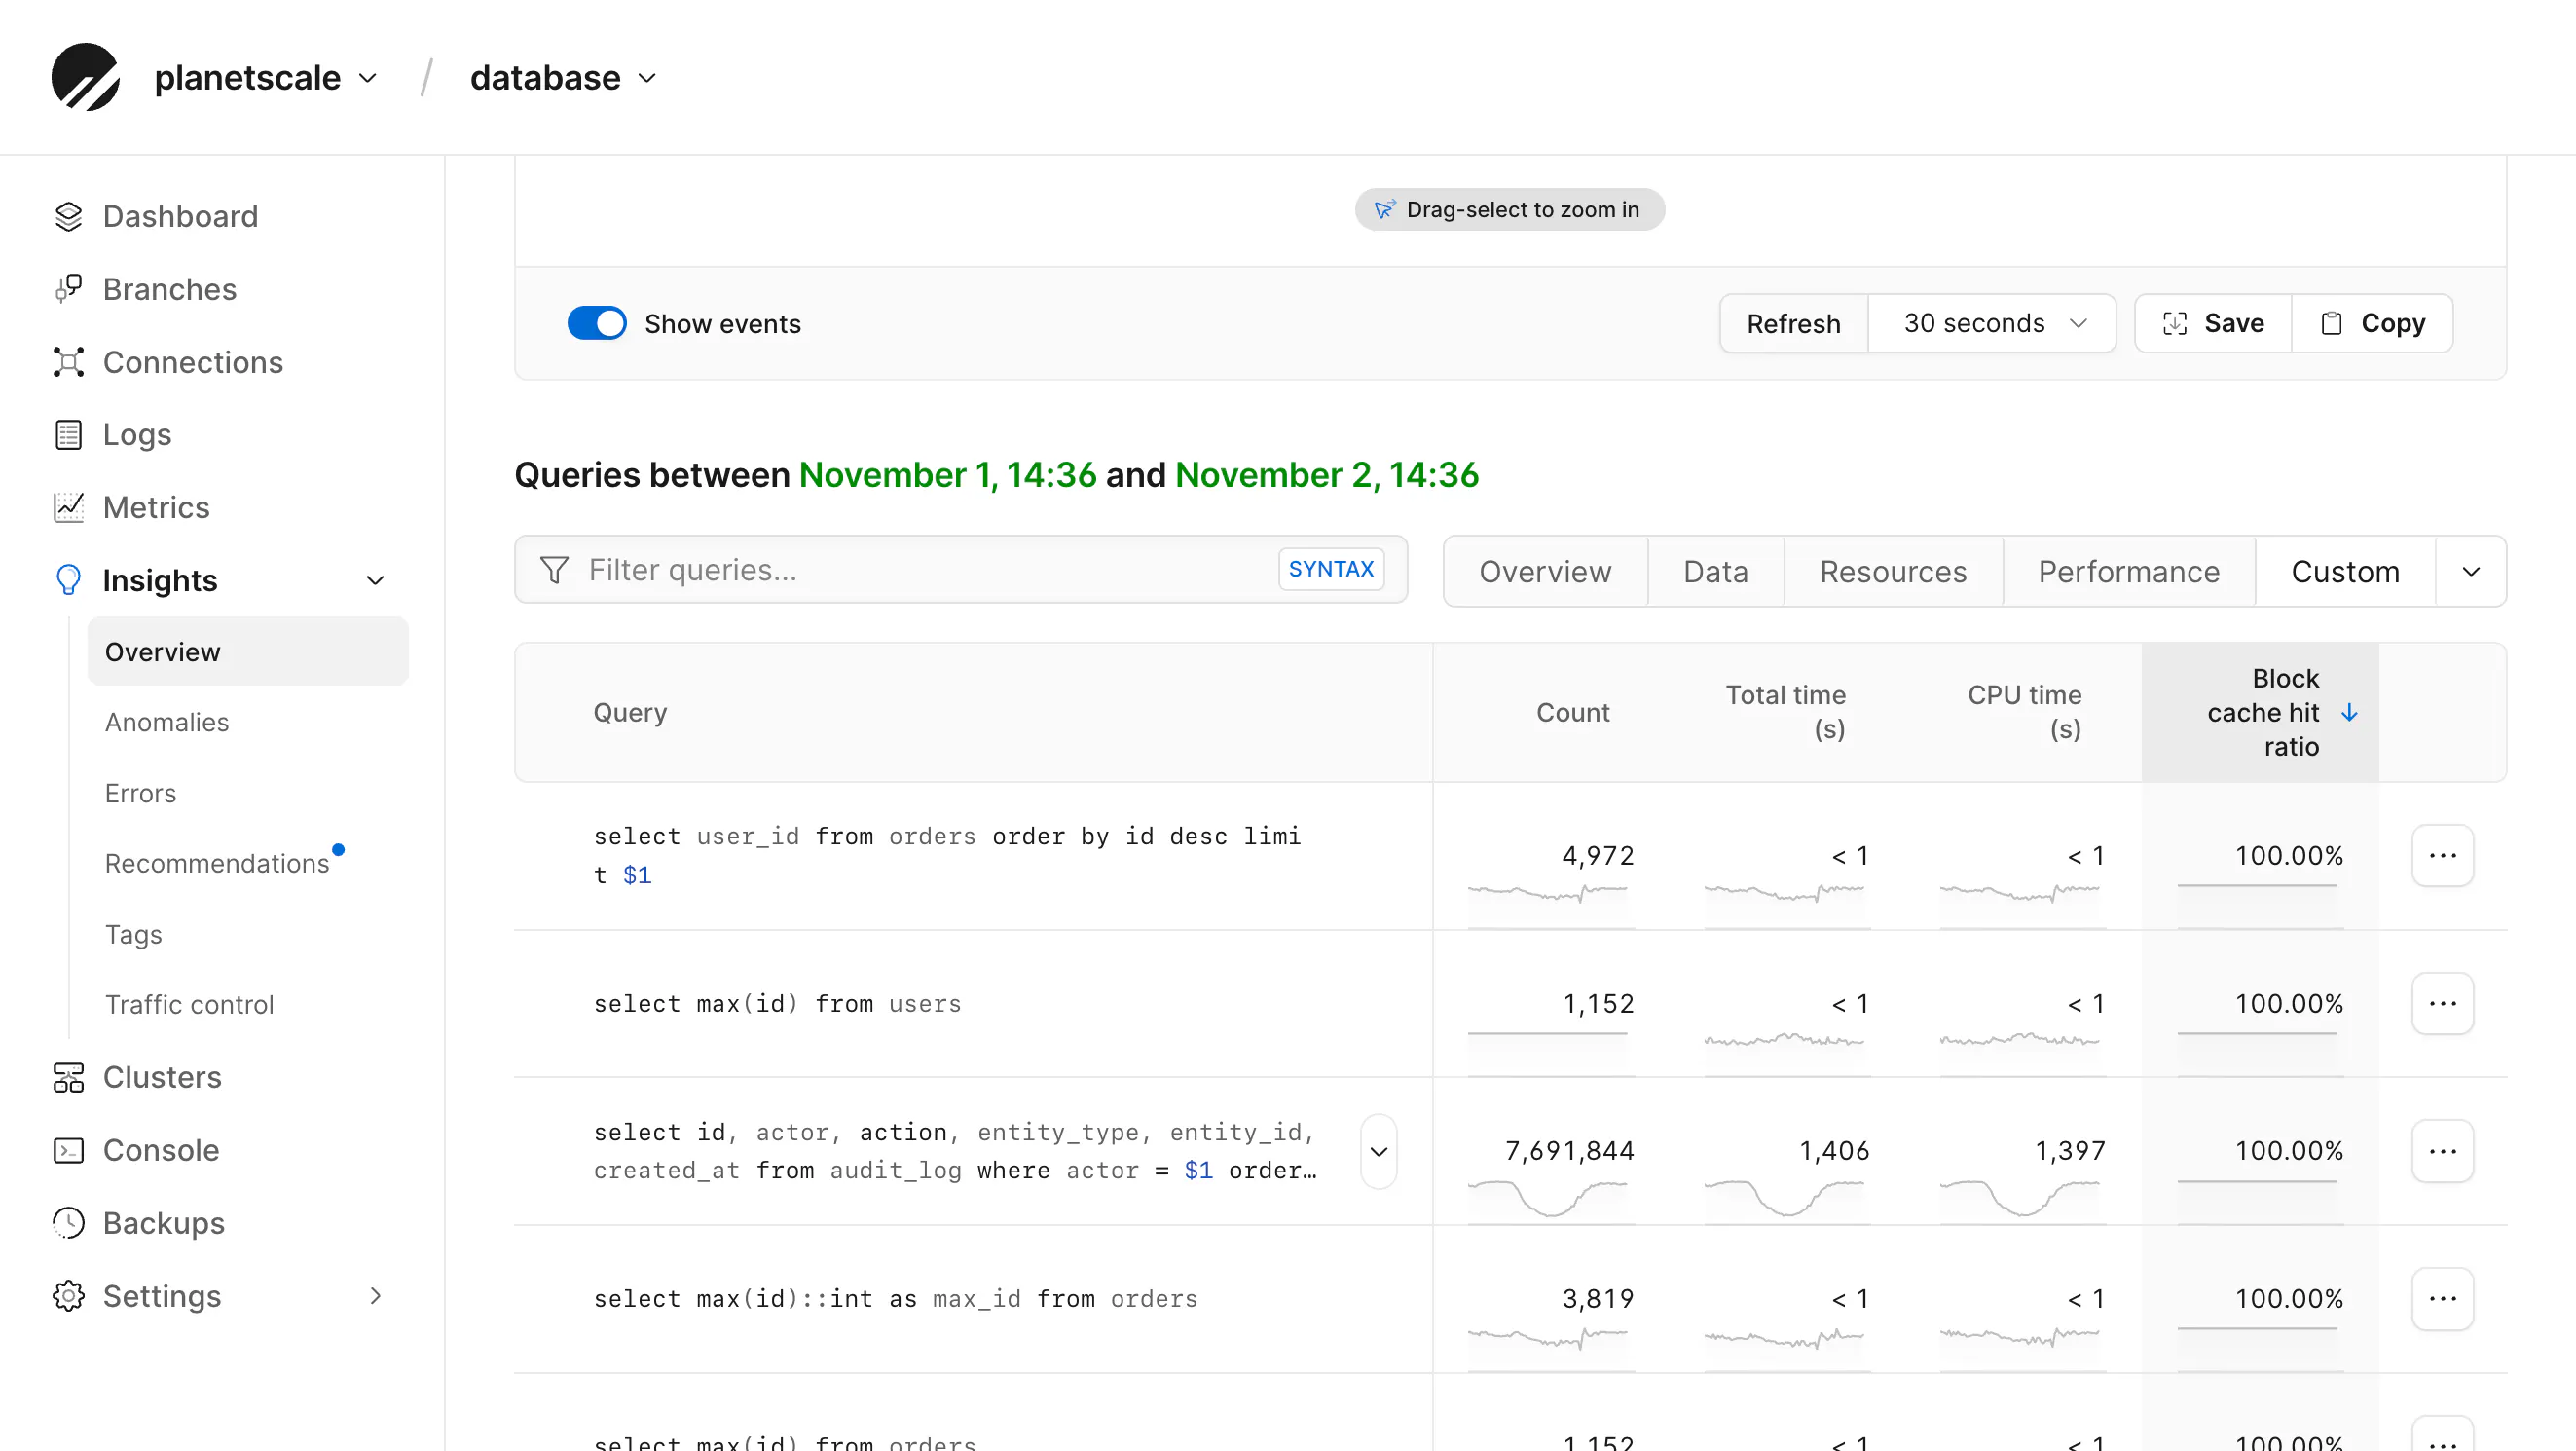
文章明确指出,若大部分读数据能放入内存且写入量低,网络附加存储仍然够用,因为读命中内存就不会走网络。反之,若频繁缓存未命中、数据太大或变化太快放不进内存,或CPU使用率低但延迟高(说明被磁盘读限流),则本地磁盘更合适。PlanetScale Insights可查看缓存命中率。选型应基于实际工作负载特征,而非一味追求本地磁盘。
Q&A
云数据库的隐藏延迟是怎么产生的?
云数据库通常采用网络附加存储(如AWS EBS),存储与计算分离,每次读写都需要经过网络,从而产生隐藏延迟。SSD普及后,网络延迟成为主要瓶颈。
PlanetScale Metal如何保证本地磁盘的数据持久性?
每个Metal数据库集群有一个主库和至少两个副本,每个副本运行在独立VM上,拥有自己的本地NVMe磁盘,并分布在不同的可用区。提交写入时,必须至少有一个副本确认后,主库才向客户端发送确认,确保数据持久性。
本地NVMe磁盘相比网络附加存储有哪些优势?
本地NVMe磁盘消除了存储与计算之间的网络跳转,读取数据时无需经过网络,延迟更低;没有IOPS上限,且成本更低。例如,i7i实例搭配1.8TB本地NVMe磁盘,提供约30万IOPS,月成本551.15美元,而r7i搭配700GB io2卷(1.6万IOPS)月成本1513.82美元。
什么情况下应该考虑使用PlanetScale Metal?
当频繁请求的数据太大或变化太快无法放入内存(导致频繁缓存未命中),或工作负载受限于EBS的IOPS上限时,Metal能消除网络存储往返,提升速度并可能降低成本。此外,如果CPU使用率低但延迟高,说明受磁盘读取限制,迁移到Metal后CPU利用率可能从20-25%提升到80%以上。
PlanetScale Metal的故障转移机制是怎样的?
每个副本都被视为潜在的主库。如果主库发生故障,一个副本会立即被提升为主库。在Vitess上,切换期间查询会被缓冲;在Postgres上,通过PgBouncer缓冲查询,然后定向到新的主库。
网络附加存储在什么情况下仍然足够用?
如果大部分读工作负载能放入内存,且写入量较低,网络附加存储仍然足够用。因为读取直接从内存返回,无需经过网络跳转到EBS,延迟较低。
