构建全新的 GitHub Copilot 内联建议模型:第一部分
内容提要
GitHub Copilot 将 VS Code 内联建议的三个独立模型(补全、下一处编辑、远距离编辑)统一为单一三合一模型,采用 diff patch 输出格式,可一次预测多处编辑并缓存后续补丁,实现快速 tab-tab-tab 体验。团队通过离线评测、试吃、人工评估和在线实验迭代,最终建议显示时间减少 10%,输出 token 减少 61%。
延伸解读
统一模型如何解决多模型编排的痛点
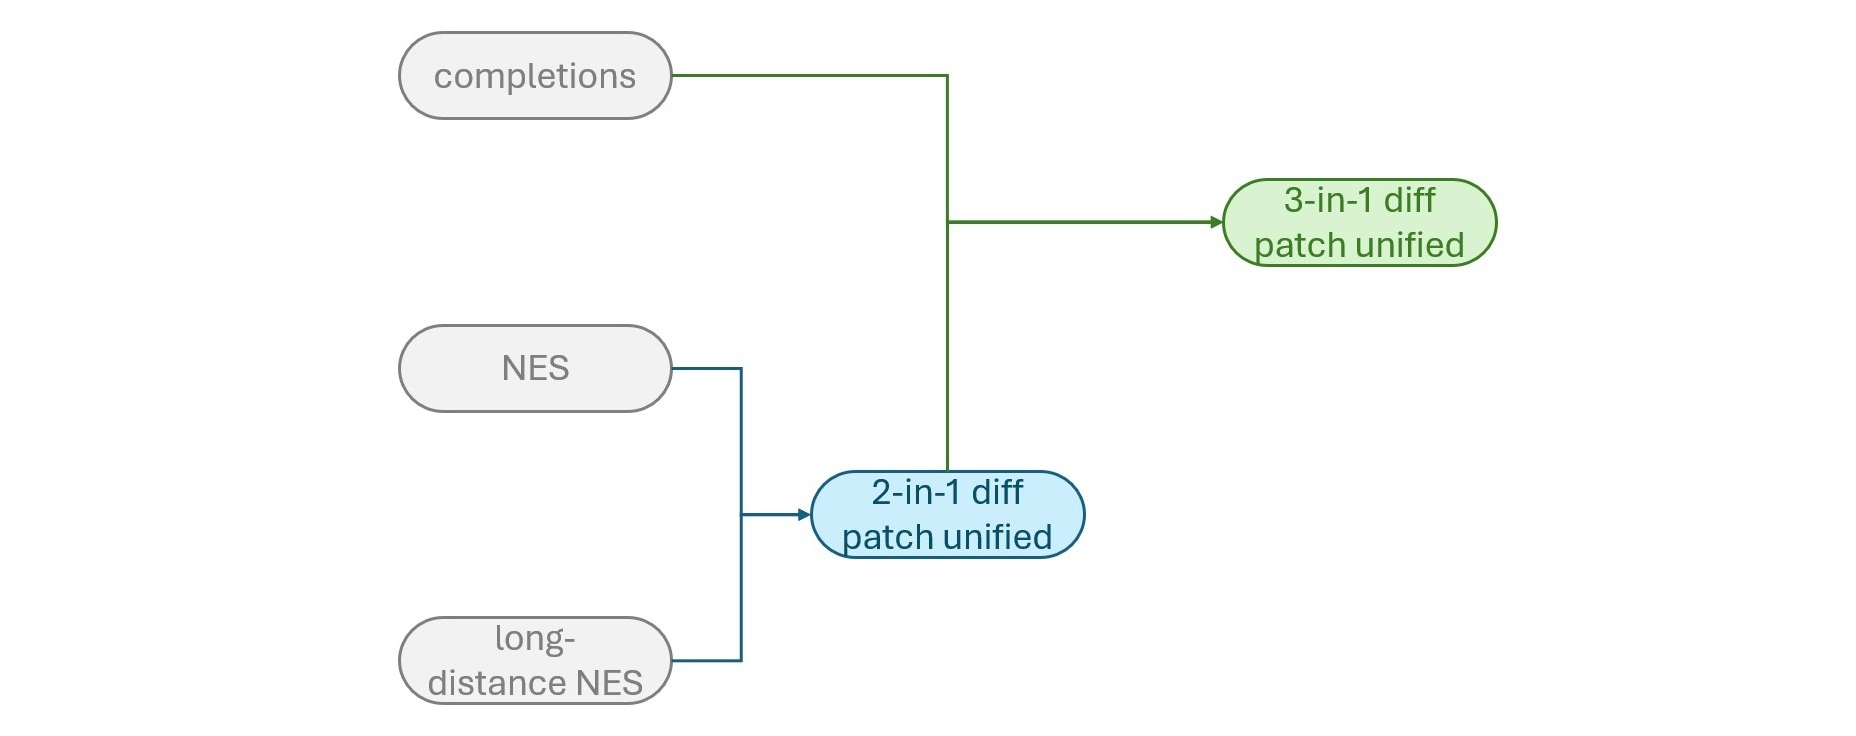
此前 VS Code 内联建议由补全、下一处编辑和远距离编辑三个独立模型分别处理,客户端需按顺序触发,最多可能产生 4 次模型调用。这种编排不仅延迟高,还可能导致建议碎片化或次优。统一为三合一模型后,模型能端到端选择最佳编辑,并一次输出多个 diff patch,从而缓存后续补丁,实现更流畅的 tab-tab-tab 体验。
diff patch 输出格式的设计考量
为让单一模型同时支持补全、局部重写和远距离跳转,团队将输出统一为 diff patch 格式。该格式能紧凑地表达多处编辑,并支持跨文件修改。相比工具调用等通用格式,diff patch 在代码编辑场景下更紧凑且表达力足够。同时,输入上下文也得以简化,仅保留光标位置的三行代码块,并置于提示末尾以优化键值缓存。
离线与在线评估的差距及 POE 基准
团队发现离线基准的高分并不总能预测在线 A/B 测试结果,甚至出现离线最强候选在线表现不佳的情况。为此他们新增了伪在线评估(POE)基准,利用生产中的接受、拒绝和无编辑样本,通过 LLM 裁判判断候选响应是否会被接受。POE 的拒绝率、接受拒绝比等指标成为更可靠的在线性能预测器,帮助更高效地筛选模型候选。
从失败模式中提炼的工程经验
开发中遇到无效补丁和插入位置错误等具体失败模式。团队通过规则过滤、数据挖掘、LLM 修复和 RL 评分器调整来针对性解决。例如,对插入模式传播错误,他们引入辅助评分器并上采样负例。这些经验强调:数据表示、数据平衡和评分器增强同样重要,且狗粮测试能发现离线评估遗漏的问题,QMH 基准则作为快速回归检测的“金丝雀”集。
Q&A
GitHub Copilot 为什么要将三个内联建议模型统一成一个?
统一模型可以让单个模型端到端地为开发者当前工作选择最佳编辑,而不是用程序逻辑在专用模型间选择,从而提升建议质量;同时能一次预测多处编辑并缓存后续补丁,实现更流畅的 tab-tab-tab 体验,还减少了延迟和输出 token。
什么是 diff patch 输出格式?它有什么作用?
diff patch 是一种统一的输出格式,用补丁形式表示代码编辑。它能够同时表达补全、下一处编辑和远距离编辑三种任务,并支持一次输出多个补丁(多补丁响应),从而缓存后续编辑,实现快速连续的 tab-tab-tab 编辑体验。
统一模型后,输入上下文做了哪些简化?
由于任务范围允许在文件任意位置编辑,不再局限于预测特定位置的后缀或重写固定窗口,因此移除了原来的“待编辑区域”和“待编辑代码”两部分输入,替换为包含当前光标位置行号和文件内容的单个 3 行块。同时,为了优化键值缓存,光标位置部分仍保留在提示末尾。
团队如何评估统一模型的质量?
团队采用四个互补的评估阶段:离线评估判断候选是否值得测试;试吃(dogfooding)获得真实工作流中的第一手感受;人工评估量化试吃体验并提供结构化反馈;在线实验验证完整系统是否比现有生产设置创造价值。此外还开发了伪在线评估(POE)和定性必备项(QMH)等基准。
统一模型在性能上取得了哪些具体提升?
最终发布的候选模型在关键指标(接受率、拒绝率、显示率、重复参与度和累积保留字符)上没有统计显著的回退,同时建议显示时间减少了 10%,输出 token 减少了 61%。
在开发统一模型过程中遇到了哪些挑战?如何解决?
主要挑战包括:无效补丁(如代码重复、无操作补丁)和插入模式传播中的位置错误(正确内容放错位置)。团队通过基于规则的质量过滤器、LLM 作为评判者、针对性数据挖掘与修复、在 RL 中上采样负例、以及引入辅助评分器等技术逐步解决了这些问题。
