


摩尔线程正式开源音频理解大模型MooER
内容提要
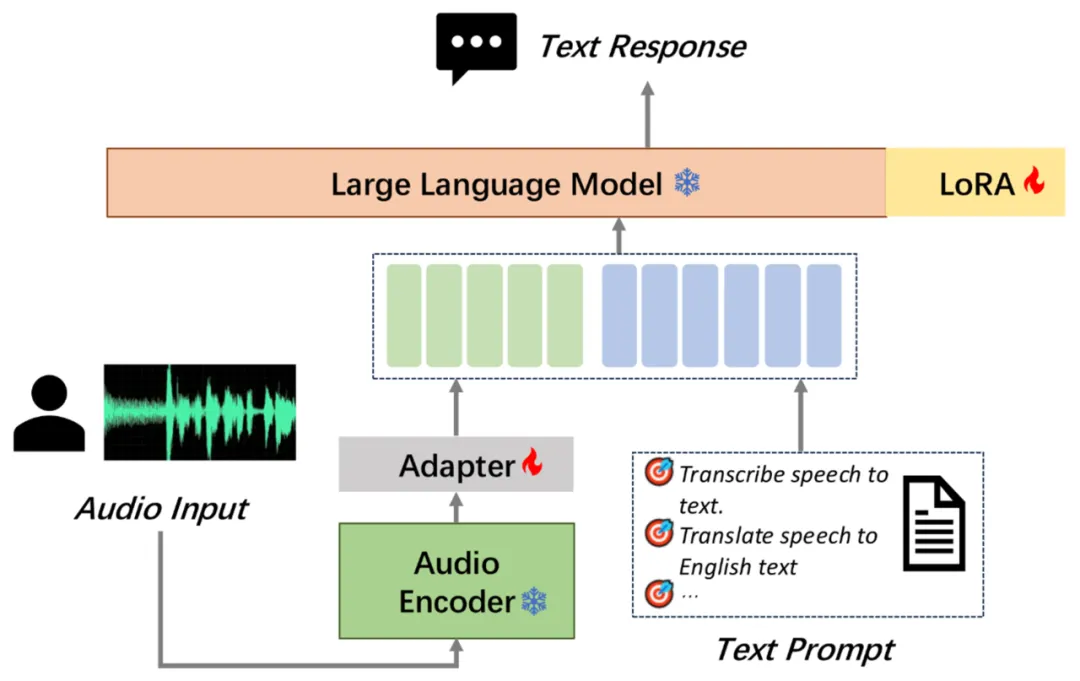
摩尔线程开源了音频理解大模型MooER,支持中英文语音识别和中译英语音翻译。MooER-5K在测试中表现优异,特别是在Covost2中译英测试集上,BLEU分数达到25.2。模型结构包括Encoder、Adapter和Decoder三个部分。训练过程中使用了自研的夸娥智算平台和DeepSpeed框架。MooER与其他开源模型相比效果更优。文章提供了一些有关Encoder选择、音频建模粒度和快速适应到目标垂类的建议。
延伸解读
国产GPU训练与效率
MooER是首个基于国产全功能GPU训练和推理的开源语音大模型,依托摩尔线程夸娥智算平台,仅用38小时完成5000小时音频数据和伪标签的训练。这展示了国产算力在大模型训练中的可行性,为开发者提供了除国际主流硬件外的选择。
模型架构与训练策略
MooER采用Encoder、Adapter和Decoder三部分结构,使用Paraformer和Qwen2-7B-instruct初始化,训练时固定Encoder,仅更新Adapter和LLM。通过LoRA技术仅更新2%的LLM参数,既加速收敛又提升效果,为资源有限的团队提供了高效微调范例。
性能表现与对比
在六个中文测试集上,MooER-5K的CER为4.21%,英文WER为17.98%,优于或持平其他开源模型。中译英测试集BLEU达25.2,接近工业水平。基于8万小时数据的MooER-80k进一步将CER降至3.50%,WER降至12.66%,显示数据规模对性能的显著提升。
实践建议与适用场景
文章建议选择有监督训练的Encoder如Paraformer,音频建模粒度选120ms,并指出仅用140-150小时英文数据即可适应新领域,迁移到语音翻译效果良好。这些经验适用于小语种、方言等低资源任务,为开发者快速适配垂类提供了参考。
Q&A
MooER模型的主要功能是什么?
MooER模型支持中英文语音识别和中译英的语音翻译。
MooER在Covost2测试集上的表现如何?
MooER-5K在Covost2中译英测试集上取得了25.2的BLEU分数,表现优异。
MooER的模型结构包含哪些部分?
MooER的模型结构包括Encoder、Adapter和Decoder三个部分。
MooER的训练数据来源是什么?
MooER的训练数据MT5K由部分开源数据和内部数据构成,伪标签未经过人工筛选。
MooER与其他开源模型相比有什么优势?
MooER在CER和WER指标上表现突出,效果更优或几乎持平于其他开源模型。
如何提高MooER模型的训练效率?
采用LoRA技术更新LLM参数可以加快训练收敛并提升效果。
