

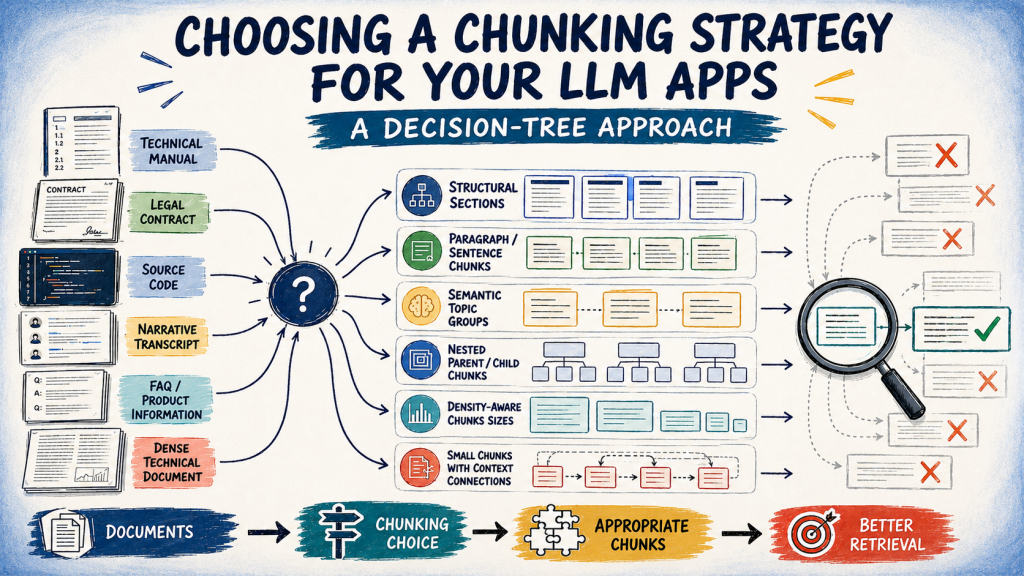

为你的LLM应用选择分块策略:一种决策树方法
内容提要
本文介绍RAG系统的分块策略选择,提出六问决策树:文档是否需分块、有无清晰结构、是否需跨段上下文、信息密度是否不均、质量是否优先于成本、语料是否异构。据此匹配固定大小、递归、基于文档、语义、晚期、自适应、层次、LLM及智能体等策略,并识别分块不当的常见症状与修复方法。
延伸解读
分块策略选择的核心逻辑
文章强调,分块策略的选择应基于文档结构和检索任务的具体需求,而非默认使用熟悉的方法。通过六问决策树,可以系统性地评估文档是否需要分块、是否具有清晰结构、是否需要跨段上下文、信息密度是否均匀、质量与成本的权衡以及语料是否异构,从而匹配最合适的策略。这种结构化方法有助于避免因分块不当导致的检索失败。
常见分块陷阱与修复信号
文章列举了分块策略在实际应用中可能出现的症状,如块在句子或表格中间被切断、语义分块产生不一致的块数量、基于文档的分块块大小差异过大等。这些症状通常指向策略与文档结构不匹配或参数设置不当。修复方法包括切换到递归分块、调整相似度阈值、结合递归处理超大章节,或回退到更简单的策略。识别这些信号有助于及时调整分块方案。
成本与质量的权衡
决策树中的第五个问题引导读者在检索质量与成本、延迟之间做出选择。如果质量优先且预算允许,可使用LLM-based分块;若质量重要但成本受限,语义分块是折中方案;若速度与成本优先,则递归或固定大小分块更合适。文章指出,高级策略在匹配文档时能提升效果,否则只会增加开销而无益于检索。
Q&A
为什么RAG系统中分块策略的选择如此重要?
分块边界直接影响检索质量。边界不当可能导致检索遗漏回答问题的段落,或返回技术上相关但缺乏必要上下文的块。当边界保留了正确的上下文,嵌入、向量搜索和生成就有更好的基础;当边界破坏了重要上下文,重排序和提示调优也无法完全恢复。
六问决策树具体包含哪些问题?
决策树包含六个问题:1. 文档是否需要分块?2. 文档是否有清晰的内部结构?3. 块是否需要文档其他部分的上下文?4. 信息密度是否变化,或是否需要多个粒度级别?5. 检索质量是否比成本和延迟更重要?6. 是单一文档类型还是异构集合?
对于有清晰内部结构的文档,应该选择哪种分块策略?
如果文档有可靠的结构(如Markdown标题、HTML元素、PDF章节、代码函数等)且映射到逻辑内容单元,应使用基于文档的分块。该策略根据格式解析文档,保持章节、段落、表格、函数等结构元素在一起。
晚期分块(Late Chunking)适用于什么场景?
晚期分块适用于块需要文档其他部分上下文的情况,例如法律合同在第一节定义术语并在第八节使用,或技术规范术语只有结合前文才能理解。它先用长上下文模型嵌入整个文档,然后从该结果派生块级嵌入,使每个块仍携带整个文档的痕迹。
当检索质量比成本更重要时,应该选择什么分块策略?
如果检索质量是优先考虑且预算支持对每个文档进行一次模型调用,使用基于LLM的分块来识别逻辑断点或原子命题。如果质量仍然重要但每个文档的模型调用成本太高,且主题变化不可预测,则使用基于句子嵌入距离的语义分块。
分块不当的常见症状有哪些?如何修复?
常见症状及修复:1. 块经常在句子或表格中间切断——改用递归分块而非扩大重叠;2. 语义分块在相似文档上产生不一致的块数量——收紧相似度阈值或回退到LLM边界;3. 基于文档的块从一行到几页不等——结合文档分块与递归处理超大章节;4. 层次或自适应分块增加延迟但未改善答案——回退到递归分块;5. 智能体分块超出计算预算——缓存策略决策或在集合级别运行分析。
