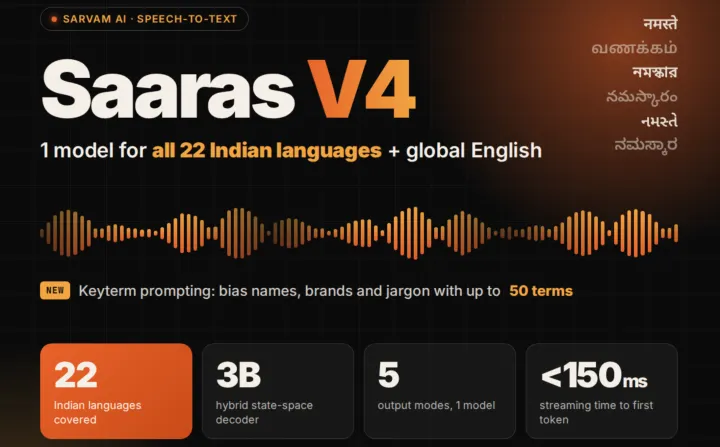

Sarvam AI 发布 Saaras V4:面向全部 22 种印度语言和全球英语的语音转文字模型
内容提要
Sarvam AI 发布语音识别模型 Saaras V4,覆盖 22 种印度法定语言及全球英语口音,宣称均达最先进准确率。模型采用编码器-解码器架构,解码器为自研 30 亿参数混合状态空间模型。支持 5 种输出模式、最多 50 个关键词提示,流式首 token 时延低于 150 毫秒,定价 ₹30/小时。目前仅 API 可用,权重未公开,自托管仅支持 v3。所有数据均为厂商自报,尚无独立复现。
延伸解读
自托管限制与部署考量
Saaras V4 目前仅通过 API 提供,模型权重未公开,自托管文档仍只覆盖 v3。这意味着对数据隐私或本地部署有要求的企业,暂时无法在自有基础设施上运行 V4,只能依赖 Sarvam 的云服务。若必须自托管,可继续使用 v3,但会错过 V4 在语言覆盖和关键词提示上的改进。
关键词提示的实用细节
关键词提示是 V4 新增能力,最多支持 50 个词条,每条最长 64 字符,且仅对识别产生偏置,不保证一定输出。当品牌名如 PhonePe 需要保持拉丁字母时,应使用 codemix 模式。在 IndicContextEval L5 设置下,V4 报告了 16.03% 的 WER,但该结果同样为厂商自报。
定价与竞品对比
Sarvam 列出语音转文字价格为实时、流式与批处理 ₹30/小时,带说话人分离为 ₹45/小时。对比竞品,Deepgram Nova-3 多语言预录音频为 $0.0052/分钟,ElevenLabs Scribe v2 批处理为 $0.22/小时,OpenAI GPT-4o Transcribe 约 $0.006/分钟。V4 在印度语言覆盖上明显更广,但实际成本需结合汇率和使用量评估。
基准数据的可信度
文章强调所有性能数字均为厂商自行报告,尚无独立复现结果。英语评测基于 7 个数据集,印度语言使用 Vistaar 和 Kathbath Noisy,语种识别错误率在 IndicVoices 上为 2.9%(前 10 种语言)和 5.22%(全部 22 种)。读者在采纳这些指标时,应留意其未经第三方验证,实际表现可能因音频条件而异。
Q&A
Saaras V4 支持哪些语言?
Saaras V4 覆盖全部 22 种印度法定语言以及英语,并且现在纳入了全球各地的英语口音。
Saaras V4 的模型架构是什么?
Saaras V4 是一个编码器-解码器系统。音频编码器把波形转换为携带音素与声学细节的嵌入向量,然后通过时间下采样适配器缩短序列并投影到语言模型的嵌入空间。解码器是 Sarvam-3B,一个 30 亿参数的混合状态空间语言模型,由 Sarvam 内部从零训练。
Saaras V4 的定价是多少?
Sarvam 列出语音转文字的价格为实时、流式与批处理 ₹30/小时,带说话人分离为 ₹45/小时。
Saaras V4 支持哪些输出模式?
支持 5 种输出模式,通过 mode 参数选择:transcribe(默认,原生文字,数字与日期已归一化)、verbatim(逐字保留所说内容,包括语气词和口语数字)、codemix(原生文字,英文单词保留英文)、translit(整段内容用拉丁字母转写)、translate(英文翻译,数字已归一化)。
Saaras V4 的关键词提示功能有什么限制?
关键词提示是 V4 新增的能力,且仅在 saaras:v4 下可用。你在 keyterms 下传入一个 JSON 列表,最多 50 个词条,每条最长 64 个字符。关键词会对识别产生偏置,但不保证一定输出。当 PhonePe 这类品牌名必须保持拉丁字母时,请使用 codemix 模式。
Saaras V4 的流式延迟和部署方式如何?
流式通过 WebSocket 实现,带部分结果,首 token 时延低于 150 毫秒。REST 针对最长 30 秒的片段做同步转写。批处理为异步任务,单文件最长 2 小时,可选说话人分离。SDK 支持 Python 3.9+ 和 Node.js 18+,另有 LiveKit Agents、Pipecat 和 Vercel AI SDK 集成。目前仅 API 可用,模型权重未公开,自托管仅支持 v3。
