


profile a deep learning model
内容提要
本文讨论了程序性能分析的方法,包括计时、内存分析和使用工具。还介绍了评估深度学习模型性能的方法,包括计算量和参数量的计算。提供了FlopCountAnalysis、torch profiler和deepspeed等工具和代码示例。同时介绍了thop和stat等其他工具。
延伸解读
性能分析时机:避免过早优化
文章强调“过早的性能分析是万恶之源”,建议先完成程序基本功能再进行优化。这一原则在深度学习模型开发中同样适用,因为过早关注计算量和参数量可能阻碍模型结构的快速迭代。读者应在模型功能稳定后,再使用工具进行细致的性能剖析,以平衡开发效率与优化效果。
计算量与参数量:理解模型复杂度
计算量(FLOPs)对应时间复杂度,影响模型执行时间;参数量对应空间复杂度,决定显存占用。文章指出,量化可降低参数量并简化计算,因为整数运算比浮点运算更高效。理解这两者有助于在部署时权衡速度与内存,例如选择量化模型以减少资源消耗。
工具选择:应对不同分析场景
文章介绍了多种工具:fvcore的FlopCountAnalysis可计算FLOPs和参数量,torch profiler用于收集训练和推理指标,deepspeed适用于大模型训练。对于输入为list或dict的模型,thop可避免修改模型结构。读者应根据模型类型和分析需求选择工具,例如简单模型用fvcore,复杂输入用thop。
时间测量:精度与显存考量
测量模型运行时间时,直接使用time.time()可能因显存不足或同步问题而不准确。文章推荐使用torch.cuda.Event进行精确测量,并包含预热步骤。在显存充足时,time.time()结果可能与cuda.Event类似,但后者能更可靠地反映GPU时间,尤其适合性能基准测试。
Q&A
如何进行程序性能分析?
程序性能分析应在基本功能完成后进行,使用计时、内存分析等工具,需区分真实时间、用户时间和系统时间。
深度学习模型的性能评估需要考虑哪些因素?
评估深度学习模型性能时需考虑计算量和参数量,这影响GPU/CPU和内存使用。
什么是FLOPs,如何计算?
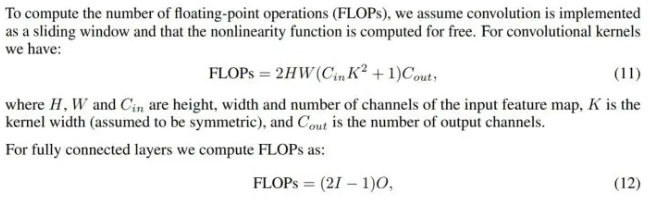
FLOPs表示浮点运算次数,通常用于计算模型的计算量,涉及浮点数和整数运算的不同。
有哪些工具可以用于深度学习模型的性能分析?
常用的工具包括FlopCountAnalysis、torch profiler和deepspeed等。
如何计算模型的参数量?
模型的参数量可以通过计算模型中可训练参数的数量来获得,通常以MB为单位表示。
如何使用PyTorch Profiler进行性能分析?
使用PyTorch Profiler可以在训练和推理期间收集性能指标,帮助识别最耗时的操作。
