

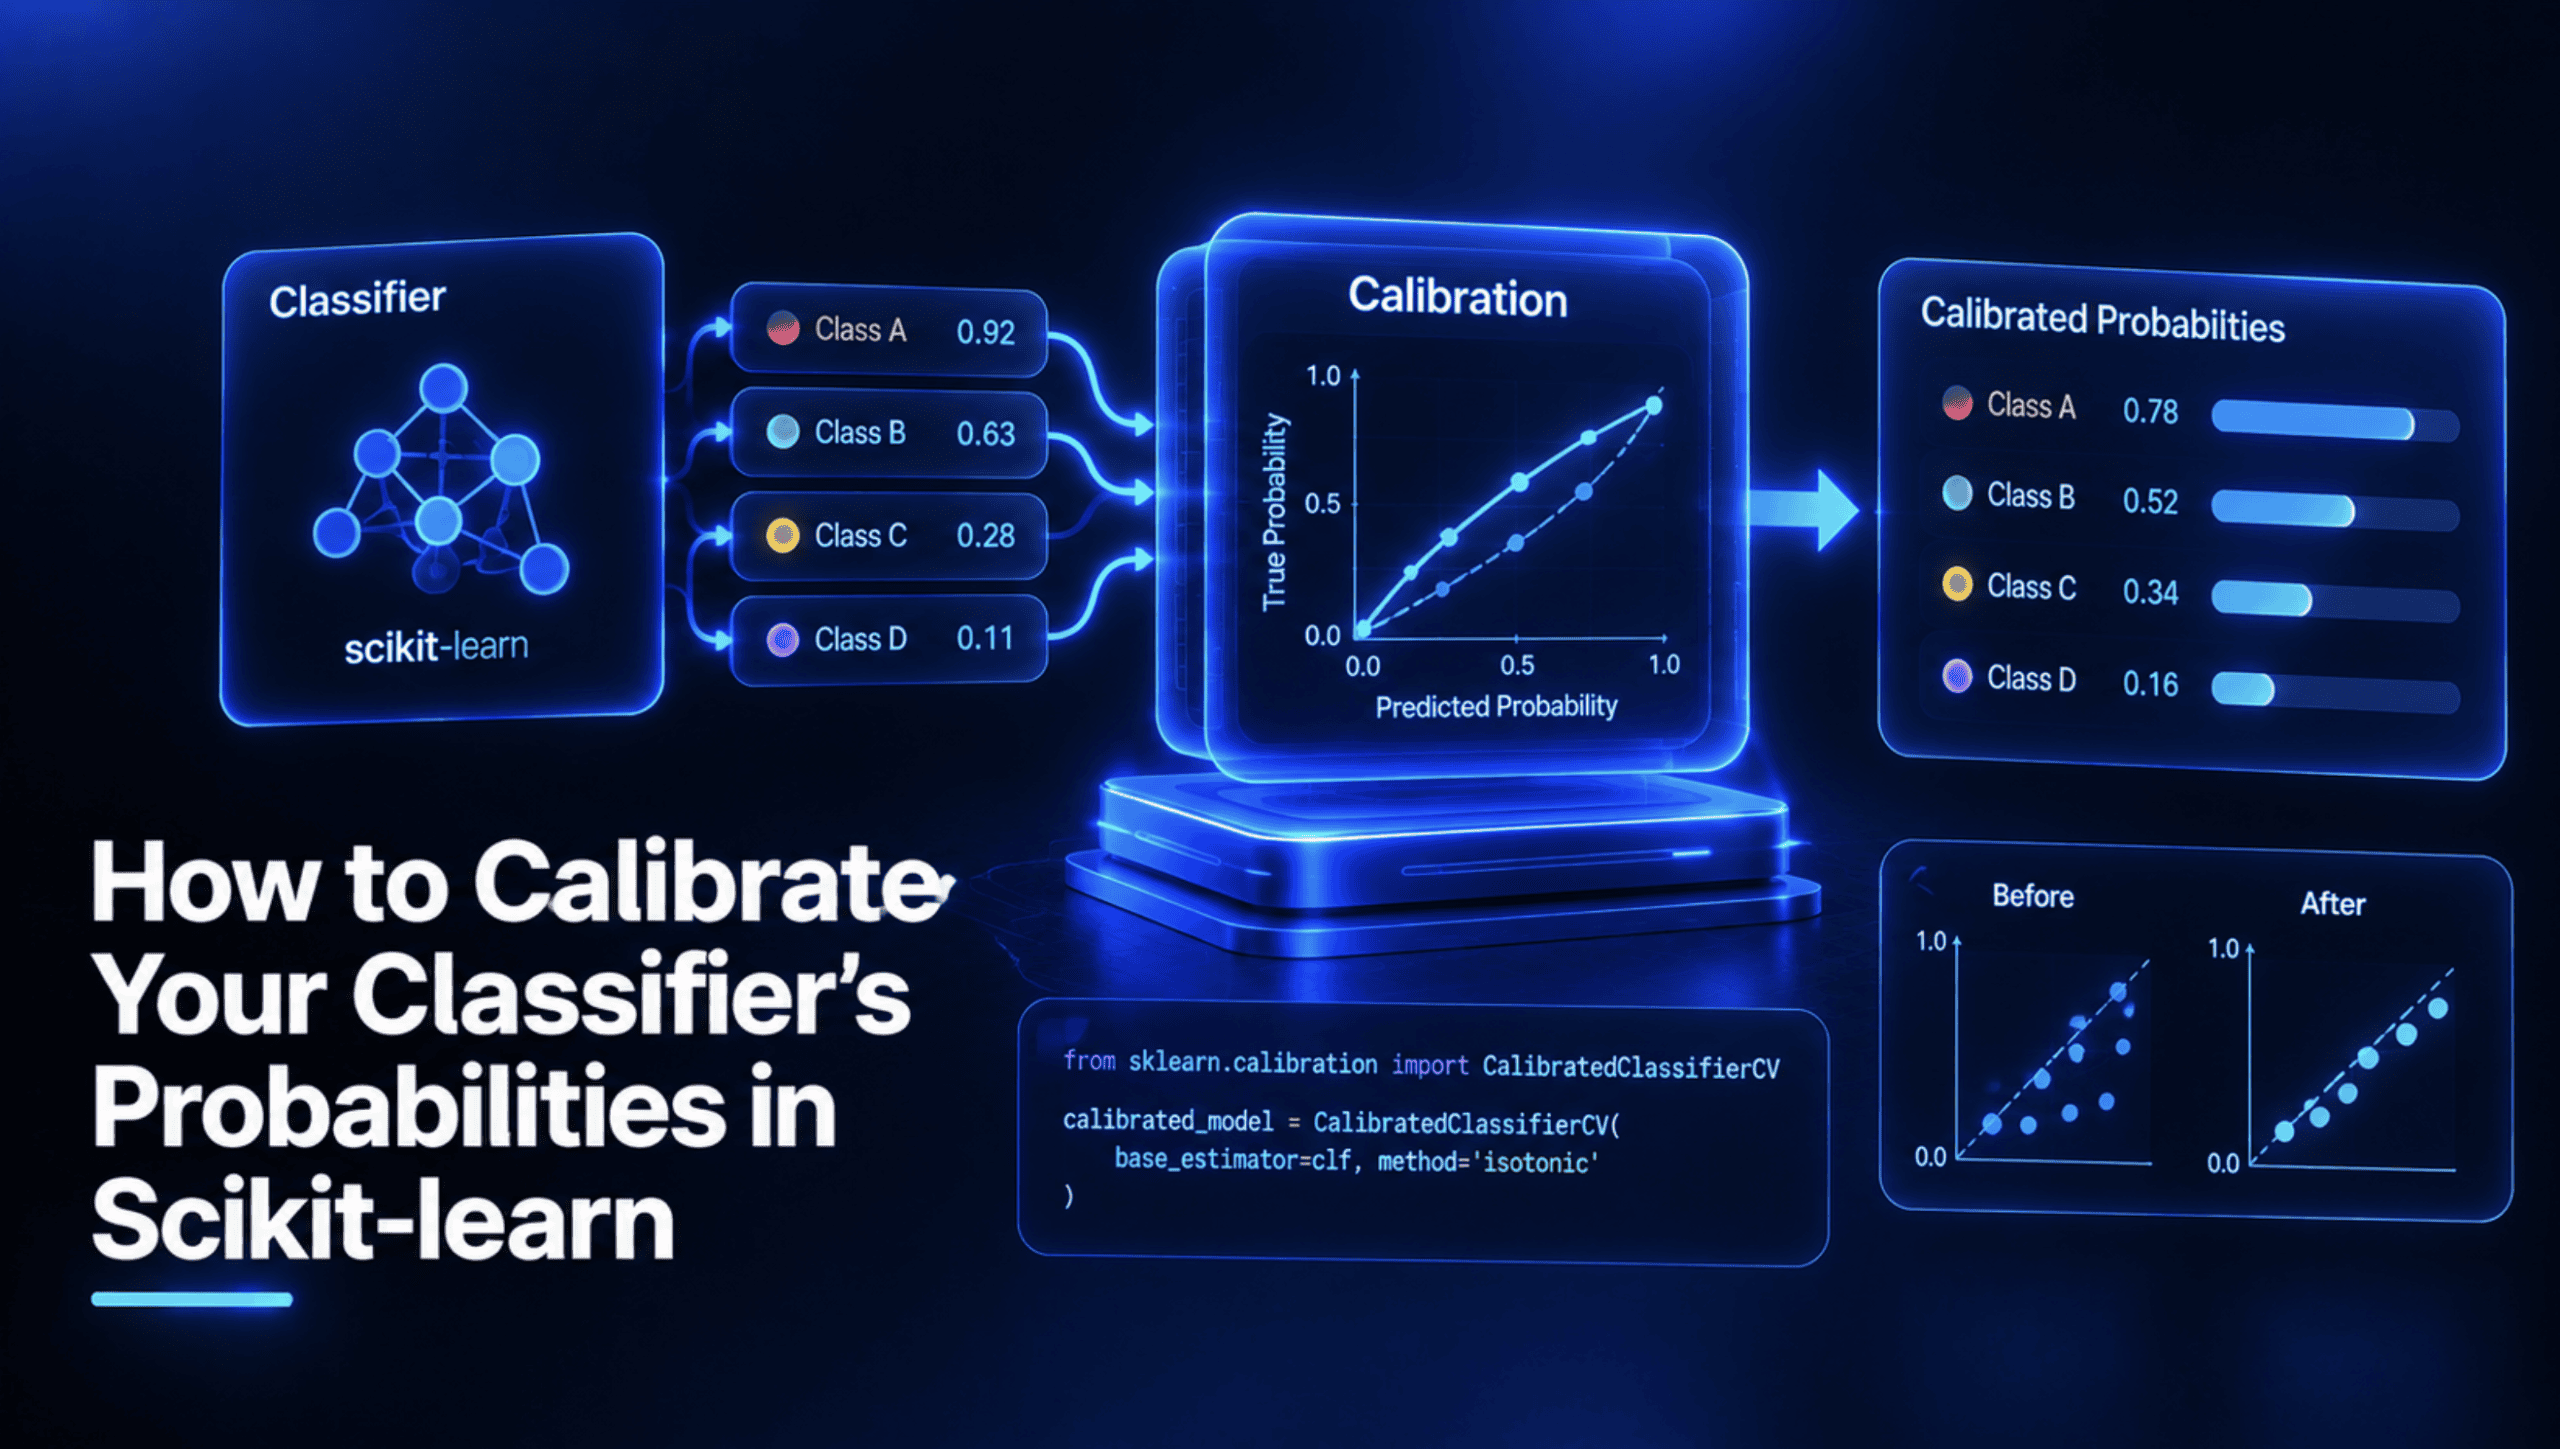

如何在Scikit-learn中校准分类器的概率
内容提要
本文介绍分类器概率校准:模型输出的0.9并不必然代表90%的真实概率。作者用Covertype数据训练朴素贝叶斯和随机森林,通过可靠性图和Brier分数展示校准偏差,并用Platt缩放(sigmoid)与等渗回归进行修正。校准集应独立于训练集;样本少于约1000时宜用sigmoid,更多时可用等渗回归。校准后ROC-AUC基本不变。
延伸解读
校准集必须独立:数据划分的关键
文章强调校准器必须用独立于训练集的数据拟合,否则模型在训练数据上过于自信,校准器会学到偏向0和1的概率。示例采用50%训练、20%校准、30%测试的三路划分,并用stratify保持类别比例。这提醒读者:若直接在校准集上训练模型,校准结果会失真,评估也不可信。
Platt缩放与等渗回归:如何选择
Platt缩放只学习两个参数,不易过拟合,且保持预测排序,适合校准样本少于约1000或需要ROC-AUC完全不变的情况。等渗回归更灵活,能修正任意单调扭曲,但需要足够数据(约1000以上),且会产生并列预测值,可能轻微改变ROC-AUC。文章建议样本多时尝试等渗并对比sigmoid。
校准后ROC-AUC基本不变,但Brier分数需谨慎解读
文章指出校准主要改善概率含义,不改变模型排序能力,因此Platt缩放后ROC-AUC与原始完全一致,等渗回归仅因并列值有微小差异。Brier分数同时混合校准与区分能力, lower不一定代表校准更好,所以应结合可靠性图判断,而非只看单一指标。
没有额外校准数据时的交叉验证方案
若无法划出独立校准集,可将未拟合的模型传给CalibratedClassifierCV并设置cv=5。它会在每折上训练模型副本,并用剩余数据拟合校准器,预测时平均五折结果,确保校准器未见其对应分类器的训练数据。这为数据紧张的场景提供了可行替代,但需注意其计算成本与数据利用方式。
Q&A
为什么分类器输出的概率需要校准?
模型输出的概率(如0.9)并不必然代表真实概率(90%)。模型可能排序能力好但置信度判断差,校准可以缩小预测概率与真实概率之间的差距,使predict_proba可被解读为置信水平。
在scikit-learn中如何用可靠性图和Brier分数诊断概率校准问题?
可靠性图(校准曲线)将预测概率分箱,横轴为平均预测概率,纵轴为实际正例比例,完美校准应落在对角线上。Brier分数是概率与真实结果之间的均方误差,越低越好,但它混合了校准与区分度,需结合可靠性图一起看。
Platt缩放和等渗回归有什么区别?分别适用于什么场景?
Platt缩放(sigmoid)拟合一个逻辑曲线,仅两个参数,不易过拟合,保持排序不变,适合小校准集(少于约1000样本)或需要ROC-AUC不变的情况。等渗回归拟合单调分段函数,更灵活但易过拟合,适合校准集较大(约1000以上)时,但可能产生并列预测导致ROC-AUC微变。
使用CalibratedClassifierCV时,为什么需要独立的校准集?如何实现?
校准器必须在独立于训练集的数据上拟合,否则模型在训练数据上过于自信,导致校准后概率仍偏向0和1。实现方式是将数据分为训练集、校准集和测试集,用训练集训练模型,用校准集拟合校准器,测试集仅用于最终评估。
校准后模型的ROC-AUC会变化吗?
Platt缩放是单调变换,因此ROC-AUC与校准前完全一致。等渗回归可能产生并列预测,导致ROC-AUC在最后几位数字上略有变化。如果必须保持排序完全不变,应使用sigmoid方法。
如果没有额外的校准数据,scikit-learn如何自动进行交叉验证校准?
可以使用CalibratedClassifierCV并设置cv参数(如cv=5),传入未拟合的模型。它会在每个折上训练模型副本并在剩余数据上拟合校准器,预测时平均五个结果,从而避免校准器看到其对应分类器的训练数据。
