


如何选择嵌入模型:评估与权衡
内容提要
选择嵌入模型需综合评估:确认支持的语言与分词器,避免未知字符被替换为UNK;根据任务类型、序列长度、模型大小和优化支持筛选;构建领域内真实数据集,用precision@k、MRR、NDCG等指标评测;生产环境需权衡吞吐、延迟与成本,自托管或API各有取舍;最终结合业务需求做多目标优化,并随应用演进灵活更换模型。
延伸解读
分词器与UNK:被忽视的质量杀手
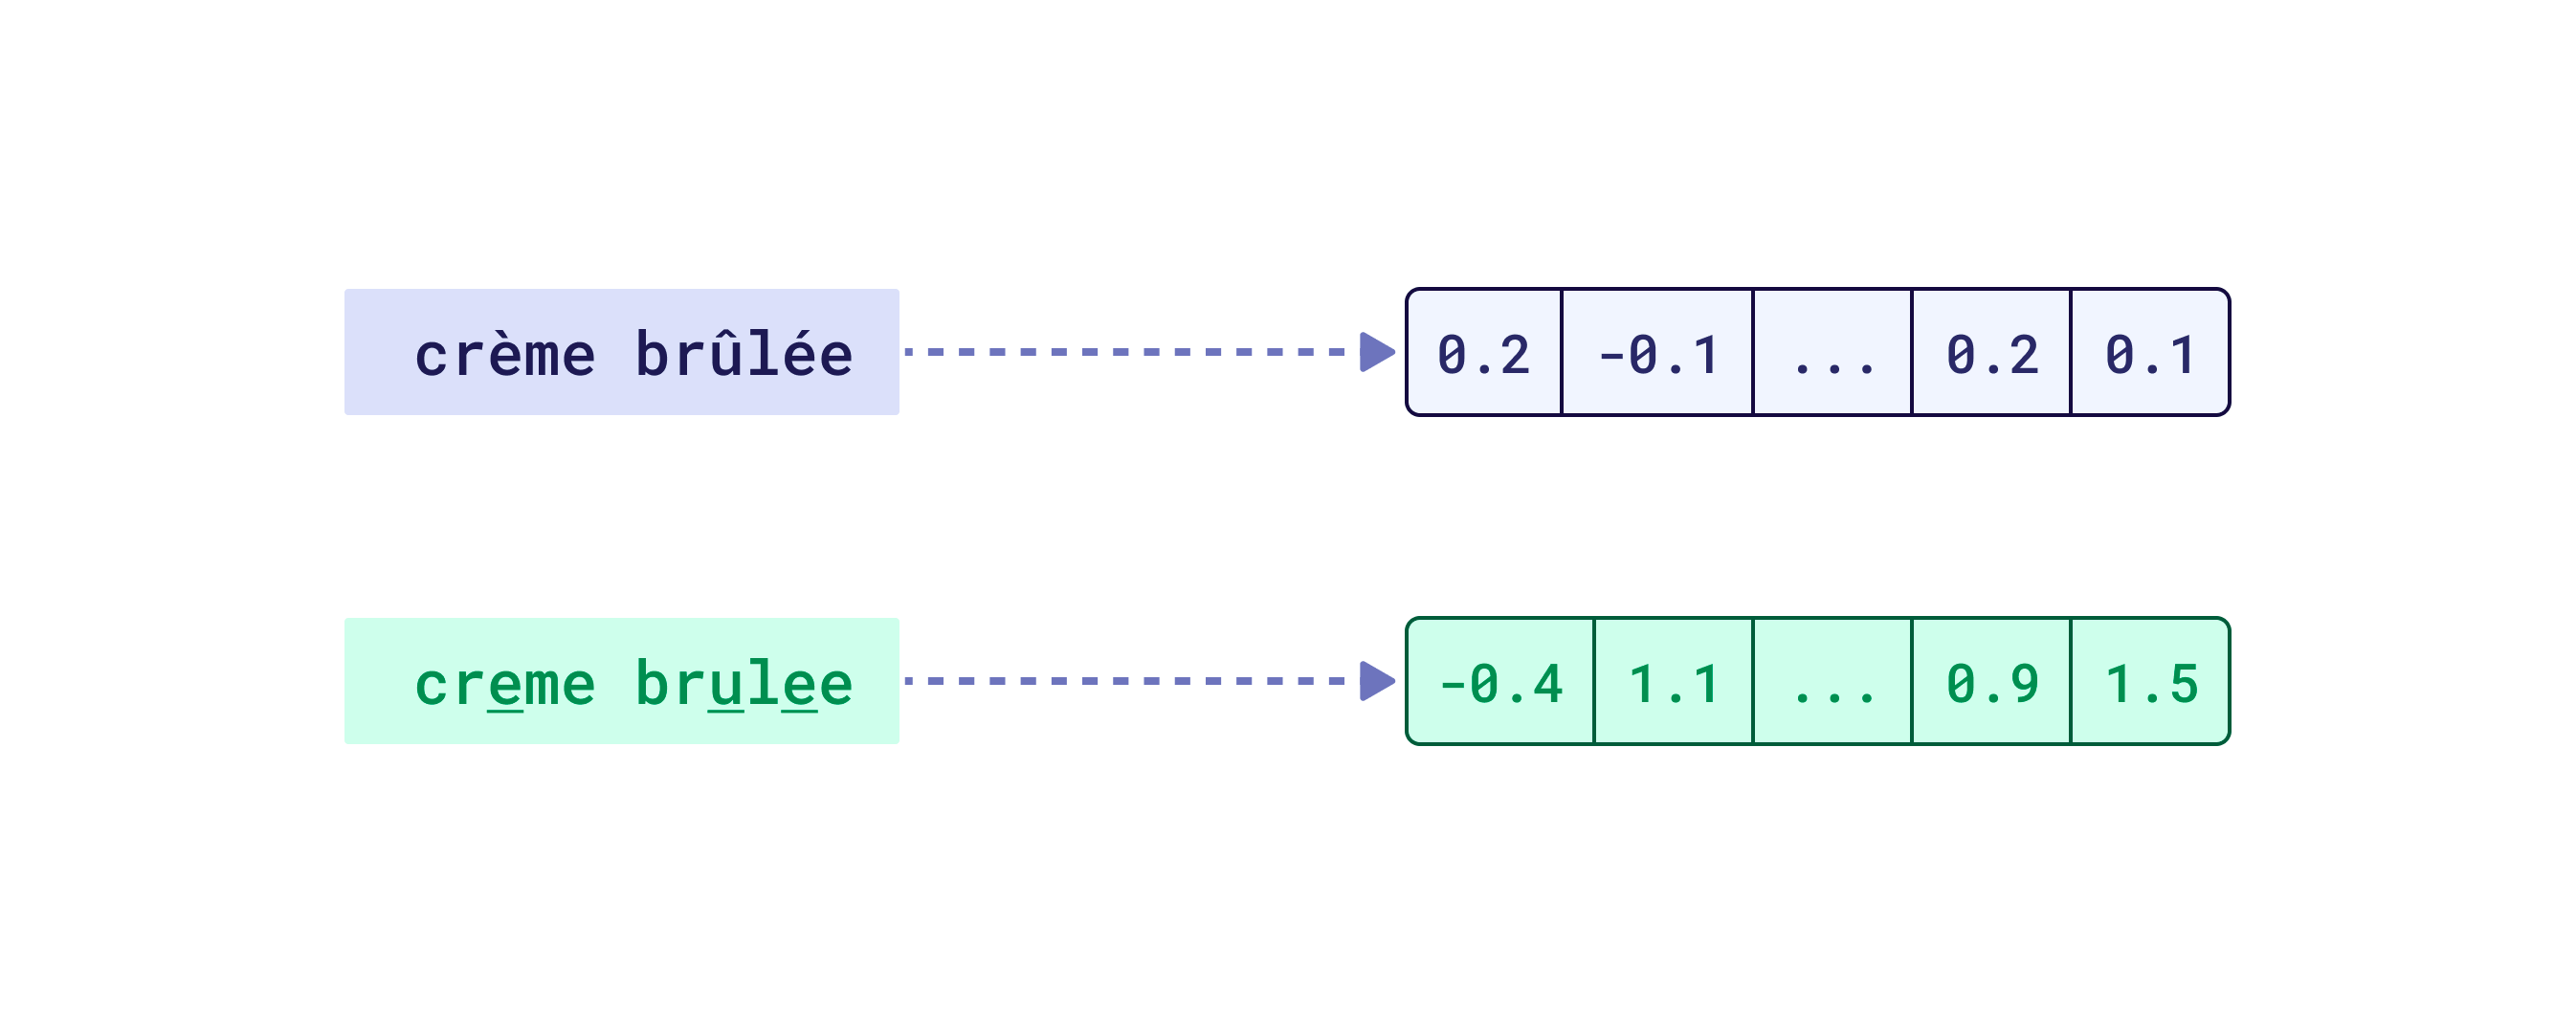
文章强调,嵌入模型的分词器决定了其能理解的字符范围。训练中未见的字符会被替换为UNK标记,导致语义失真,甚至使矛盾句子在向量空间中高度相似。评估时,可单独运行分词器检查目标语言字符是否被正确处理,或通过修改文本观察相似度变化。对于商业模型,可参考OpenAI、Cohere等公开的分词器。这一环节常被忽略,却直接影响嵌入质量。
构建领域内真实数据集:小规模起步
公开基准如MTEB难以代表特定领域数据,因此需自建真实数据集。根据任务类型设计结构:语义相似度任务需文本对及相似度分数;检索任务需查询及相关文档,并定义二元、序数或带分数的相关性。文章建议,几百个精心策划的样本即可提供有效信号,几十个也比没有好。使用precision@k、MRR、NDCG等指标,借助ranx等库进行评估,可对比不同模型在自身数据上的表现。
生产环境权衡:吞吐、延迟与成本
选择生产用嵌入模型时,需平衡吞吐量、延迟和成本。吞吐量影响系统处理负载的能力,大模型通常吞吐较低;延迟对实时应用至关重要,量化模型可显著改善;成本包括基础设施和API调用费用,自托管前期投入高但单次成本可能更低。文章举例,新闻推荐可能优先吞吐,网站搜索优先延迟,而聊天机器人可能优先成本。最终需根据具体用例找到平衡点。
多目标优化与灵活迁移
嵌入模型选择是多目标优化问题,没有一刀切方案。文章建议汇总各模型在精度、推理时间、内存、成本、多语言支持等维度的表现,形成对比表,再结合业务需求决策。同时,选择并非一劳永逸,随着应用演进可能需要更换模型。Qdrant的命名向量等功能支持多模型切换或混合搜索,便于迁移。此外,量化、Matryoshka嵌入、混合搜索和重排序等技术也能在整体管道中优化成本与质量。
Q&A
如何判断一个嵌入模型是否支持我的数据语言?
检查模型训练时使用的语言。开源模型可在Hugging Face Hub查看文档,例如all-MiniLM-L6-v2仅支持英语。商业模型如OpenAI和Cohere公开了分词器。还可以直接运行分词器观察输出,或修改文本看相似度变化,若相似度极低可能是不支持字符被替换为UNK。
选择嵌入模型时需要考虑哪些关键因素?
需考虑任务类型(语义相似、检索、问答等)、序列长度(模型最大输入长度)、模型大小(参数和内存需求)、优化支持(如二值量化、Matryoshka嵌入),以及生产环境中的吞吐量、延迟和成本。
如何为嵌入模型评估构建真实数据集?
根据任务构建:语义相似任务需文本对及相似度分数;检索任务需查询和期望的相关文档,并定义相关性级别(二元、序数或带分数)。数据集不需要百万样本,几百个精心策划的例子即可,几十个也比没有好。
评估嵌入模型时常用哪些指标?
常用precision@k、MRR、NDCG等指标。可使用ranx等库进行计算。这些指标能帮助衡量模型在特定数据上的检索质量。
生产环境中选择嵌入模型需要权衡哪些操作因素?
需权衡吞吐量(每秒生成嵌入数)、延迟(单次嵌入速度)和成本(基础设施或API费用)。例如新闻推荐系统可能优先吞吐量,网站搜索优先延迟,聊天机器人可能优先成本效益。
嵌入模型的选择是一次性的吗?
不是。随着应用演进,可能需要重新评估模型。Qdrant的架构支持轻松迁移到不同模型,命名向量可帮助构建多模型系统,根据查询切换或构建混合搜索。
