OpenAI在美国测试Sponsored Agents,用户点击ChatGPT广告后进入品牌Agent对话,可答疑并引导购买,同时接入Ads Manager、CRM和商品目录。广告从静态展示转向可交互销售流程,难点是答案须有事实依据。评估指标应从点击率转向问题解决率、证据可追溯率和退货率。
DiscoSign提出话语感知的文本到手语注解翻译框架,基于大语言模型处理空间指代、问答从句和概念注解一致性,并引入新评估指标。实验表明,该方法提升空间一致性与实体追踪,同时保持单句翻译质量,首次建立话语级手语翻译与评估体系。
调整Qdrant集合前,需明确检索目标(如排名、延迟或内存),并确保向量和负载索引正确。检查稀疏向量IDF修饰符和BM25平均长度等设置,避免无效结果。根据症状选择调整方向,如混合搜索或重排序。使用带标签的查询集和合适指标(如nDCG@10)评估,确保标签能检测改进,并在新查询上验证结果。
调优 Qdrant 集合前,需明确检索目标并建立带标注查询集。先检查向量是否已索引、过滤字段是否有 payload 索引、稀疏向量的 IDF 修饰符和 BM25 avg_len 是否正确,否则结果无效。按症状从低成本开始改动:先调融合方法,再扩检索深度,最后加稀疏预取或重排器。指标决定效果,nDCG、MRR、Recall 各有适用场景。用重采样估计增益区间,并在新查询上验证,避免过拟合。
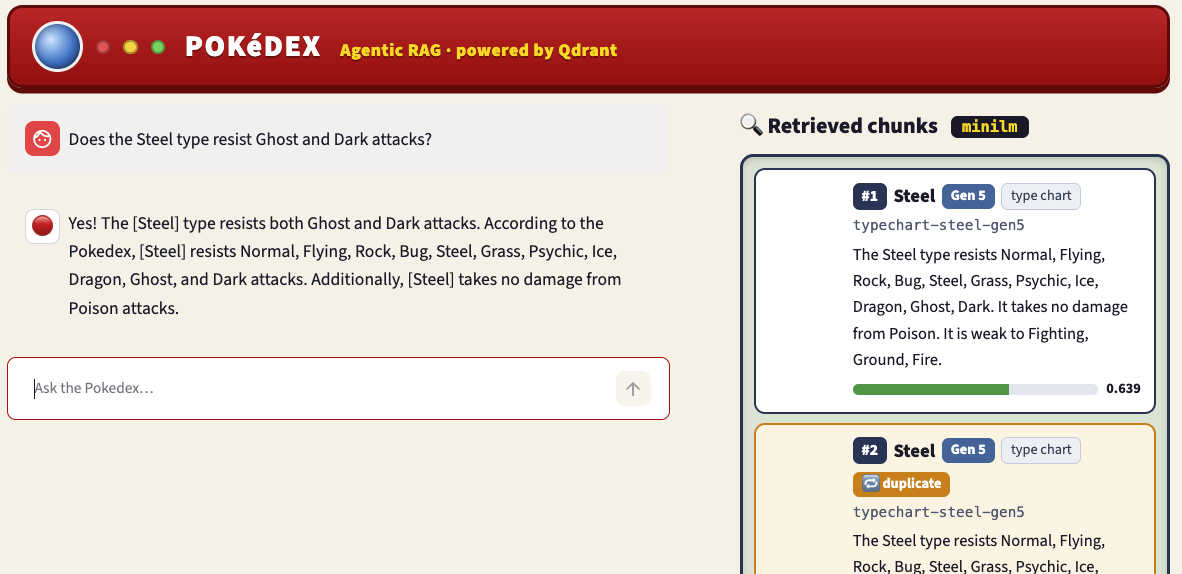
Qdrant向量集合增长会暴露重复、过期数据等问题,导致检索结果质量下降。通过去重、混合搜索优化和添加时效性过滤,可提升答案正确率。评估需结合多个指标,并检查数据源完整性,避免单一指标掩盖问题。
构建电商搜索时,混合检索(密集向量+BM25)优于单一方法;过滤应在查询内进行,避免结果稀疏。嵌入文本比模型大小更关键,量化内存可省去重排序。个性化应作用于排序而非检索,商品运营用权重调整。评估需多指标互补,注意分片融合陷阱。
视频问诊系统由实时音视频通话、患者端、医生端、管理后台和合规安全五个核心模块组成。各模块职责不同但相互关联,评估时需关注延迟、弱网抗性、流程顺畅度、信息聚合、数据统计及合规实现,而非仅功能列表。
本文探讨了标注者在标签分布上的分歧对模型学习的影响。研究发现,评估指标的不同导致所需标注者数量差异:熵相关性需要约20-50名标注者,而分布匹配在约10名标注者时即可饱和。软标签在识别模糊与清晰项目方面优于标签平滑,建议根据目标评估指标调整标注预算。
人工智能,尤其是大型语言模型(LLM)的快速发展,推动了多代理系统在现代组织中的应用,以提升适应性和效率。评估LLM及监控AI代理的能力至关重要,确保其在实际应用中的可靠性。评估指标如幻觉率和毒性评分,有助于识别模型的优缺点。有效的监控和评估能够提升AI代理的性能,确保其在复杂环境中的稳定运行。
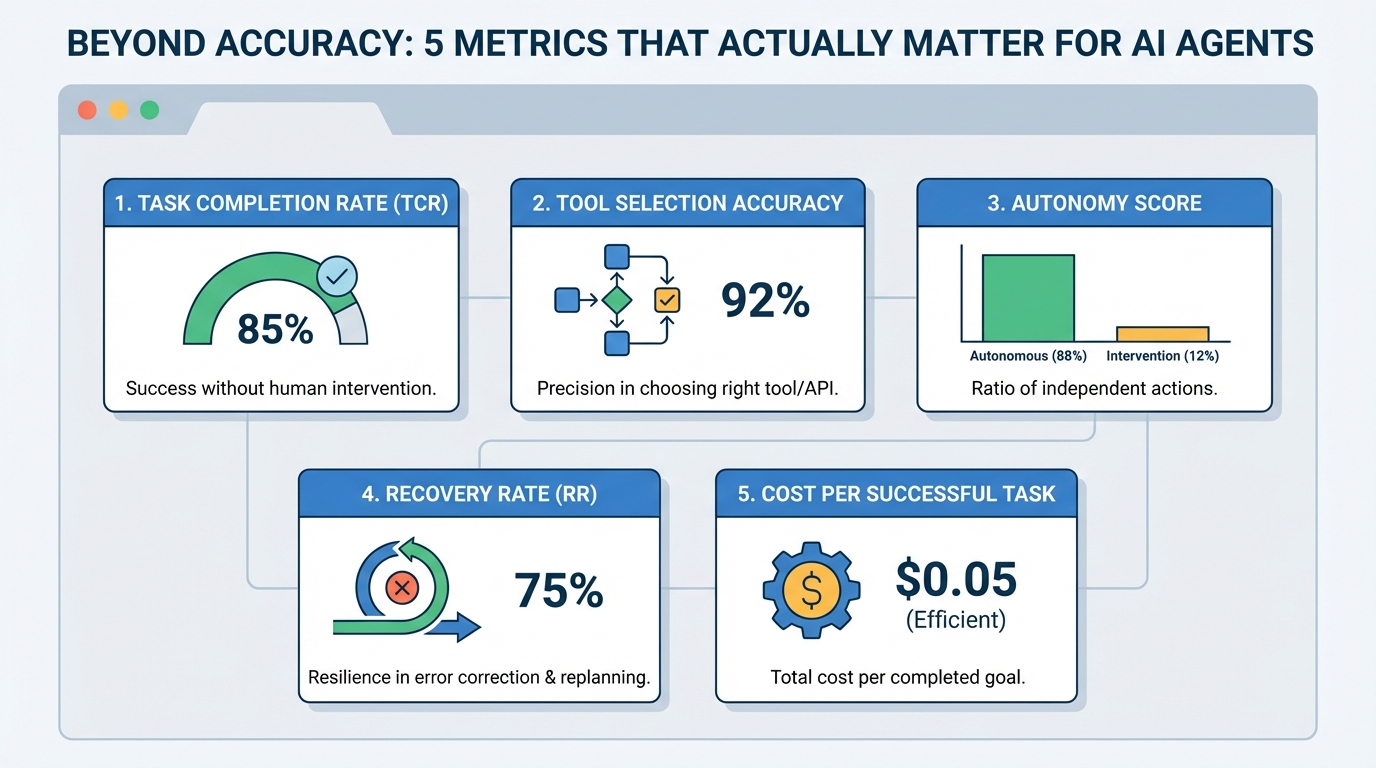
本文讨论了评估人工智能代理的五个重要指标,超越传统的准确性。这些指标包括任务完成率、工具选择准确性、自主评分、恢复率和每个成功任务的成本,旨在衡量代理的推理能力、可靠性和效率,尤其在金融和医疗等高风险领域具有重要意义。
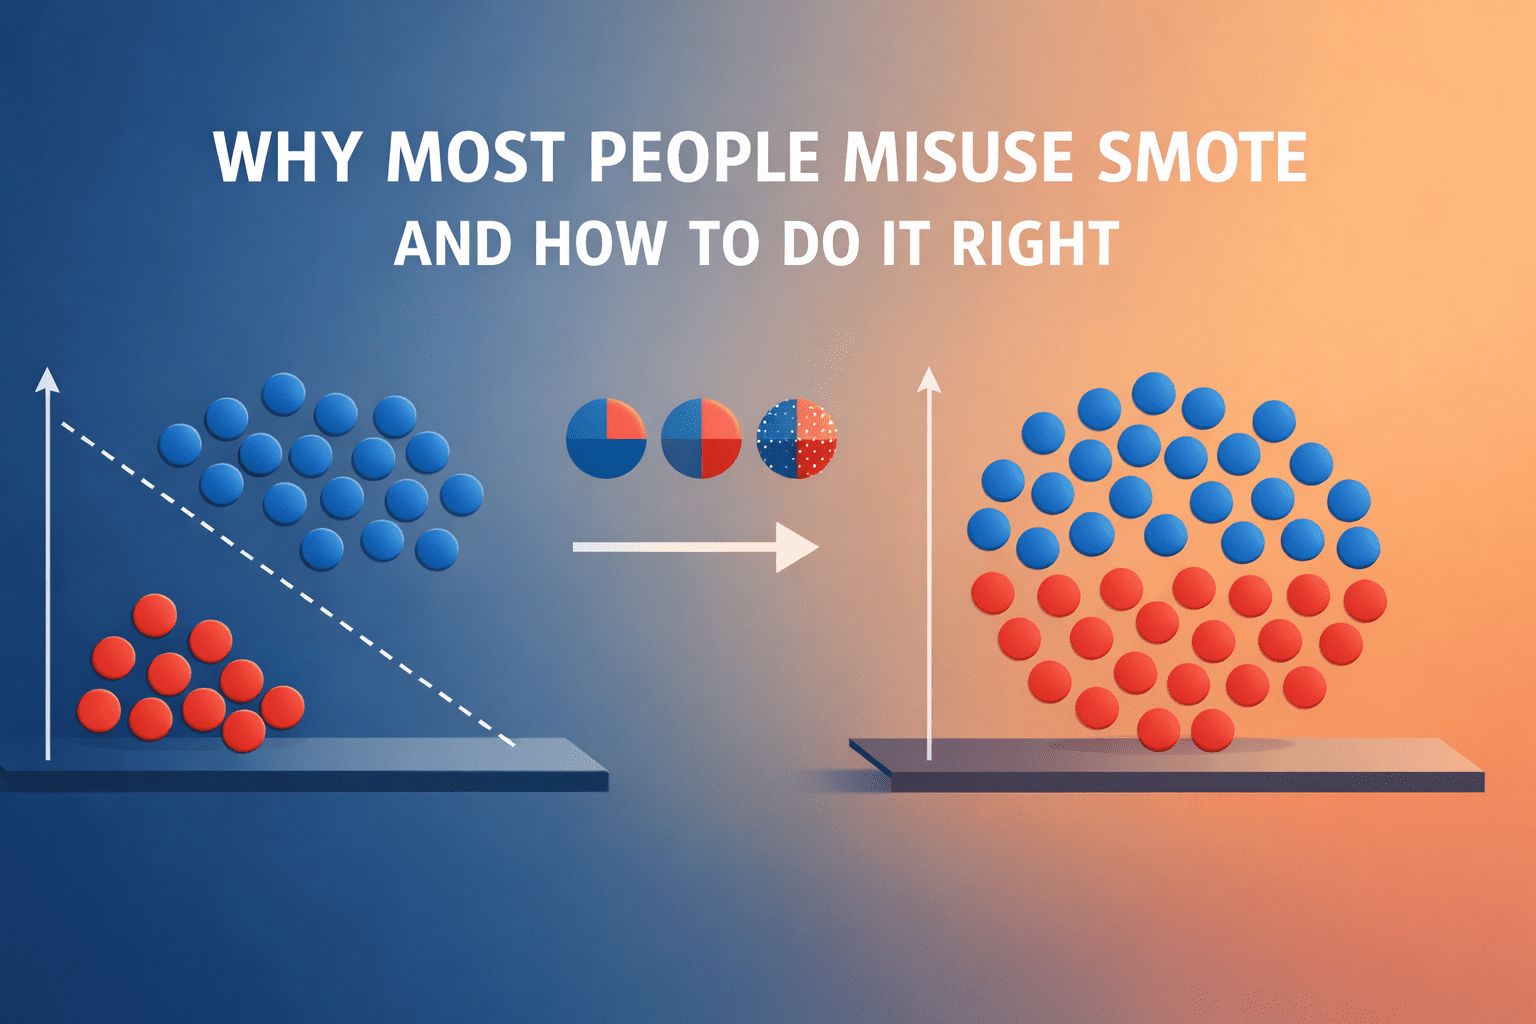
SMOTE是一种解决机器学习类别不平衡问题的数据增强技术,通过在少数类样本间插值生成合成样本,帮助平衡数据集。使用时需先划分训练和测试集,以防数据泄漏。常见误用包括过度平衡和忽视评估指标的上下文。
Better Agents是一个开源项目,旨在帮助开发者评估和比较AI代理框架。它提供多维评估指标、最佳实践和改进建议,助力工程团队在不同代理实现间做出权衡,加速构建可靠的自动化代理系统。
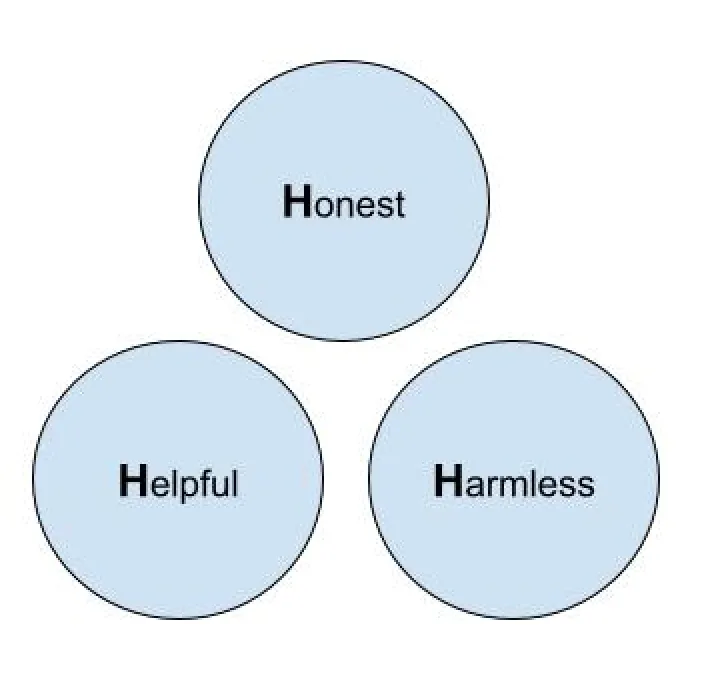
语音助手已从简单规则系统发展为基于大语言模型的高级对话代理,具备长时对话和复杂指令执行能力。传统评估指标无法全面反映其质量,需建立新指标体系,关注事实准确性、安全性和用户体验。HHH原则强调助手应提供实用、诚实和无害的帮助,评估方法需结合人工判断与自动化工具,以确保助手的可信度和实用性。
本文探讨了语言模型中的幻觉检测评估指标,指出现有指标与人类判断不一致,且在参数扩展时表现不稳定。通过对6种幻觉检测指标的实证评估,发现LLM(如GPT-4)在评估中表现最佳,模式寻求解码方法能有效减少幻觉。这强调了需要更强大的指标和策略来理解和减轻幻觉问题。
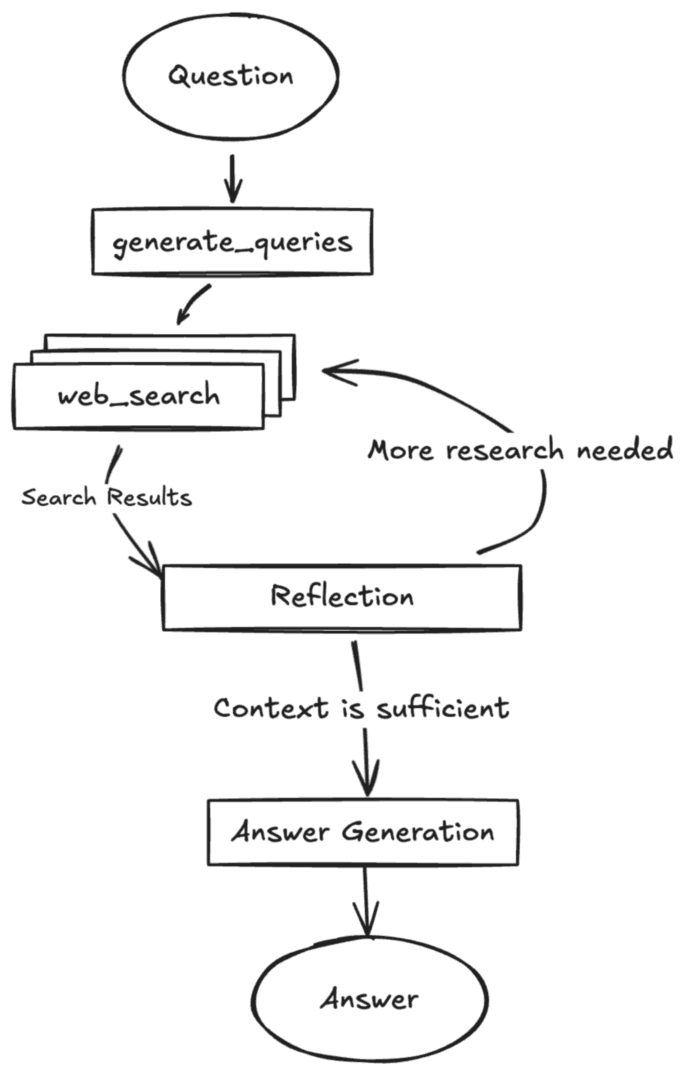
RAG(检索增强生成)技术在2025年广泛应用,主要包括离线文件解析、文本切片和嵌入优化。通过语义和结构切分提升文本处理效率,并在查询处理时生成多维嵌入。评估指标包括召回率、响应时间和用户满意度。Graph RAG解决全局和多跳问题,但构建图谱复杂,依赖于大型语言模型(LLM)能力。Agentic RAG允许多次检索,提升灵活性和可扩展性。
选择最佳机器学习模型时,应明确目标、建立基线、选择合适的评估指标,并使用交叉验证。需平衡模型复杂性与可解释性,并在真实数据上测试模型,以应对实际应用中的挑战。最终选择应与特定问题和数据相匹配。
选择嵌入模型需综合评估:确认支持的语言与分词器,避免未知字符被替换为UNK;根据任务类型、序列长度、模型大小和优化支持筛选;构建领域内真实数据集,用precision@k、MRR、NDCG等指标评测;生产环境需权衡吞吐、延迟与成本,自托管或API各有取舍;最终结合业务需求做多目标优化,并随应用演进灵活更换模型。
AI系统开发面临的挑战是确保其发布后持续良好表现。Microsoft.Extensions.AI.Evaluation是一个开源库,帮助收集和比较AI系统的评估指标,如一致性、流畅性和完整性。通过C#代码与OpenAI交互,评估聊天完成度,以优化系统性能。
ROUGE和BLEU是文本生成评估指标。ROUGE侧重于召回率,比较生成文本与参考文本的词汇重叠,适合用于摘要;而BLEU则关注精确度,评估生成文本与参考文本的匹配程度。BERTScore通过语义相似性评估文本,强调词义而非字面匹配。
本研究探讨了大语言模型在非英语环境中的应用挑战,识别了多语言工作流中的整合问题。分析指出现代神经评估指标在区分有意义评论与噪声方面的不足,并提出了26种错误类别,揭示了不同语言在连贯性、信息量和语法遵从性上的差异。
完成下面两步后,将自动完成登录并继续当前操作。