


CnOCR V2.3 新版发布:模型更好、更多、更大
内容提要
CnOCR V2.3 版本发布,经过重新训练和精调,精度更高。新增多种场景和规模的模型,支持简体中文、英文及数字识别。模型分为场景、文档、数字和通用四类,满足不同应用需求。用户可在在线 Demo 验证效果,模型可免费获取或购买。
延伸解读
模型规模与精度权衡
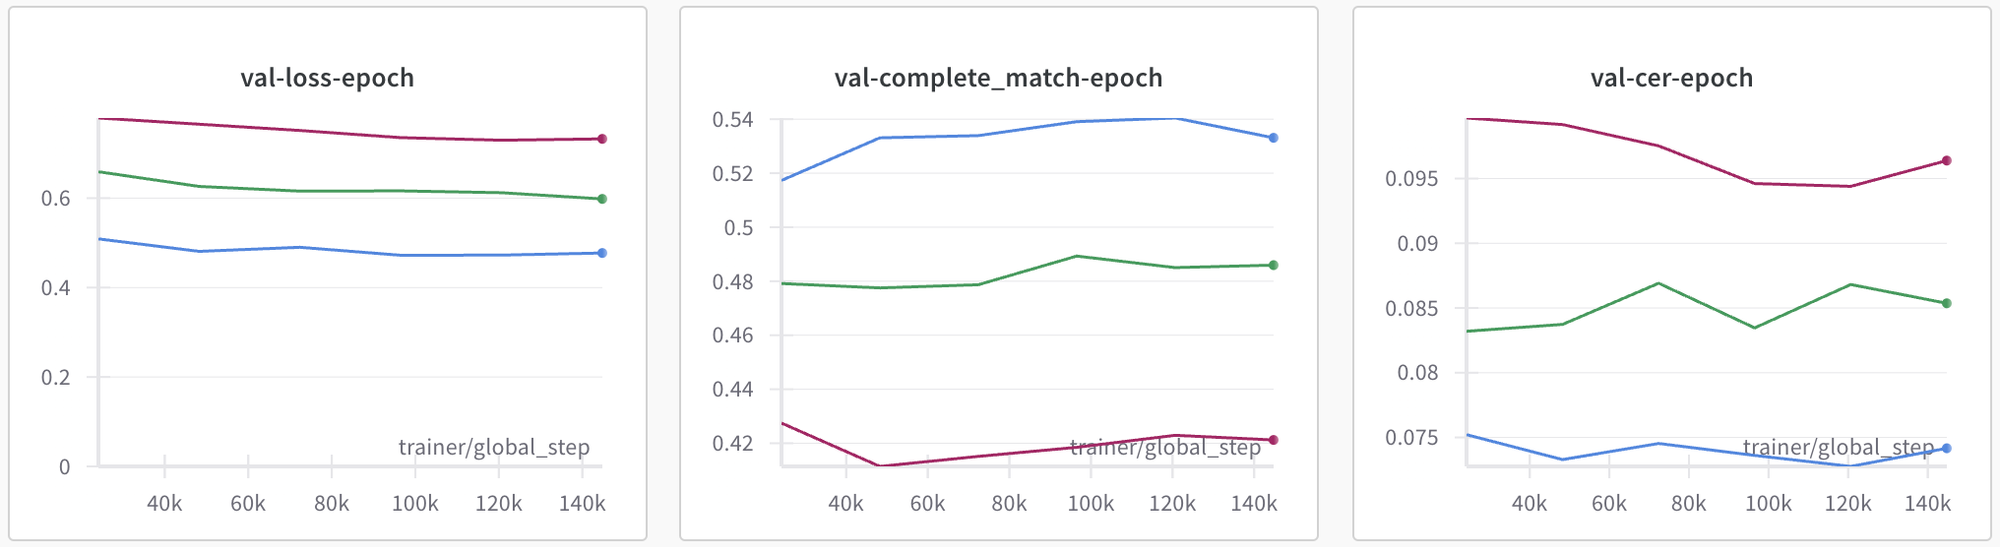
V2.3 提供了三个参数规模的模型系列:densenet_lite_136-gru(3.1M)、densenet_lite_246-gru_base(6.6M)和 densenet_lite_666-gru_large(21.3M)。文章中的预训练和精调曲线显示,随着模型规模增大,精度迅速提升。但大模型文件也更大,对计算资源要求更高。因此,选择模型时需在精度和资源消耗之间取得平衡。
场景化模型选择指南
V2.3 将模型按使用场景分为四类:scene 适合一般拍照图片,doc 适合文档截图或扫描件,number 仅识别纯数字(如银行卡号),general 适合无明显倾向的图片。文章建议具体选择时以实际效果为准,并推荐先在在线 Demo 上用自己的图片验证,再决定是否需要更大模型。
获取方式与使用成本
densenet_lite_136-gru 系列已开源,可免费自动下载;densenet_lite_246-gru_base 系列仅供知识星球会员使用;densenet_lite_666-gru_large 系列需购买。文章还提到,星球会员购买个人版模型可享八折,但企业版无折扣。用户需根据自身需求和预算选择合适的模型。
在线 Demo 的实用技巧
文章提供了 HuggingFace 和 ModelScope 两个在线 Demo,但 HuggingFace 需要梯子,ModelScope 体验较差。一个实用技巧是:检测模型会极大影响识别效果,可以尝试多个检测模型,或上传单行文字图片并勾选“单行文字模式”,从而绕过检测模型,仅测试识别模型的效果。
Q&A
CnOCR V2.3 的主要改进是什么?
CnOCR V2.3 经过重新训练和精调,精度更高,并新增多种场景和规模的模型。
CnOCR V2.3 支持哪些语言的识别?
CnOCR V2.3 支持简体中文、英文及数字的识别。
如何获取 CnOCR V2.3 的模型?
用户可以在在线 Demo 验证效果,模型可免费获取或购买,具体可在 HuggingFace 和 ModelScope 上下载。
CnOCR V2.3 中模型的分类有哪些?
模型分为场景、文档、数字和通用四类,满足不同应用需求。
V2.3 版本中删除了哪些模型?
V2.3 删除了小模型,新增了更高参数量的模型系列。
如何在 CnOCR 中验证模型效果?
用户可以在 HuggingFace 上的 CnOCR Demo 上传照片验证效果,或在 ModelScope 上使用 Demo。
