
基于 Amazon Bedrock ApplyGuardrail API 的内容安全过滤:可观测性看板与运营实践
内容提要
Amazon Bedrock ApplyGuardrail API 不支持 Model Invocation Logging,需自建监控。本文提出两种方案:CloudWatch 实时看板用于运维告警,S3+Athena+QuickSight 用于离线深度分析,并提供 Java 封装库,一行代码完成内容过滤与日志记录,还介绍了误报分析与调优实践。
延伸解读
为什么 ApplyGuardrail 需要自建可观测性
ApplyGuardrail API 作为独立护栏调用时,Model Invocation Logging 并不适用,CloudTrail 仅记录 API 元数据,无法看到完整的用户请求 Prompt 和响应内容。虽然 CloudWatch Metrics 会自动采集拦截率、延迟等聚合指标,但无法回答“具体哪条内容因什么原因被拦截”。因此需要在应用侧捕获 API 返回的 assessments 信息并写入日志存储,才能补齐拦截详情的可见性。
实时看板与离线分析如何取舍
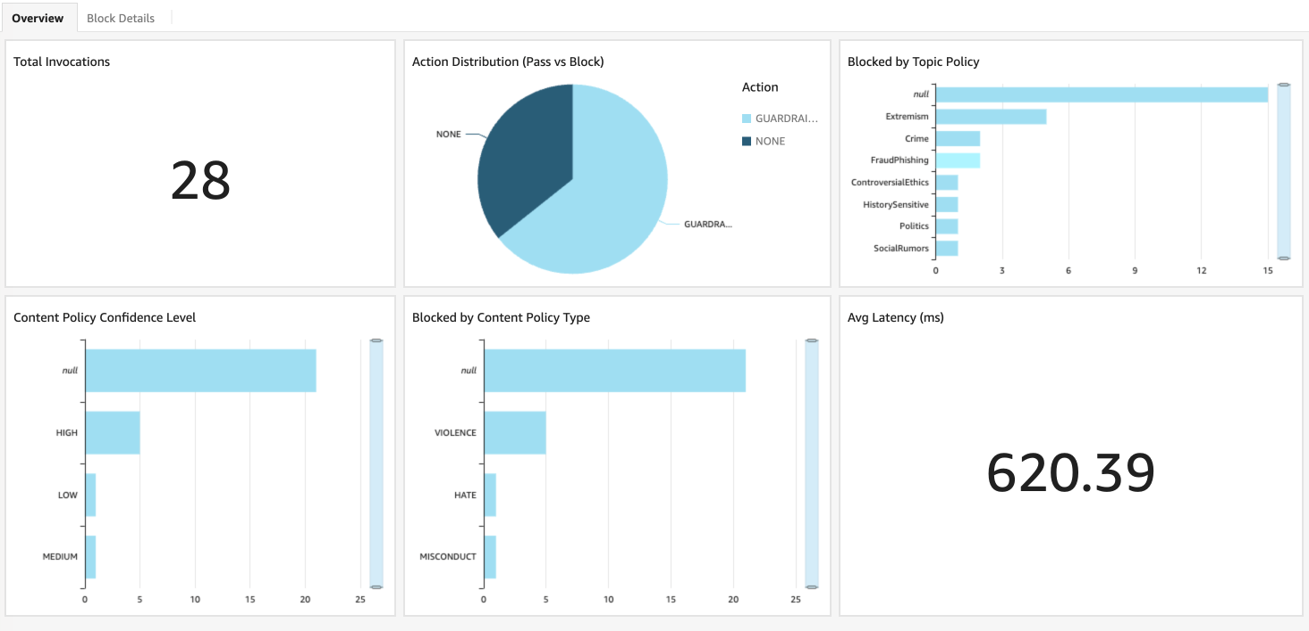
方案 A 基于 CloudWatch Dashboard,数据延迟为秒级,适合日常运维监控和告警响应,但存储成本较高且需配置保留策略。方案 B 基于 S3 + Athena + QuickSight,数据延迟为分钟级(SPICE 定时刷新),适合深度分析、跨月趋势和合规审计,S3 存储成本较低且天然支持长期保留。文章建议两者按需启用,而非二选一。
误报调优的关键操作点
文章给出若干可落地的调优实践:初期将 Guardrail action 配置为 NONE,只记录不拦截,积累 48 小时基线数据;使用 outputScope=FULL 捕获所有类别评分,包括接近阈值但未触发的内容;定期审查 LOW confidence 的拦截记录;各内容类别可独立设置过滤强度;不同业务场景拆分 Guardrail,避免一刀切。这些做法都依赖自建日志管道提供的数据。
封装库的日志设计与使用边界
Java 封装库将 assessments 响应扁平化为结构化日志,把 content_policy_type、topic_policy_name 等关键策略字段提取为顶层字段,便于直接用 SQL 或 Logs Insights 查询。日志写入采用 best-effort 方式,写入失败不影响主流程。使用时需注意 IAM 权限需覆盖 bedrock:ApplyGuardrail、s3:PutObject 以及 CloudWatch Logs 相关操作,且 Metrics 查询必须指定 Operation=Apply
Q&A
为什么使用 Amazon Bedrock ApplyGuardrail API 时需要自建监控体系?
因为 ApplyGuardrail API 不支持 Model Invocation Logging,无法在原生日志中记录完整的用户请求 Prompt 和 API 响应。虽然 CloudWatch Metrics 会自动采集拦截率、延迟等聚合指标,但看不到具体哪条内容因什么原因被拦截,因此需要自建日志管道来追踪拦截详情。
CloudWatch Dashboard 和 S3+Athena+QuickSight 两种监控方案分别适合什么场景?
方案 A(CloudWatch Dashboard)数据延迟为秒级,适合日常运维监控和告警响应;方案 B(S3+Athena+QuickSight)数据延迟为分钟级(SPICE 定时刷新),存储成本低且天然支持长期保留,适合深度分析、跨月趋势和合规审计。建议按需启用,方案 A 用于实时监控,方案 B 用于长期存储与深度分析。
ApplyGuardrail API 的响应中 outputScope 参数有什么作用?
outputScope 控制返回的评估详情级别。默认值 INTERVENTIONS 只返回触发了策略的评估项;设置为 FULL 则返回所有类别的评分,包括未触发的。推荐在误报分析和阈值调优时使用 FULL。
bedrock-guardrail-filter 这个 Java 封装库怎么用?
通过 Builder 模式创建 BedrockGuardrail 实例,配置 guardrailId、guardrailVersion、region、credentialsProvider 以及日志目标(S3 和/或 CloudWatch Logs),然后调用 filterInput 或 filterOutput 方法即可一行代码完成内容过滤与日志记录。支持仅 S3、仅 CloudWatch 或双写模式。
如何降低 Guardrail 的误报率?
文章建议:初期使用 Detect Mode(action 配置为 NONE)只记录不拦截,积累 48 小时基线数据;使用 outputScope=FULL 捕获所有类别评分;定期审查 LOW confidence 的拦截记录;按内容类别独立调优过滤强度;按业务场景拆分 Guardrail 避免一刀切。
方案 B 中 S3 日志如何被 Athena 查询?
日志以 Hive 分区格式写入 S3(如 year=2026/month=08/day=30/hour=15/),Athena 建表时使用 Partition Projection 自动管理分区,无需手动执行 MSCK REPAIR TABLE。建表后即可用标准 SQL 查询每日拦截率趋势、误报候选等。
基于 CloudWatch 可以配置哪些告警?
文章给出三类告警:拦截率突增(InvocationsIntervened/Invocations > 10% 持续 5 分钟,用于配置变更或攻击检测)、绝对拦截数突增(InvocationsIntervened > 100 每 5 分钟,用于量级异常)、延迟劣化(InvocationLatency P95 > 500ms,用于 Guardrail 性能问题)。
