


英伟达全新Nemotron模型如何运作
内容提要
英伟达Nemotron系列以高效为核心,采用Mamba层与注意力混合架构,以固定状态处理长序列并降低KV缓存开销;结合MoE,每token仅激活部分专家(如300亿参数模型仅激活约30亿)。训练流程包括预训练、监督微调和GRPO强化学习,并采用多token预测加速生成,同时通过NVFP4低精度量化将模型从约66GB压缩至约22GB。
延伸解读
混合架构的取舍:Mamba 与注意力如何互补
Nemotron 将 Mamba 层与注意力层交错排列,让大部分序列处理依赖固定大小的状态,从而避免 KV 缓存随上下文线性膨胀。但文章也指出,将长历史压缩进有界状态会削弱精确检索能力,因此保留部分注意力层来维持对远距离位置的直接访问。这种设计并非单纯追求低成本,而是在效率与长程信息召回之间做权衡,读者需注意其适用场景可能更偏向需要高效重复调用的智能体任务。
MoE 省算力不省内存:稀疏激活的实际边界
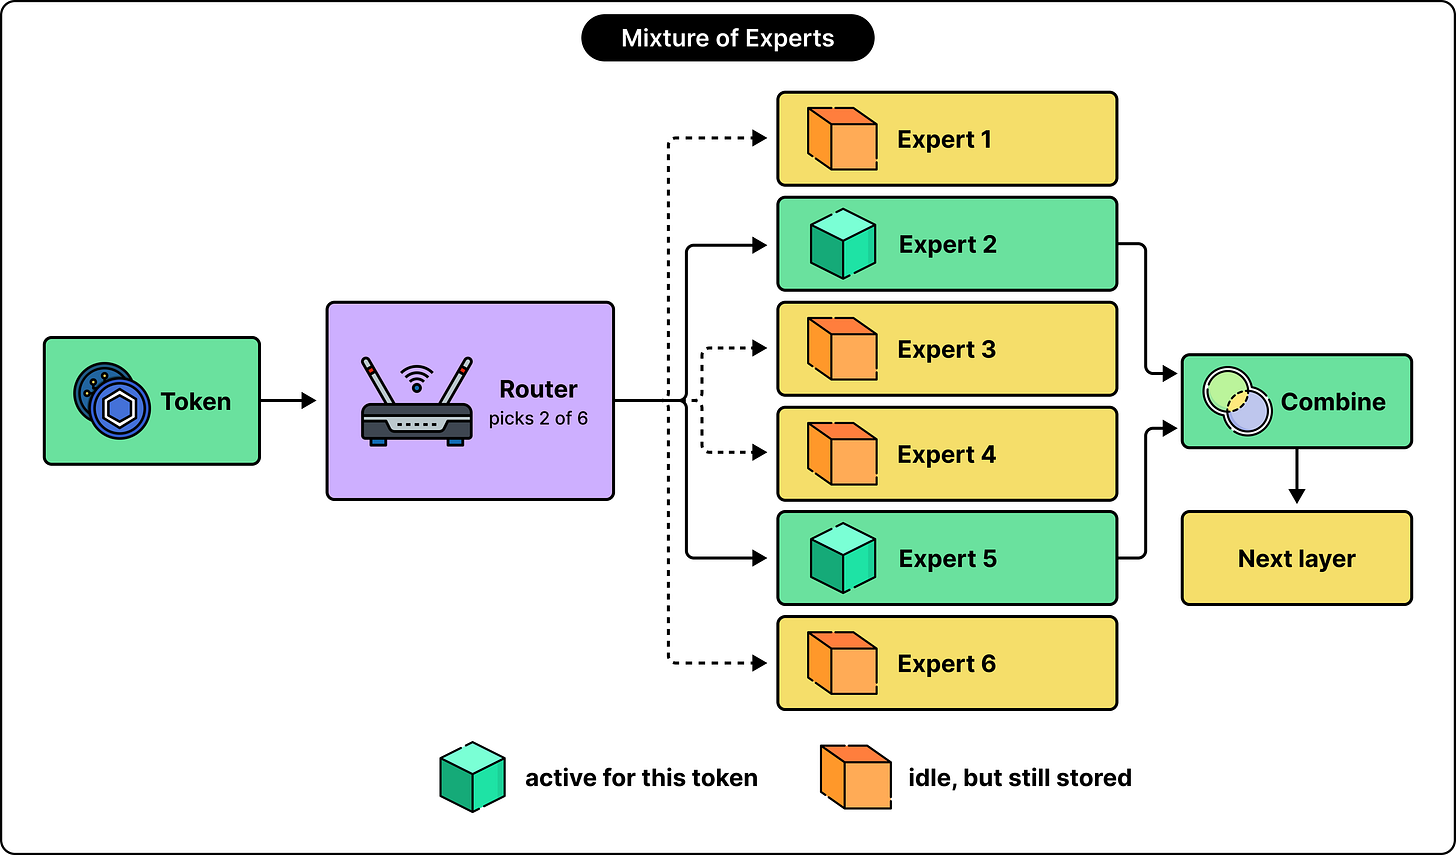
Lightning 配置每层有 128 个路由专家,但每个 token 只激活 6 个,使得总参数约 300 亿的模型单 token 仅使用约 30 亿参数。文章明确提醒,未激活的专家仍需常驻内存以备后续 token 使用,因此稀疏激活降低的是每 token 的计算量,而非模型托管所需的总内存。这意味着部署时仍需为全部参数预留存储空间,不能将“激活参数少”简单等同于“模型小”。
训练三阶段与多 token 预测的协同
Nemotron 的训练从预训练、监督微调推进到 GRPO 强化学习,后者通过比较同一提示下多个生成响应的相对表现来更新模型,并借助数学答案校验、代码测试等环境提供反馈。生成阶段则利用多 token 预测支持推测解码:轻量草稿机制先提出多个候选 token,主模型再一次性验证,接受多个 token 即可减少顺序调用次数。这两项优化分别作用于训练行为塑造和推理速度,但文章未给出具体加速倍数。
低精度量化的收益与近似风险
NVFP4 将权重从 BF16 的 16 位压缩到 4 位浮点,并配合分组缩放和量化感知蒸馏,使模型从约 66GB 降至约 22GB。文章指出量化本质是用更少的数值近似原始权重,存在近似误差,因此 Nvidia 让量化学生模型在训练中模拟量化并逼近 BF16 教师模型的输出分数。读者应关注的是,存储与内存带宽收益明确,但精度损失程度取决于蒸馏效果,文章未提供具体精度对比数据。
Q&A
英伟达Nemotron模型的核心设计目标是什么?
核心设计目标是在保持良好模型容量的同时,降低计算和内存需求。为此,它结合了不同类型的神经网络层,每个token只激活部分参数,并优化了答案生成方式。
Nemotron如何利用Mamba层和注意力机制来降低计算成本?
Nemotron将Mamba层与注意力层交错结合。Mamba层维护一个紧凑的固定状态来处理长序列,避免为每个历史token存储键值对,从而降低KV缓存开销;注意力层则保留直接访问早期位置信息的能力。两者交替,使大部分序列处理使用紧凑状态,同时部分层仍能连接远距离信息。
Nemotron的MoE架构是如何实现稀疏激活的?
Nemotron采用混合专家(MoE)架构,每层包含多个前馈网络(专家)。路由器为每个token选择一组专家进行处理,例如Lightning配置有128个路由专家,每个token只激活6个。这样,一个总参数约300亿的模型,每个token仅使用约30亿参数,从而减少计算量,但所有专家仍需存储在内存中。
Nemotron的训练流程包括哪些阶段?
训练流程包括三个阶段:首先是大规模预训练,让模型学习预测token并构建语言表示;然后是监督微调(SFT),使用期望行为的示例(如指令、对话)进行训练,且损失仅计算在助手回复的token上;最后是强化学习,采用组相对策略优化(GRPO),模型对同一提示生成多个回答,根据奖励比较相对表现来更新模型。
多token预测(MTP)如何加速Nemotron的文本生成?
多token预测训练一个辅助机制来预测后续多个token。在推理时,这些预测可用于推测解码:轻量级起草机制提出多个候选token,主模型通过一次验证过程评估这些候选。如果接受多个提议,生成可以一次前进多个位置,减少顺序通过主模型的次数,从而加速生成。
NVFP4量化如何帮助减少Nemotron的存储需求?
NVFP4是一种4位浮点格式,结合缩放信息:每16个值共享一个FP8缩放因子,另有张量级缩放。通过量化感知蒸馏(QAD),从BF16教师模型训练一个量化学生模型,学生模拟量化并学习匹配教师的输出分数。这使得模型大小从约66GB(BF16)压缩到约22GB(NVFP4),显著减少存储和内存传输。
