小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate

文章指出,RTX 4090 D解锁仅恢复FP16/BF16/TF32浮点Tensor吞吐,而低比特量化MoE推理主要使用INT8/INT32整数指令,整数吞吐未变。Strata专家内核采用纯整数mma指令,瓶颈在显存带宽、PCIe传输与CPU卸载,而非浮点算力。48GB 4090实测预填充为原版0.98–0.99倍,本地长窗口无明显收益。解锁真正受益于LoRA/SFT微调、扩散模型及BF16大批量稠密推理。

RTX 4090 D Tensor解锁:量化MoE推理能获得什么?

https://blog.ferstar.org/en/index.xml https://blog.ferstar.org/en/index.xml · 2026-10-26T08:16:00Z
Fish Audio 发布 Drama 3:一款 35B 开放权重的 MoE 文本转语音模型

Fish Audio 发布文本转语音模型 Drama 3,采用 35B 混合专家架构,每 token 激活约 3B 参数,权重开放。支持 83 种语言、16 个说话人及自然语言表演指令。发音鲁棒性测试得分 93.2%,精确序列为 86.3%。自托管需 48GB 以上 NVIDIA 显存,API 定价每百万字符 50 美元,年营收 50 万美元以下可免费商用。

Fish Audio 发布 Drama 3:一款 35B 开放权重的 MoE 文本转语音模型

实时互动网 实时互动网 · 2026-10-15T02:31:49Z
OLMo-core 3的token gerrymandering提醒:MoE路由要按时间窗验收

Ai2 开源 OLMo-core 3,重写 MoE 训练系统,专家池扩至 128、参数达 470 亿,吞吐提升约 2.7 倍。报告指出“token gerrymandering”问题:全局均衡分数可能掩盖分时间窗的专家热点,导致局部拥堵。建议路由验收按时间窗、分层、分 GPU 进行,监控峰值占比、丢弃 Token 与通信等待,并设置停机条件。

OLMo-core 3的token gerrymandering提醒:MoE路由要按时间窗验收

Java for You Java for You · 2026-10-02T05:19:20Z
循环MoE架构深度解析,稠密Transformer之外第三条大模型路线

循环MoE架构将MoE与循环Transformer结合,参数与算力比值虽与稠密模型相同,但行为迥异。MoE横向动态路由专家,循环机制纵向增加计算深度,二者叠加使知识容量与思考深度解耦,并可将显存瓶颈转为算力瓶颈。但训练难度大,存在路由坍缩、循环次数难定、梯度不稳等问题,实际部署尚少。

循环MoE架构深度解析,稠密Transformer之外第三条大模型路线

极道 极道 · 2026-09-15T10:16:00Z
6GB显存能跑35B MoE吗:FreeToken极限配置、性能压榨与实操教程

6GB显存可运行Qwen3.6-35B-A3B-NVFP4,但需32GB以上内存,依赖CPU和PCIe。配置建议:Triton attention、memory-ratio 0.92、Prefill 2048、512专家槽。性能低于8GB的39.3 tok/s,适合短上下文和编码实验。需Ampere架构,逐步调优专家缓存和KV,实测不同后端。

6GB显存能跑35B MoE吗:FreeToken极限配置、性能压榨与实操教程

Nicksxs's Blog Nicksxs's Blog · 2026-09-05T02:00:00Z
DeepSeek MLA+MoE+FP8三招破局:系统级优化六个狠招

DeepSeek通过系统级创新,用2048块H800和557.6万美元完成训练,成本仅为GPT-4o的二十分之一。它未发明新技术,但优化了MLA压缩KV缓存、MoE专家激活、FP8混合精度训练、DualPipe计算通信重叠等六项技术,显著降低内存和算力消耗,提升效率,突破芯片限制。

DeepSeek MLA+MoE+FP8三招破局:系统级优化六个狠招

极道 极道 · 2026-08-27T10:02:00Z

上个月,我们发布了迄今为止最大的开源模型K3。作为K2的继任者,K3并不是一次从零开始的重新设计,而是沿着我们过去一系列工作自然演化而来,并融合了我们对效果、效率、稳定性的一些最新理解和改进。可...

简单谈谈K3的MoE和Attention

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2026-08-04T05:07:00Z
colibri – 在 25GB 内存电脑上运行 GLM-5.2 (744B MoE)

Colibri 是一个开源项目,允许普通电脑在仅有 25GB 内存的情况下运行 GLM-5.2 模型,无需 GPU。它通过按需加载模型参数,节省内存和硬盘空间。GLM-5.2 是智谱发布的强大开源模型,支持多种操作系统,但需要 370GB 硬盘。

colibri – 在 25GB 内存电脑上运行 GLM-5.2 (744B MoE)

小众软件 小众软件 · 2026-07-14T06:10:52Z
刚刚,全球首个具身专属的MoE视频模型,开源了!

蚂蚁灵波推出了LingBot-Video,这是全球首个针对具身智能的视频生成模型。该模型专注于生成符合物理规律的视频,帮助机器人理解真实世界的互动。LingBot-Video结合了大量具身数据和互联网视频,通过MoE架构降低计算成本,提升训练效率,应用于机器人动作规划和策略评估,标志着视频生成技术向物理世界模拟器的转变。

刚刚,全球首个具身专属的MoE视频模型,开源了!

量子位 量子位 · 2026-07-09T05:47:05Z
英伟达MoE新开源:一行import,微调加速3.7倍

英伟达推出NeMo AutoModel,基于Transformers v5,提升MoE模型微调速度3.4-3.7倍,显存减少29%-32%。通过专家并行、DeepEP和TransformerEngine等技术,优化内存和计算效率。用户只需添加一行代码即可实现升级,支持更大批次和更长序列,相关代码已开源。

英伟达MoE新开源:一行import,微调加速3.7倍

量子位 量子位 · 2026-06-26T03:23:35Z
750B MoE 模型从自建 RoCE 集群迁移至 AWS EFA:Prefill-Decode 分离推理的通信架构验证

本文探讨了750B MoE模型从自建RoCE集群迁移至AWS EFA的过程,验证了Prefill-Decode分离推理的通信架构。客户希望利用AWS的弹性算力扩展本地GPU资源,降低硬件风险。通过理论分析和实际测试,比较了AWS EFA与自建RoCE集群的性能,发现EFA在复杂通信负载下表现良好,尽管在某些延迟指标上略逊一筹,但在尾延迟稳定性上有显著优势。整体来看,EFA已可替代RoCE,尤其在对尾延迟敏感的场景中表现出色。

750B MoE 模型从自建 RoCE 集群迁移至 AWS EFA:Prefill-Decode 分离推理的通信架构验证

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2026-06-18T01:33:28Z
Modular:Modular 26.4:SOTA MoE服务、通过代理技能进行模型启动、Mojo 1.0 Beta 2及更多

Modular 26.4版本推出,支持MiniMax M3和GLM 5.2等前沿模型,增强了模型架构和API兼容性。新功能包括稀疏激活的Mixture-of-Experts(MoE)架构,提升了性能和开发体验。用户可通过Modular Cloud访问500多种模型架构,支持多种应用场景。

Modular:Modular 26.4:SOTA MoE服务、通过代理技能进行模型启动、Mojo 1.0 Beta 2及更多

Modular Blog Modular Blog · 2026-06-18T00:00:00Z
Modular:Modular 26.4:SOTA MoE服务、通过代理技能进行模型启动、Mojo 1.0 Beta 2及更多

Modular 26.4版本推出,支持MiniMax M3和GLM 5.2等前沿模型,增强了模型架构和API兼容性。新功能包括稀疏激活的Mixture-of-Experts(MoE)架构,提升性能和开发体验。用户可通过Modular Cloud访问500多种模型架构,适用于多种应用场景。

Modular:Modular 26.4:SOTA MoE服务、通过代理技能进行模型启动、Mojo 1.0 Beta 2及更多

Modular Blog Modular Blog · 2026-06-18T00:00:00Z

追溯一下MoE历史,我们都能发现,早些年MoE的Router在作为Gate去乘到Expert上时,基本都是用Softmax激活,直到现在它仍是MoE的标准形式之一。不过,为了配合Loss-Fre...

MoE环游记:9、门控归一化之争

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2026-06-17T08:05:00Z
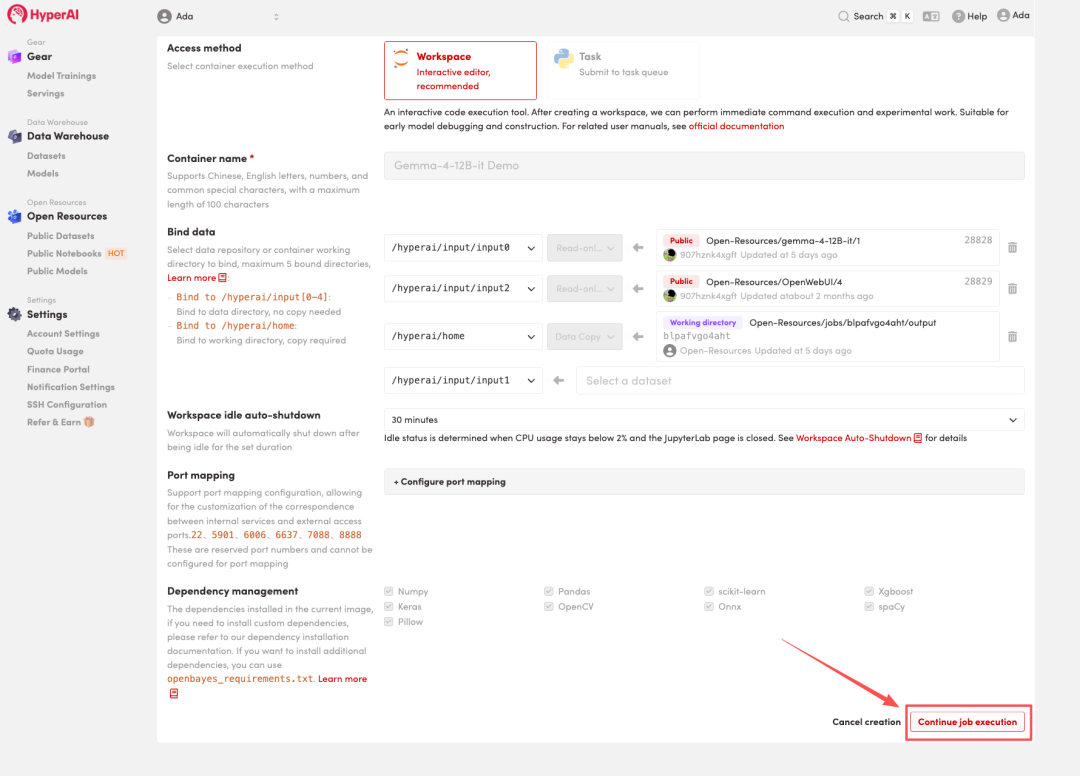
在线教程丨16GB笔记本跑出接近26B MoE性能,Gemma 4 12B基于创新架构统一处理文本/图像/声音三种模态

Google DeepMind 发布了新款多模态模型 Gemma 4 12B,参数为120亿,但在多项测试中表现接近260亿参数的模型。其无编码器架构显著降低了推理延迟和内存占用,支持音频输入,并可在普通笔记本上运行,降低了部署成本,为开发者提供了接近顶级性能的选择。

在线教程丨16GB笔记本跑出接近26B MoE性能,Gemma 4 12B基于创新架构统一处理文本/图像/声音三种模态

HyperAI超神经 HyperAI超神经 · 2026-06-10T03:09:51Z
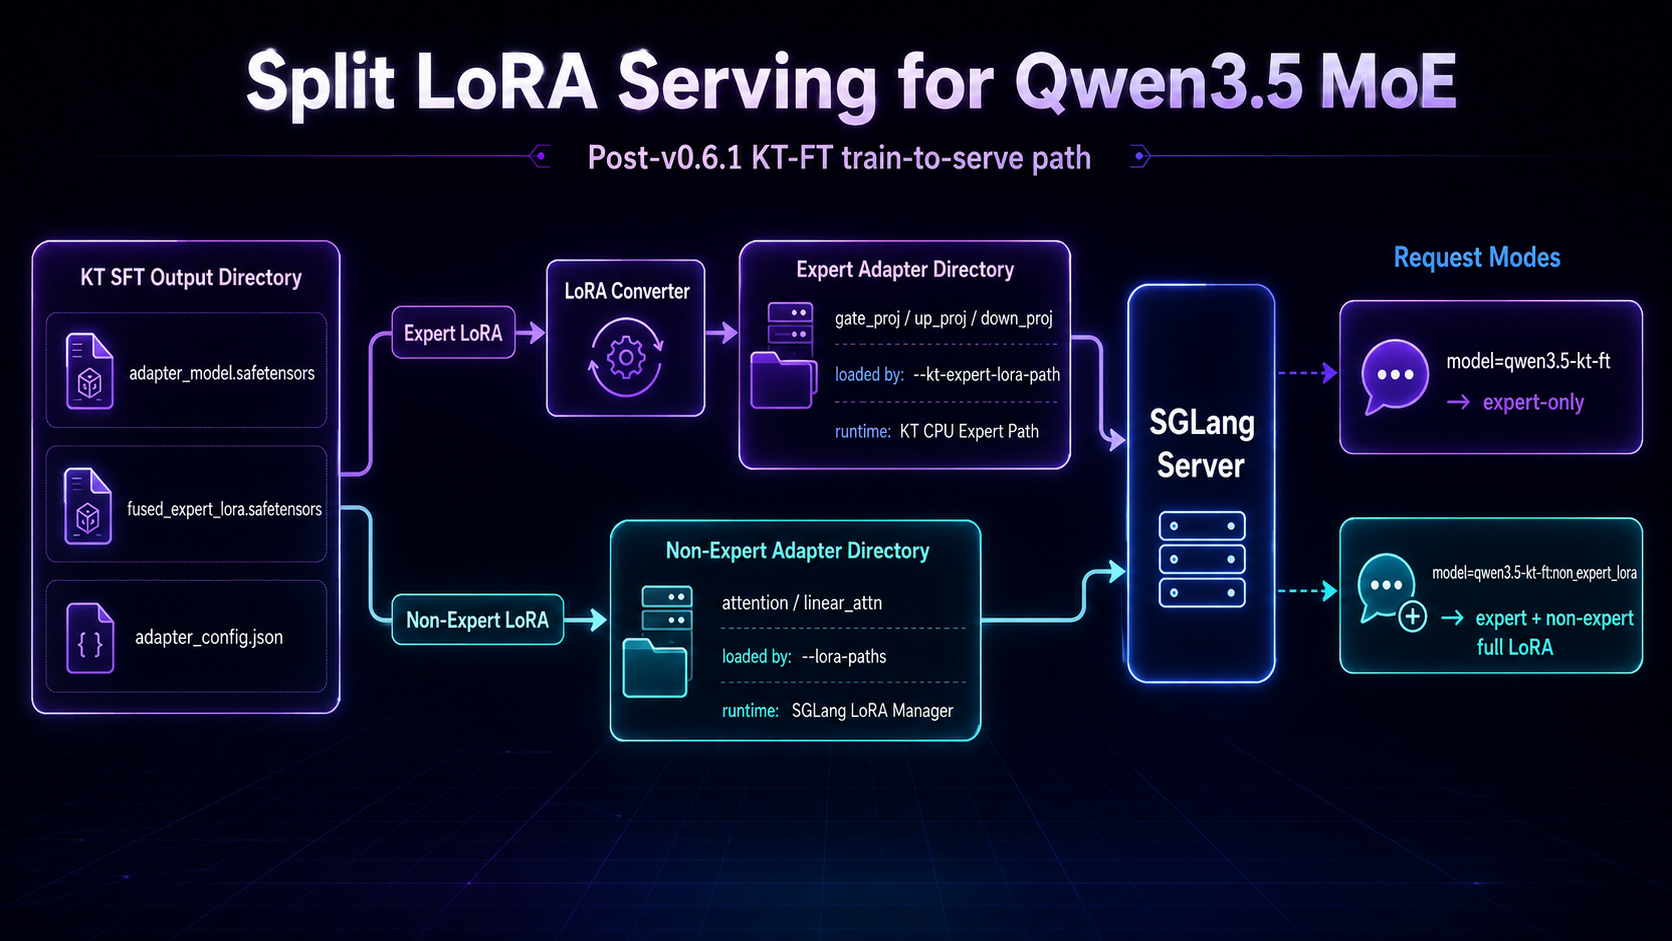
KT-FT v0.6.1:实现从MoE微调到本地服务的完整闭环

KT-FT v0.6.1更新了MoE SFT后端,提升了训练速度和内存使用效率。新版本支持将训练好的适配器无缝集成到SGLang中,并优化了本地服务流程。用户可通过转换脚本将适配器分为专家和非专家LoRA,确保有效运行,目标是实现从本地微调到服务的完整闭环。

KT-FT v0.6.1:实现从MoE微调到本地服务的完整闭环

Home | KVCache.ai Home | KVCache.ai · 2026-05-29T00:00:00Z

到目前为止,“MoE环游记”系列已经写了7篇文章,其中5篇都是围绕着MoE的路由和负载均衡展开的。从路由的形式来看,它们可以分为静态计算和动态计算两类;从实现负载均衡的方法上看,它们又可以分为A...

MoE环游记:8、强制序列级均衡

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2026-05-22T06:46:00Z
DeepSeek-V4——迈向百万token上下文:保留V3的MoE和多token预测机制,提出混合注意力机制(CSA/HCA)、流形约束超连接mHC(替代残差)、Muon优化器(取代AdamW)

DeepSeek-V4系列模型推出了1.6T和284B参数的两个版本,采用混合注意力架构和流形约束超连接,提升了长上下文处理效率。通过Muon优化器和多项基础设施优化,模型在训练和推理阶段展现出更高的稳定性和效率。预训练后,DeepSeek-V4在多个基准测试中超越前代,设立了新的性能标准。

DeepSeek-V4——迈向百万token上下文:保留V3的MoE和多token预测机制,提出混合注意力机制(CSA/HCA)、流形约束超连接mHC(替代残差)、Muon优化器(取代AdamW)

结构之法 算法之道 结构之法 算法之道 · 2026-05-03T15:54:48Z

2024年,混合专家(MoE)架构成为大模型的主流,开源项目如Mixtral和DeepSeek推动了其发展。MoE通过减少激活参数显著降低计算成本,同时提升模型表达能力,适合算力充裕的场景。关键技术包括细粒度专家、共享专家和改进的负载均衡策略。未来,MoE将向更大规模和动态专家数发展。

【大模型基础设施工程】08:MoE 训练工程

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-04-22T00:00:00Z
Mythos架构被22岁小伙“逆推”开源了!MoE和注意力借鉴DeepSeek

OpenMythos是一种新型的循环深度Transformer架构,采用MoE路由机制,通过跨专家权重共享实现高效推理。在参数量减少近一半的情况下,其性能与传统模型相当。研究表明,循环Transformer在处理未见知识组合和深度推理方面表现更佳,可能改变大模型的训练方式,受到学术界关注。

Mythos架构被22岁小伙“逆推”开源了!MoE和注意力借鉴DeepSeek

量子位 量子位 · 2026-04-20T07:59:51Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码