


文字还没写完,声音已经响起:从 HMM 到声学大模型的流式 TTS 演进
内容提要
流式TTS在文本陆续到达时同步合成语音,以衔接大语言模型实现低延迟对话。文章区分音频输出流式与文本音频双流式,梳理HMM、Tacotron、FastSpeech及CosyVoice等方案如何通过增量编码、有限右看、交错建模和分块声码器应对后文缺失,并指出首音延迟、块间抖动与插话取消需分别评测。
延伸解读
流式TTS的三种形态:传输、输出与双流
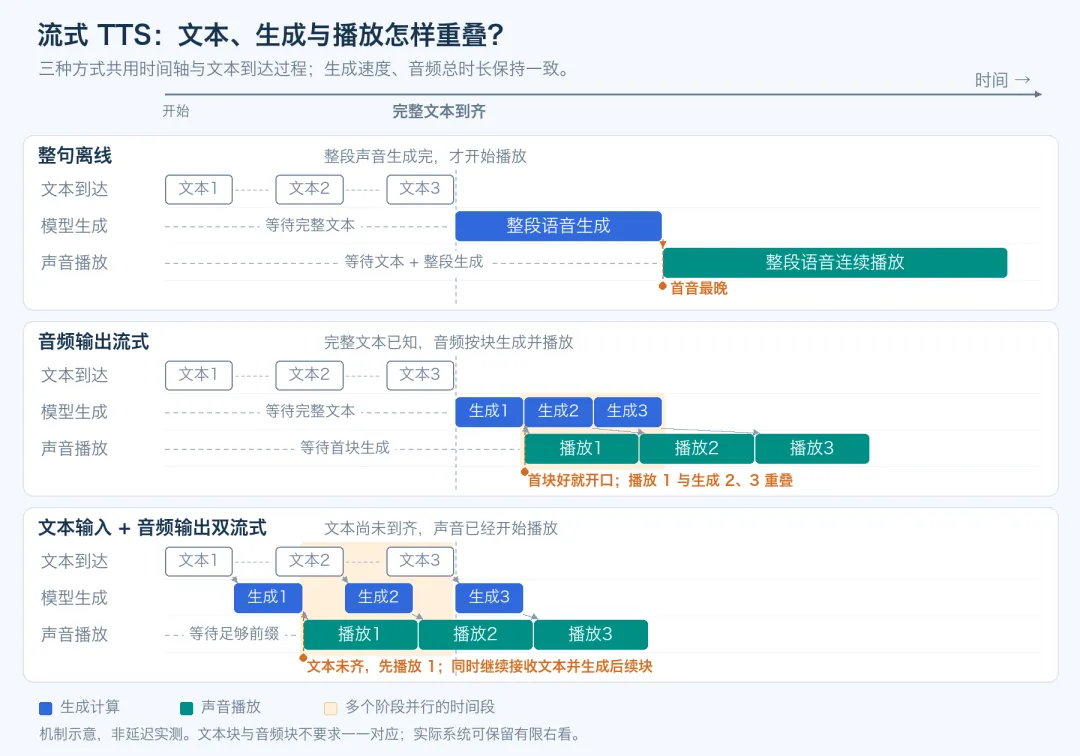
文章明确区分了三种“流式”:完整音频生成后分包发送只改变传输方式;完整文本已知、音频逐块生成是音频输出流式;文本陆续到达、声音同步产生才是适合衔接LLM的双流式。双流式不要求逐字念出,而是允许等待少量后文以确认发音和短语边界,减少对完整句子的依赖。这种区分有助于避免将传输优化误认为真正的低延迟合成。
首音延迟不等于模型速度
从首个文本到达至用户听见声音,涉及前缀积累、请求排队、首块合成、传输和播放缓冲等多个环节。文章指出,优化声学模型只缩短其中一段,模型算完后客户端仍可能等待缓冲,服务端也可能因并发排队延迟开始。因此,音频块时长200ms不意味着首音延迟就是200ms,需分别观察平均速度、首音时间和块间抖动。
历史方案的核心挑战:缺失未来信息
从HMM到神经网络再到声学大模型,流式化始终要处理后文未到达时的生成问题。HMM时代需用默认值补齐缺失上下文标签,并在有限窗口内生成平滑的参数轨迹;Tacotron等模型需让文本编码和对齐适应增量输入,同时让声码器分块工作;大模型方案则通过文本语音交错、注意力掩码和分块声学恢复来安排生成顺序。这些设计都需为等待设定边界。
评估流式TTS需覆盖整条链路
文章建议从四方面评价:开口是否及时(分别记录服务端首包和客户端首音)、内容与声音是否可靠(检查漏读、重复、块边界一致性)、播放能否持续(关注块间抖动和缓冲耗尽)、交互能否及时停止(插话后生成、传输和播放队列都应响应取消)。测试应重放相同的文本到达过程,不能用一次性输入完整文本的成绩代替双流式评估。
Q&A
流式 TTS 中的“双流式”具体指什么?和普通的音频流式有什么区别?
双流式指文本陆续到达、声音同步产生的模式,适合衔接 LLM。而音频输出流式是完整文本已知、音频逐块生成,只改变传输方式;完整音频生成后再分包发送则只改变传输方式。
为什么流式 TTS 的首音延迟不能只看模型速度?
首音延迟包括前缀积累、请求排队、首块合成、传输和播放缓冲等多个环节。模型速度只影响合成部分,如果输入端仍在等整句或客户端缓冲不足,首音依然会很晚。
HMM 时代的流式 TTS 面临哪些主要挑战?
HMM 流式化需处理三个层面:文本前端能否增量分析(上下文标签依赖后文)、声学模型如何处理未知条件(用默认值补齐或训练时引入未知上下文)、参数轨迹如何局部生成(有限窗口下保持平滑衔接)。
Tacotron 和 Transformer-TTS 在流式化时各有什么关键问题?
Tacotron 自回归解码可逐步输出,但完整文本编码、注意力稳定性和声码器可能阻碍增量合成;Transformer-TTS 注意力更强,但需限制未来依赖并复用历史状态,且训练并行不代表推理并行。
声学大模型时代,流式 TTS 如何解决文本与语音的交替推进?
通过交错建模安排读写顺序(如 CosyVoice 2/3 前端交错组织文本与语音 token,后端分块因果 Flow Matching),并用因果掩码和分块掩码限制信息范围,使模型适应后文缺失的情况。
评价流式 TTS 系统时应该关注哪些指标?
需分别评估:开口及时性(服务端首包和客户端首音)、内容与声音可靠性(漏读、重复、块边界一致性)、播放持续性(块间抖动、缓冲耗尽)、交互可取消性(插话后及时停止)。
在实际应用中如何选择流式 TTS 的技术路线?
根据场景需求选择:固定播报或资源受限设备可选轻量方案;文本已知的朗读可用音频输出流式;接入 LLM 的语音助手需重点验证增量文本输入,外部分句适合快速接入,原生增量或交错训练方案开口更快、韵律更连续;强调音色迁移等能力可考察大模型,但需分开验证流式能力、质量和成本。
