SemanticKernel/C#:检索增强生成(RAG)简易实践
内容提要
检索增强生成(RAG)是一种结合检索技术与生成模型的方法,主要用于自然语言处理任务。它通过从外部知识库检索信息并与输入文本结合,生成更准确的输出,特别适用于需要背景知识的任务。RAG提升了大语言模型在回答基于私有文档问题时的准确性和可解释性,采用了向量化和数据库存储技术。
延伸解读
RAG 如何解决大模型的私有数据盲区
文章指出,大语言模型在通用知识上表现强劲,但面对私有数据(如特定公司信息或个人偏好)时往往无法回答。RAG 通过从外部知识库检索相关信息,并将其与输入文本结合,使模型能够基于私有文档生成准确答案。这种方法不仅提升回答的准确性,还增强了可解释性,因为可以明确指出生成内容所依据的外部知识片段。
实现 RAG 的关键步骤与工具选择
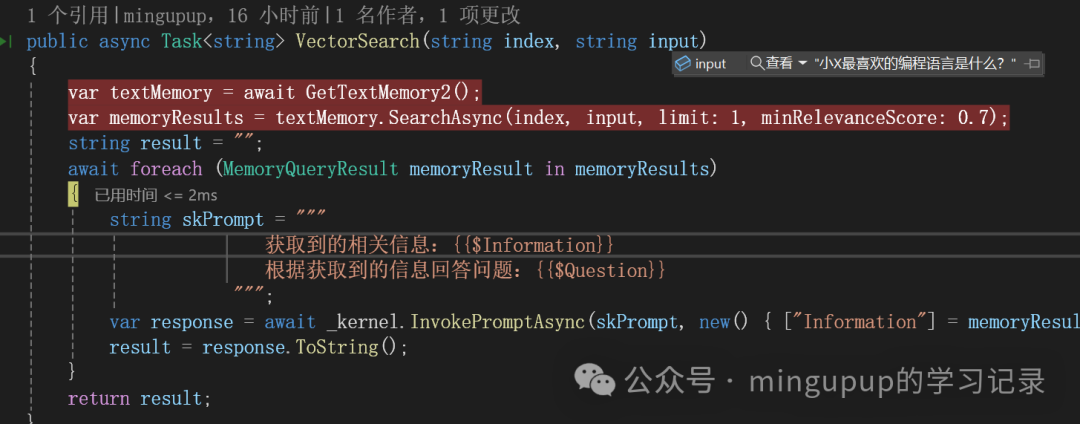
文章展示了基于 SemanticKernel 的简易 RAG 实践:使用嵌入模型将文本转化为向量,存入 SQLite 数据库,检索时通过余弦相似度找到最相关片段,再嵌入 Prompt 让大语言模型回答。作者选用硅基流动平台的 Qwen2-7B-Instruct 作为对话模型,OpenAI 的 text-embedding-ada-002 作为嵌入模型,并指出硅基流动的嵌入模型在搜索时存在报错问题,尚未解决。
本地运行大模型的探索方向与挑战
作者提到,虽然本地运行大语言模型对电脑配置要求较高,但仍有需求场景,下一步计划探索在 SemanticKernel 中使用本地模型与嵌入模型。本地运行可借助 Ollama,官方也有计划发布 Ollama Connector。作者尝试过本地嵌入模型,认为运行尚可,但对话模型本地运行不太行,可能需换用国内平台。这反映了本地化部署在资源与性能间的权衡。
Q&A
检索增强生成(RAG)的主要功能是什么?
RAG结合了检索技术和生成模型,主要用于自然语言处理任务,通过从外部知识库检索信息生成更准确的输出。
RAG如何提高大语言模型的准确性?
RAG通过检索外部知识并将其与输入文本结合,明确指出生成文本与外部知识的关联,从而提升准确性和可解释性。
RAG适用于哪些类型的任务?
RAG特别适用于需要大量背景知识的任务,如专业领域的问答系统和对话代理。
如何实现RAG模型的向量化?
实现RAG模型的向量化需要将文本转化为向量,存入数据库,并基于输入查询的向量进行检索。
在RAG中如何使用SQLite存储向量?
在RAG中,可以使用SQLite作为存储向量的数据库,通过将生成的向量保存到SQLite数据库中进行管理。
RAG的下一步探索方向是什么?
下一步探索方向包括在本地运行大语言模型与嵌入模型的结合,以及使用Ollama等平台的集成。
