


Reachy 的记忆:用 Qdrant Edge 为机器人赋予本地语义记忆
内容提要
Reachy Mini 机器人利用 Qdrant Edge 在机载向量库中本地存储对话、画面和人脸,实现无需联网的语义记忆。通过优化工具描述和设置空帧阈值,解决了“今天看到什么”等检索问题,使机器人能记住人名、延续对话并描述所见。
延伸解读
本地记忆的隐私与性能权衡
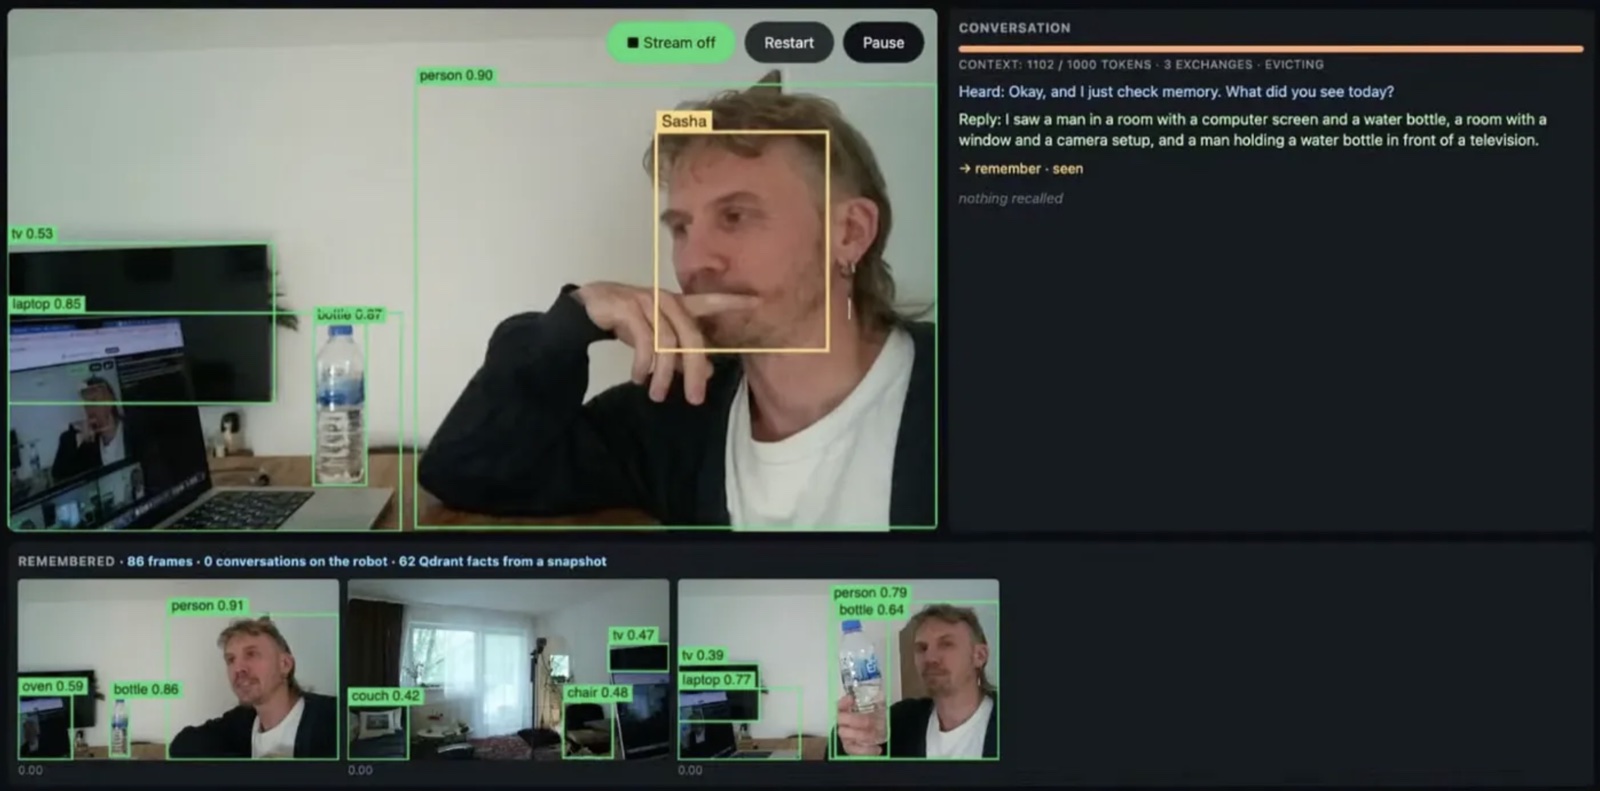
Reachy 将对话、画面和人脸等记忆存储在机载 Qdrant Edge 中,而非云端,这确保了敏感数据不出户,同时搜索延迟仅约半毫秒,且断网时仍可用。但需注意,演示中对话模型 Gemma 4 因内存限制运行在旁边的笔记本电脑上,通过本地网络访问,因此记忆的存储和搜索在机器人上,但模型推理在外部设备。这提示了在资源受限设备上实现本地记忆时,计算与存储可能分离的典型架构。
工具描述对检索效果的关键影响
文章指出,小模型仅凭措辞选择工具,导致“今天看到什么”被误判为拍照指令。通过修改 remember 工具的描述,明确过去时态的问题应使用记忆搜索,正确选择率从 23/26 提升至 26/26,且未影响相机工具。这表明在基于语言模型的工具调用中,工具描述本身就是检索系统的一部分,精心设计的描述能显著提升意图识别准确率,而无需改动索引或模型。
空帧阈值:解决无实体查询的检索失败
当问题未提及具体物体时,向量搜索仍会返回最近邻,导致所有帧因共享“I saw”前缀而得分虚高。Reachy 引入空帧“I saw something”作为基准,只有得分超过空帧且高于阈值的帧才被采纳。若无帧胜出,则从已有图像向量中采样多样帧。这一方法有效区分了泛化问题与具体查询,避免了无关记忆的误召回,提升了回答质量。
分片策略:按写入与搜索模式设计
Reachy 将记忆分为三个分片:memory 存储对话和帧,通过 tenant 键区分;people 存储人脸,每人一个多向量,用 MaxSim 匹配;knowledge 存储静态事实,启动时从快照恢复。这种按数据写入和搜索方式而非内容类型分片的设计,优化了检索效率。例如,人脸搜索需多向量匹配,而事实库整体替换,分开存储便于独立管理。这为其他设备构建本地记忆提供了可借鉴的架构模式。
Q&A
Reachy Mini 机器人如何实现本地语义记忆?
Reachy Mini 使用 Qdrant Edge 在机载向量库中本地存储对话、画面和人脸,通过 SigLIP2 和 bge-small 嵌入模型将数据转为向量,实现无需联网的语义记忆。
为什么 Reachy 的记忆要存储在本地而不是云端?
因为记忆包含房间和人物的图片,不应离开家庭除非用户允许;本地存储还使搜索只需半毫秒,并在无 Wi-Fi 时仍能工作。
Reachy 在回答“今天看到什么”时遇到了什么问题,如何解决的?
最初 Reachy 会错误地调用摄像头拍照,因为“看到”听起来像“看”。通过修改 remember 工具的描述,明确过去时问题应使用记忆搜索,正确率从 23/26 提升到 26/26。
Qdrant Edge 在 Reachy 中是如何组织记忆数据的?
Reachy 使用三个分片:memory/ 存储对话和帧(通过 kind 字段区分),people/ 存储人脸多向量,knowledge/ 存储 62 条事实。每个分片有独立的分数阈值。
Reachy 如何识别人脸并决定是否打招呼?
people/ 分片为每个人存储一个多向量,包含其所有面部照片。MaxSim 将摄像头中的人脸与每个人的最近照片匹配,得分高于 0.35 时按名字打招呼,低于 0.25 时询问身份,介于两者之间则等待确认。
从 Reachy 的项目中学到了哪些关于向量搜索的通用经验?
经验包括:为每个存储设置分数阈值并调优;给搜索一个空记录作为比较基准;工具描述是检索系统的一部分;按数据写入和搜索方式而非数据类型来拆分分片。
