


与Andrej Karpathy一起在60分钟内揭开大型语言模型的秘密
内容提要
这篇文章是关于Andrej Karpathy的一次讲座,他介绍了大型语言模型的能力、未来潜力和相关安全风险。讲座分为三个部分:基本知识、未来发展和安全挑战。文章提供了讲座的幻灯片和YouTube链接供进一步了解。
延伸解读
从讲座看LLM训练:两阶段与RLHF
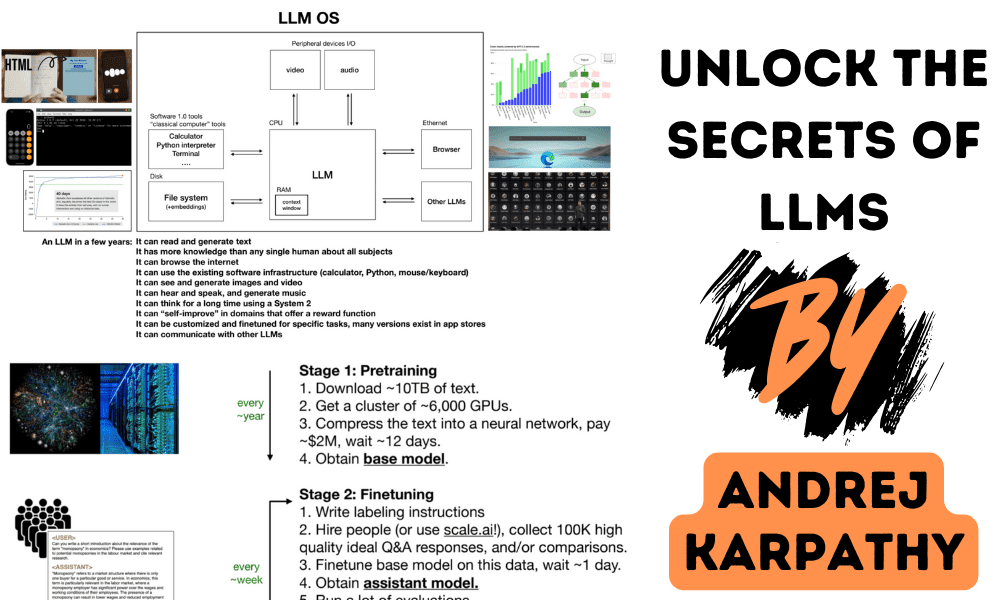
Karpathy在讲座中详细介绍了LLM的训练过程,分为预训练和微调两个阶段。预训练使用约10TB的互联网文本,通过GPU集群训练出基础模型,它本质上是互联网的有损压缩,能生成连贯文本但不会直接回答问题。微调则使用高质量数据集,将基础模型转化为助手模型。此外,还提到第三阶段——基于人类反馈的强化学习(RLHF),通过让模型从多个候选答案中选择最佳来进一步优化性能。
LLM的未来:缩放定律与工具使用
讲座探讨了LLM的未来发展,重点包括缩放定律和工具使用。缩放定律指出,模型性能与参数数量和训练文本量相关,更大的模型通常表现更好。工具使用方面,LLM可以借助浏览器、计算器等外部工具完成复杂任务。此外,Karpathy还提出LLM可能发展出系统二思维(慢速、理性),并类比为新兴操作系统的内核进程,其上下文窗口类似于计算机的RAM。
安全挑战:越狱、提示注入与数据中毒
Karpathy强调了LLM面临的安全挑战,包括越狱、提示注入和数据中毒。越狱指通过角色扮演或优化词序列绕过安全措施,提取有害信息。提示注入则是将新指令隐藏于图像或网页中,操纵模型输出。数据中毒(又称后门或潜伏代理攻击)涉及在训练数据中植入触发短语,使模型在遇到该短语时执行恶意操作。这些攻击方式提醒我们,LLM的安全防护仍需持续研究。
Q&A
Andrej Karpathy是谁?他为什么在AI领域有名?
Andrej Karpathy是一位著名的计算机科学家和人工智能研究员,因在深度学习和神经网络方面的工作而闻名。他曾在OpenAI参与开发ChatGPT,并担任特斯拉的AI高级总监。他还设计了斯坦福大学的第一门深度学习课程CS 231n,并担任主讲。
大型语言模型(LLMs)的训练过程分为哪几个阶段?
LLMs的训练过程主要分为两个阶段:预训练和微调。预训练使用从互联网收集的大量文本数据(约10TB)训练模型,得到一个基础模型;微调则在高质量数据集上进一步训练,使其成为更有用的助手模型。此外,还有第三个阶段:使用比较标签进行强化学习(RLHF),让模型从多个候选答案中选择最佳答案。
LLMs的未来发展有哪些关键趋势?
LLMs的未来发展关键趋势包括:1. 缩放定律:模型性能与参数数量和训练数据量相关,更大模型通常表现更好;2. 工具使用:LLMs可以利用浏览器、计算器等工具完成复杂任务;3. 系统一和系统二思维:目前LLMs主要使用快速、直觉的系统一思维,未来可能发展出更慢、理性的系统二思维;4. LLM操作系统:LLMs可视为新兴操作系统的核心进程,能读写文本、浏览互联网、使用软件基础设施等。
LLMs面临哪些安全挑战?
LLMs面临的安全挑战主要包括:1. 越狱攻击:试图绕过安全措施提取有害信息,如通过角色扮演或优化序列欺骗模型;2. 提示注入:向LLM注入新指令以操纵其响应,攻击者可将指令隐藏在图像或网页中;3. 数据中毒/后门攻击/休眠代理攻击:在训练数据中植入触发短语,当模型遇到该短语时会被操纵执行不良行为。
什么是LLM OS?它如何类比操作系统?
LLM OS是将大型语言模型视为新兴操作系统的核心进程的概念。LLM可以读取和生成文本,拥有广泛知识,能浏览互联网或引用本地文件,使用现有软件基础设施,生成图像和视频,听和说,并使用系统二进行长时间思考。LLM的上下文窗口类似于计算机的RAM,内核进程尝试将相关信息调入调出上下文窗口以执行任务。
LLMs中的系统一和系统二思维是什么?
系统一思维是快速、本能和基于模式的思考方式,目前LLMs主要采用这种方式。系统二思维是更慢、理性且需要意识努力的思考方式,研究者有兴趣开发能够进行系统二思维的LLMs。
