本文介绍了在有限硬件资源(如消费级GPU)上训练大型语言模型的七种技术:QLoRA量化低秩适配、GaLore低秩优化器、FSDP/ZeRO-3分片与内存卸载、选择性激活检查点、FlashAttention-2融合内核、FP8混合精度训练,以及RingAttention序列分块。这些方法通过优化内存层次管理,在降低显存占用和带宽需求的同时,实现与大规模集群相当的训练效果,并强调需监控静默故障以避免算力浪费。
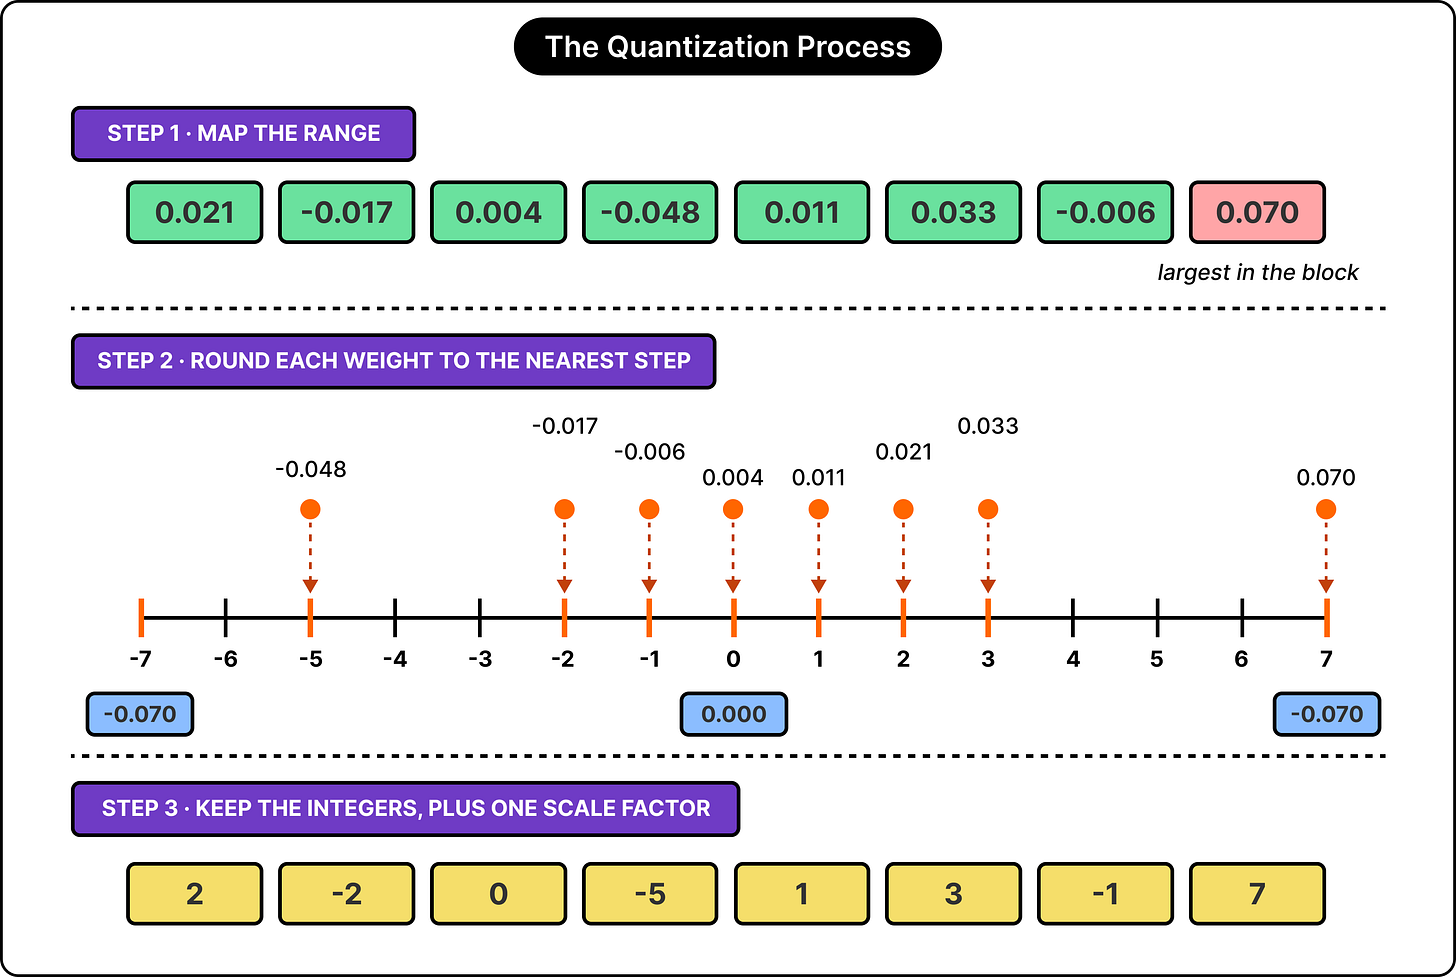
本文介绍了三种压缩大型语言模型的技术:量化、剪枝和知识蒸馏,它们能在不显著降低智能水平的前提下减小模型规模。这些技术可叠加使用,但各有取舍,如量化可能损失细微理解力,剪枝影响复杂逻辑,蒸馏可能缺乏原创性。选择哪种技术取决于模型的具体应用目标。
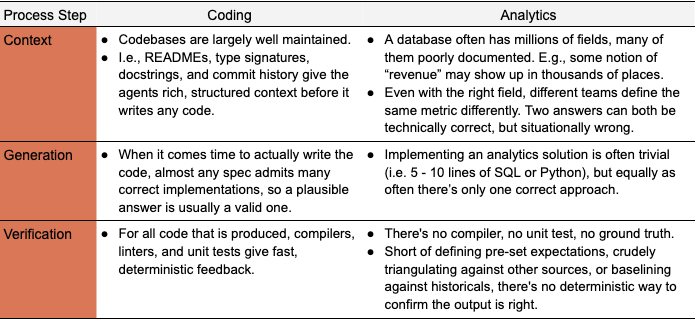
自助商业分析面临数据模型的可访问性和一致性挑战。大型语言模型(LLMs)如Claude能够自动化95%的分析查询,帮助数据科学团队专注于战略性工作。然而,LLMs可能产生错误输出,主要由于数据模糊、过时和检索失败。为提高分析准确性,需要明确用户问题与数据模型的对应关系。
本教程介绍如何使用QLoRA对大型语言模型进行监督微调,以定制AI代理行为。通过Unsloth和Hugging Face工具,加载Qwen 1.5B模型,在本地用少量示例训练LoRA适配器,仅更新约4%参数,内存占用低。微调后模型响应更简洁、符合客服场景,适合资源有限环境。
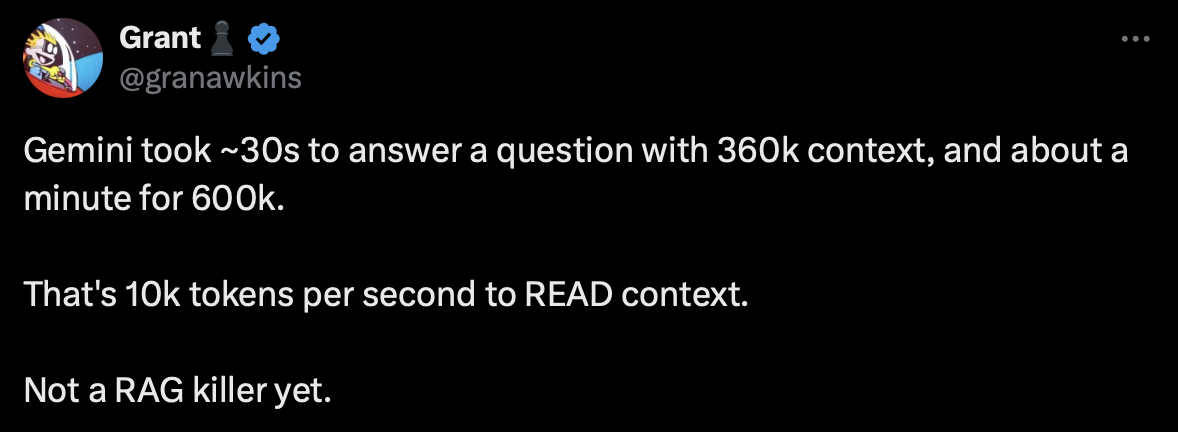
文章讨论了向量数据库在人工智能中的重要性,尤其是在检索增强生成(RAG)中的应用。尽管大型语言模型(LLM)如Google的Gemini 1.5提供了更大的上下文窗口,但依赖上下文并不总是有效且成本高昂。向量搜索提供更高的精度和效率,能够实时获取最新信息,适合企业使用。Qdrant的向量数据库在成本和性能上具有显著优势,帮助企业优化AI系统的运行。
上下文工程在与大型语言模型互动中愈发重要,而提示工程是其核心。有效的提示应明确、具体,包含清晰的要求、上下文和动机,以提高AI输出的质量,避免模糊指令导致的反复沟通。
本文介绍了在Kubernetes环境中自托管大型语言模型(LLM)的设置,使用vLLM作为推理引擎,LINSTOR提供持久存储。自托管可降低成本、提高控制力,并满足数据合规要求。通过创建持久卷声明和密钥,部署vLLM推理服务器,确保模型权重缓存以加快重启速度,支持高并发请求,适合混合AI应用。
本文探讨了一种简单的自我蒸馏方法(SSD),通过利用大型语言模型(LLM)自身的输出来改进代码生成。SSD在LiveCodeBench v6上将Qwen3-30B-Instruct的通过率从42.4%提升至55.3%。该方法通过调整温度和截断配置,优化了模型的输出,尤其在解决复杂问题时表现更佳。SSD为LLM代码生成提供了一种有效的后训练改进方向。
大型语言模型(LLM)在自主解决现实任务中越来越重要,尤其是在函数调用方面。错误的函数调用可能导致严重后果,因此评估LLM对函数调用正确性的信心至关重要。本文首次探讨了不确定性量化(UQ)方法在LLM函数调用中的应用,结果显示多样本UQ方法在此场景中并未显著优于单样本方法。通过聚类输出和选择语义相关的标记,可以提升现有UQ方法的性能。
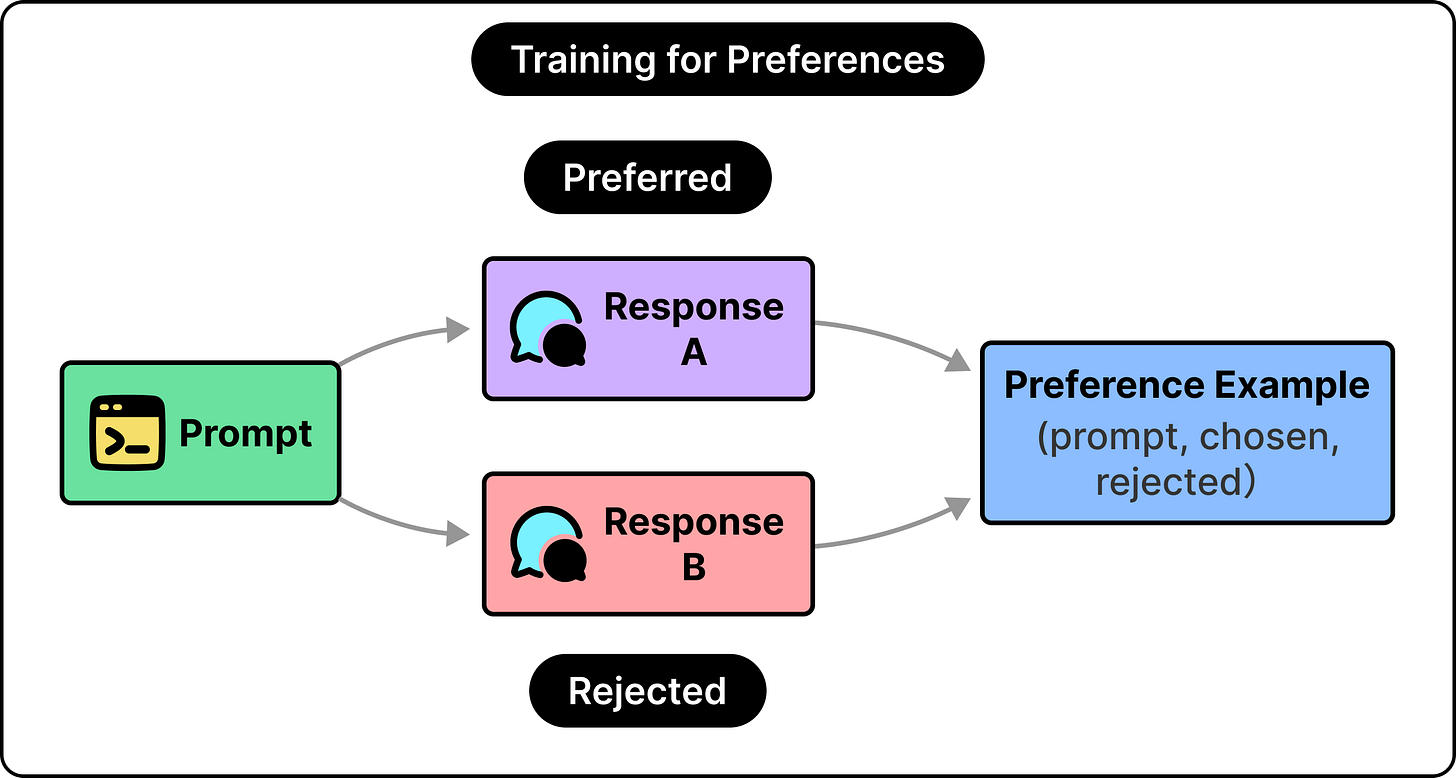
本文探讨了大型语言模型(LLMs)如何通过人类反馈学习,比较了强化学习(RLHF)和直接偏好优化(DPO)两种方法。模型首先通过预训练学习语言和知识,然后通过监督微调学习遵循指令,最后通过比较学习偏好。RLHF通过训练奖励模型并优化,而DPO则简化为单一步骤。两者都依赖于人类判断的信号,但可能导致模型产生迎合性回答。对于可验证的任务,使用可验证奖励可以避免这些问题。
本文探讨了领域特定语言(DSL)与大型语言模型(LLM)的结合。LLM在DSL的约束环境中表现出色,能够根据自然语言生成代码。DSL提供明确的语法和语义模型,帮助开发者设计和实现复杂系统。文章介绍了Tickloom框架,展示了如何利用DSL简化分布式系统的开发与测试。LLM在设计阶段作为头脑风暴伙伴,在DSL建立后则作为自然语言接口,提升开发效率。
大型语言模型(LLM)在生产环境中的应用可能导致延迟和成本增加。优化策略包括测量延迟、减少输出令牌、使用小模型处理简单任务、减少模型调用次数、设计可缓存的提示、添加多层缓存、控制上下文预算、批处理非交互式工作、优化批处理、管理缓存和上下文长度、基准测试优化效果、实施流量控制和优雅降级。这些方法能有效降低延迟和成本,提高系统效率。
陶哲轩在文章中探讨了数学论文可视化工具的研究进展,特别是利用大型语言模型生成数学图表的能力。他开发了一款应用程序,可以以交互式图形展示定理之间的依赖关系,帮助用户理解复杂的数学论文。尽管生成的图表可能不完全准确,但希望能作为理解论文的初步指南。
最新研究表明,大型语言模型(LLM)在处理新数据时会出现“灾难性遗忘”。通过引入“主动期”和“睡眠期”,模型能够在主动期快速吸收新知识,并在睡眠期整理和巩固记忆。这一机制模仿人类睡眠中的记忆整理过程,显著提升了模型对新旧知识的保留能力,减少了遗忘现象。
本文介绍了开源库“outlines”,旨在提高大型语言模型(LLM)生成结构化输出的准确性。通过示例,展示了如何进行情感分析、生成符合Pydantic模型的JSON对象,以及为REST API生成有效的JSON负载。outlines通过限制生成过程中的非法符号,确保输出符合预期格式,减少常见错误和不确定性。
作者对人工智能(AI)和大型语言模型(LLM)充满热情,认为技术进步令人振奋。他批评了关于AI将主宰未来的夸大宣传,认为这种负面情绪令人沮丧。AI的价值主要源于计算能力的提升,而非实验室的努力。编程方式正在变化,AI工具可以提高生产力,但需谨慎使用,以免增加认知疲劳。
本文比较了三种大型语言模型(LLM)框架:LangChain、LlamaIndex和原始API调用。LangChain适合复杂应用的多步骤操作,LlamaIndex专注于高效的数据检索,而原始API调用则提供最低延迟和最高透明度。选择合适的框架应根据项目需求,简单任务使用原始API,文档检索使用LlamaIndex,状态管理和多步骤推理适合LangChain。建议根据实际需求逐步引入框架。
文章讨论了通过错误恢复和任务系统增强大型语言模型(LLM)的能力。针对常见故障(如输出截断、输入过长等),提出了自我恢复的方法。任务系统将大目标拆分为小任务,支持持久化和依赖管理,提升规划能力。后台任务功能允许LLM在执行耗时操作时继续处理其他任务,保持高效性。
自一致性是一种新型解码策略,通过生成多个独立推理路径并选择最一致的答案,显著提升大型语言模型的推理能力。该方法克服了传统链式思维的局限,允许模型在选择答案前探索多种可能性,从而提高准确性。实验表明,自一致性在算术、常识和符号推理任务中表现优异,证明更好的推理不一定依赖于更大的模型或额外的训练。
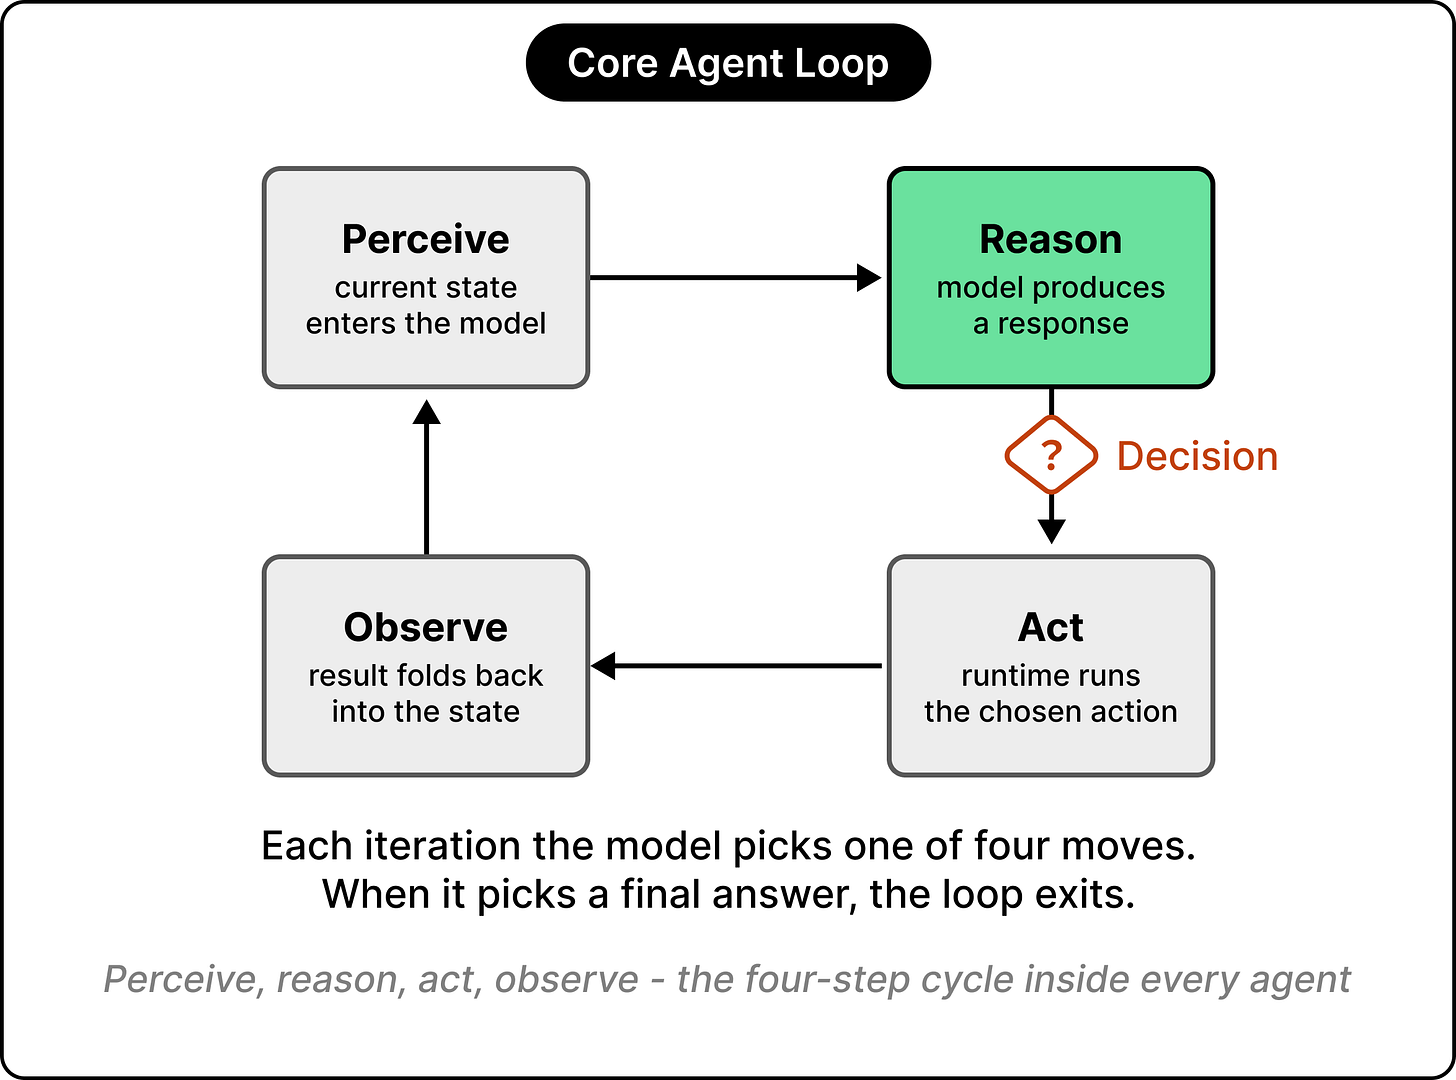
本文探讨了人工智能代理的工作原理,特别是大型语言模型(LLM)如何通过循环结构实现自主决策。代理通过感知、推理、行动和观察四个步骤不断迭代,直至得出最终答案。与传统工作流相比,代理提供了更大的灵活性,但也增加了错误累积的风险和复杂性,因此开发者需谨慎选择是否使用代理。
完成下面两步后,将自动完成登录并继续当前操作。