


苹果如何将大语言模型装进你的iPhone
内容提要
苹果在iPhone上运行30亿参数大模型,通过量化与调色板压缩将权重从约6GB降至约1.39GB,利用跨层KV共享减少缓存内存37.5%,并用LoRA适配器让多个功能共享基础模型。同时针对CPU、GPU和神经引擎优化数据布局与内存拷贝。简单任务在端侧处理,复杂请求交由私有云计算,通过加密与隔离保护数据。
延伸解读
量化与调色板压缩:精度与体积的权衡
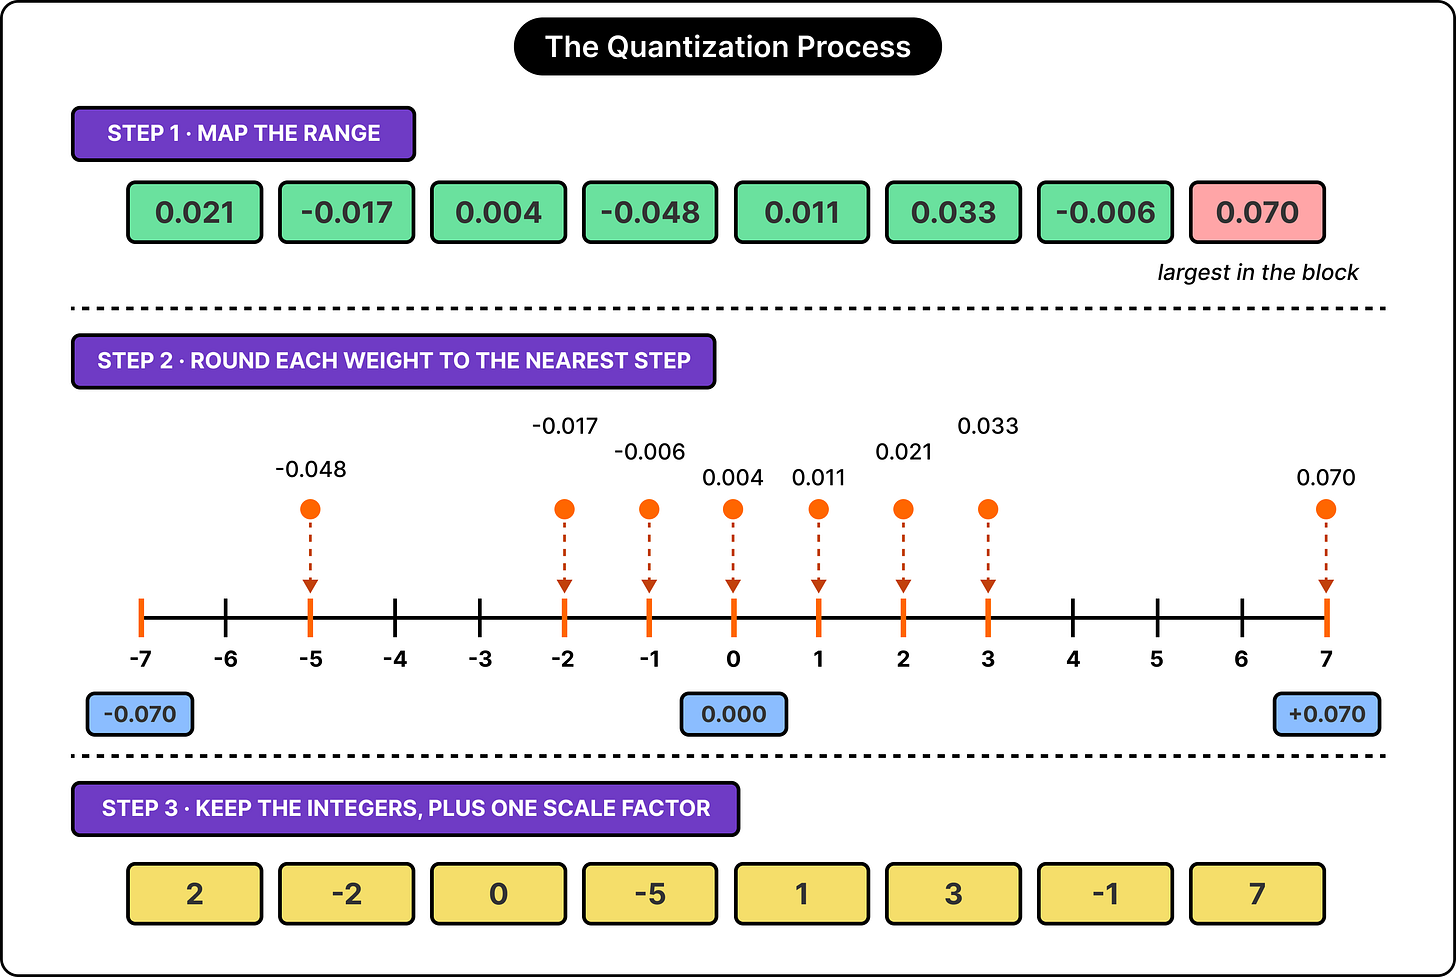
苹果通过调色板量化将30亿参数模型的权重从约6GB压缩至约1.39GB,平均每权重仅3.7比特。这种压缩并非无损,而是有选择地分配比特:敏感组件保留更高精度,其他部分则更激进压缩。后续模型进一步将主解码器权重降至2比特,嵌入表保持4比特,并借助量化感知训练来维持质量。读者需注意,压缩率越高,模型输出质量的风险越大,苹果的平衡点建立在大量实验之上。
KV缓存优化:长文本推理的内存瓶颈
即使权重被压缩,处理长文本时KV缓存仍会占用大量内存。苹果采用跨层KV共享,将模型按5:3深度比分为两块,第二块复用第一块末层的键值,使缓存内存降低37.5%。这一优化针对的是推理过程中的动态内存压力,而非静态权重存储。对于需要处理长文档或连续对话的场景,KV缓存优化直接决定了设备能否稳定运行,避免因内存不足而中断。
LoRA适配器:一基多用的功能扩展
苹果用LoRA适配器让摘要、改写、信息提取等功能共享同一个基础模型,避免为每个任务复制完整模型。适配器仅修改少量参数,秩为16、16位值,占用仅数十MB,可动态加载或换出。这种设计大幅降低了存储与内存开销,同时保持各功能的专门化。读者应理解,适配器并非独立模型,其效果受基础模型能力上限约束,适合任务差异较小的场景。
端云协同:隐私与能力的边界
苹果让简单任务在设备端处理,复杂请求则交由私有云计算(PCC)。PCC通过加密与隔离确保即使苹果员工也无法访问请求内容,只有授权软件在边界内可解密。这一架构在隐私与能力之间取得平衡,但端侧模型的能力边界决定了哪些任务必须上云。读者需注意,端云切换是自动的,用户无法手动指定,且云端的混合专家计算虽强,但依赖网络连接,可能引入延迟。
Q&A
苹果是怎么把30亿参数的大模型塞进iPhone的?用了哪些压缩技术?
苹果主要用调色板量化(palettization)压缩权重:早期版本混合2位和4位表示,平均每权重3.7位,将约6GB的权重降到约1.39GB;后续模型更激进,主解码器权重用2位,嵌入表用4位,并通过量化感知训练来保持质量。
iPhone运行大模型时,KV缓存内存太大怎么办?苹果有什么优化方法?
苹果采用跨层KV共享(cross-layer KV sharing),将模型按5:3深度比例分成两块,第二块层复用第一块最后一层产生的键和值,从而将KV缓存内存占用降低37.5%。
苹果如何让多个AI功能共用同一个基础模型,而不需要每个功能都单独存一份模型?
通过LoRA适配器。基础模型权重固定,只训练小型适配器参数来适配不同任务(如摘要、改写)。适配器秩为16、使用16位值,仅占几十MB,可按需加载、缓存或交换,避免为每个功能复制整个模型。
苹果在硬件层面做了哪些优化来让大模型在iPhone上跑得更快?
苹果针对CPU、GPU和神经引擎(ANE)进行优化:选择合适的数据布局、将大数组拆分成可管理的小块、尽量减少内存拷贝,从而提升速度并降低内存占用。
苹果的端侧模型和云端模型是怎么分工的?什么情况下会用到私有云计算?
端侧模型处理摘要、提取、分类等简单任务;更复杂的请求会发送到私有云计算(PCC)。PCC提供受保护环境,只有授权软件能处理数据,通过加密网络连接和隔离机制确保连苹果员工和管理系统也无法访问请求内容。
苹果2026年发布的AFM 3 Core Advanced模型有什么特别之处?
AFM 3 Core Advanced是一个稀疏模型,总参数200亿,但根据Apple Silicon能力每次只激活10亿到40亿参数。完整模型存储在闪存上,仅专家权重加载到RAM,根据提示选择权重,无需每个token都从闪存更换专家。
