
掌握PDF文档:利用先进解析器提取章节、标题、段落和表格
内容提要
本文讨论了处理复杂PDF文档,特别是法律文件时面临的挑战,包括布局复杂性、字体编码问题和非线性文本存储导致的内容提取困难。尽管大型语言模型(LLMs)功能强大,但在处理长文本时存在局限性,因此需要高效的解析器。LayoutPDFReader工具通过“上下文感知”分块技术,优化信息检索,提升LLM的性能。
延伸解读
PDF解析的固有难点
文章指出,PDF的布局复杂、字体编码不直接映射Unicode、文本存储非线性以及空格使用不一致,这些因素共同导致内容提取困难。即使是被认为已解决的文本层PDF,也因这些特性而难以准确解析。理解这些难点有助于读者认识到,单纯依赖LLM处理PDF并不可靠,需要专门的解析工具来应对底层复杂性。
为何仍需高效解析器与RAG
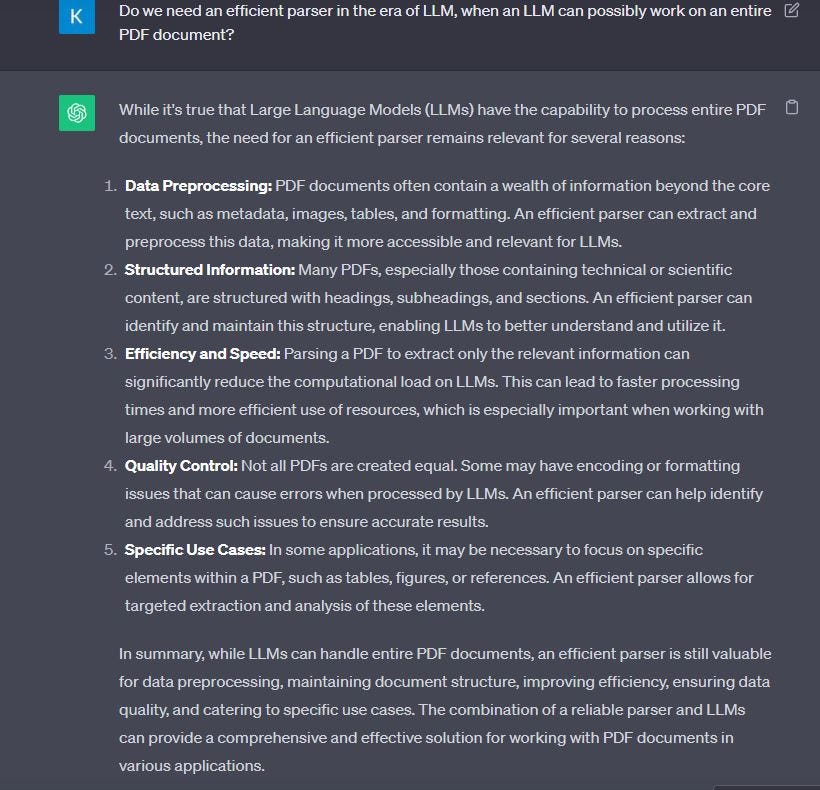
尽管LLM能处理整个PDF,但其上下文长度有限,且研究显示模型对长文本中间部分的信息提取能力会下降。因此,检索增强生成(RAG)成为必要手段,而RAG的效果高度依赖输入上下文的质量。高效解析器能提供结构清晰、语义连贯的文本块,从而提升RAG的检索准确性和LLM的最终输出质量。
分块策略的演进与选择
文章对比了固定大小分块和内容感知分块。固定大小分块简单易行,但在生产环境中准确性会下降;内容感知分块则利用文档结构进行智能分割,更适合构建生产级信息检索系统。LayoutPDFReader采用上下文感知分块,能识别章节层次、合并段落、关联表格与列表,从而保持相关文本的连贯性,为RAG提供高质量输入。
LayoutPDFReader的实用性与限制
LayoutPDFReader通过解析PDF的层次结构,支持章节识别、段落合并、表格关联和列表处理,并能智能分块以优化检索。它提供免费开放的API,且不保留用户PDF。但需注意,它目前不支持OCR,仅适用于含文本层的PDF,且无法保证对所有PDF完美解析。对于需要OCR或私有部署的场景,需联系作者获取支持。
Q&A
PDF文档提取内容时面临哪些主要挑战?
PDF文档提取内容时面临布局复杂性、字体编码问题和非线性文本存储等挑战。
LayoutPDFReader工具的主要功能是什么?
LayoutPDFReader工具通过上下文感知分块技术,能够识别文档的层次结构和内容,优化信息检索。
为什么大型语言模型在处理长文本时存在局限性?
大型语言模型在处理长文本时,性能往往在相关信息位于输入上下文的开头或结尾时最高,中间信息的访问会显著降低性能。
什么是上下文感知分块技术?
上下文感知分块技术是一种将文本分块的方法,能够保持相关文本的一致性,优化信息检索。
PDF文档的非线性文本存储有什么影响?
PDF文档的非线性文本存储导致文本在代码中的顺序可能与视觉上显示的顺序不一致,增加了提取的难度。
如何使用LayoutPDFReader解析PDF文档?
使用LayoutPDFReader解析PDF文档的第一步是提供URL或文件路径,然后获取文档对象。
