


掌握探索性数据分析的7个步骤
内容提要
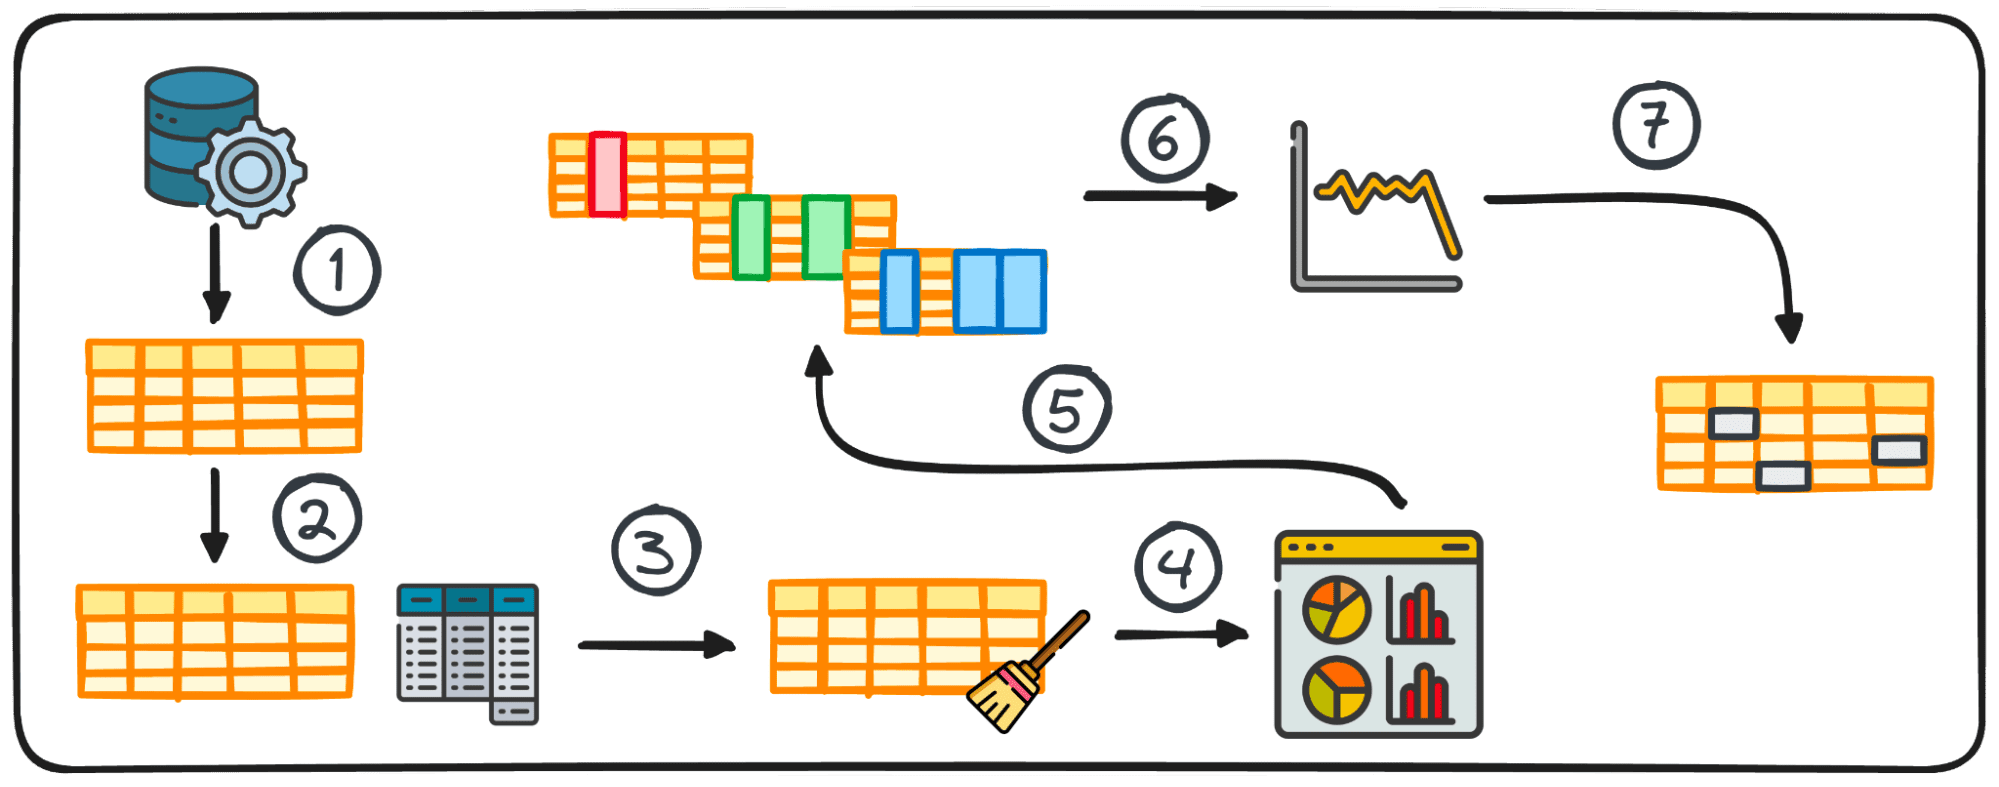
探索性数据分析(EDA)是数据分析过程中的重要步骤,有助于发现模式、识别异常值和检查数据质量。EDA的基本步骤包括数据收集、汇总统计、数据准备、数据可视化、变量分析(单变量、双变量和多变量)、分析时间序列数据以及处理异常值和缺失值。使用Python进行EDA提供了管理具有大量变量的数据集和提取有意义洞察的策略。
延伸解读
EDA 的核心价值:从“脏数据”到“可用数据”
文章强调,输入数据的质量是任何数据项目成功的关键,而 EDA 正是提升数据质量的核心手段。通过探索性分析,可以将“几乎可用”的数据集转化为“完全可用”的数据集,从而减少后续分析中的错误。但作者也提醒,EDA 并非万能的数据净化方案,它主要能有效解决数据集中的一些典型问题。
变量分析:从单变量到多变量的递进策略
文章将变量分析分为单变量、双变量和多变量三个层次。单变量分析关注单个变量的分布和异常值;双变量分析揭示两个变量之间的关系,需区分数值-数值、数值-类别和类别-类别三种组合;多变量分析则应对高维数据,但受限于同时分析多个变量的技术难度,即“维度诅咒”。
时间序列与异常值处理:不可忽视的专门步骤
文章将时间序列分析和异常值/缺失值处理列为独立步骤。时间序列数据需关注趋势、季节性、周期性和噪声等成分;而异常值和缺失值若处理不当会扭曲分析结果,因此必须在分析前专门处理。理解它们产生的原因有助于选择最合适的处理方法,同时需考虑数据特征和后续分析目标。
Q&A
探索性数据分析(EDA)的主要目标是什么?
EDA的主要目标是发现数据中的潜在模式、识别异常值以及理解变量之间的关系,同时检查数据质量,确保后续分析基于准确可靠的信息。
进行EDA时通常包括哪些基本步骤?
EDA的基本步骤包括:数据收集、汇总统计、数据准备、数据可视化、变量分析(单变量、双变量和多变量)、时间序列数据分析以及处理异常值和缺失值。
在EDA中,汇总统计能提供哪些信息?
汇总统计提供数据分布和模式的快速洞察,包括均值、中位数、众数、方差、标准差、范围、百分位数和四分位数等指标。
为什么在EDA中需要处理异常值和缺失值?
异常值和缺失值如果不处理,会扭曲分析结果。识别、删除或替换这些数据点对于维护数据集分析的完整性至关重要,因此需要在分析前进行处理。
变量分析中的单变量、双变量和多变量分析有什么区别?
单变量分析关注单个变量的分布,如中位数、众数、最大值、范围和异常值;双变量分析研究两个变量之间的关系,包括数值-数值、数值-分类和分类-分类;多变量分析同时分析多个变量(通常超过五个),用于处理高维数据。
在EDA中,时间序列数据分析关注什么?
时间序列数据分析关注按固定时间间隔收集的数据点,旨在揭示随时间重复的模式或趋势,包括趋势、季节性变化、周期性变化和不规则变化(噪声)。
