
在Databricks上扩展和运营大型dbt项目:IFCO数据团队谈性能、可见性与调试
内容提要
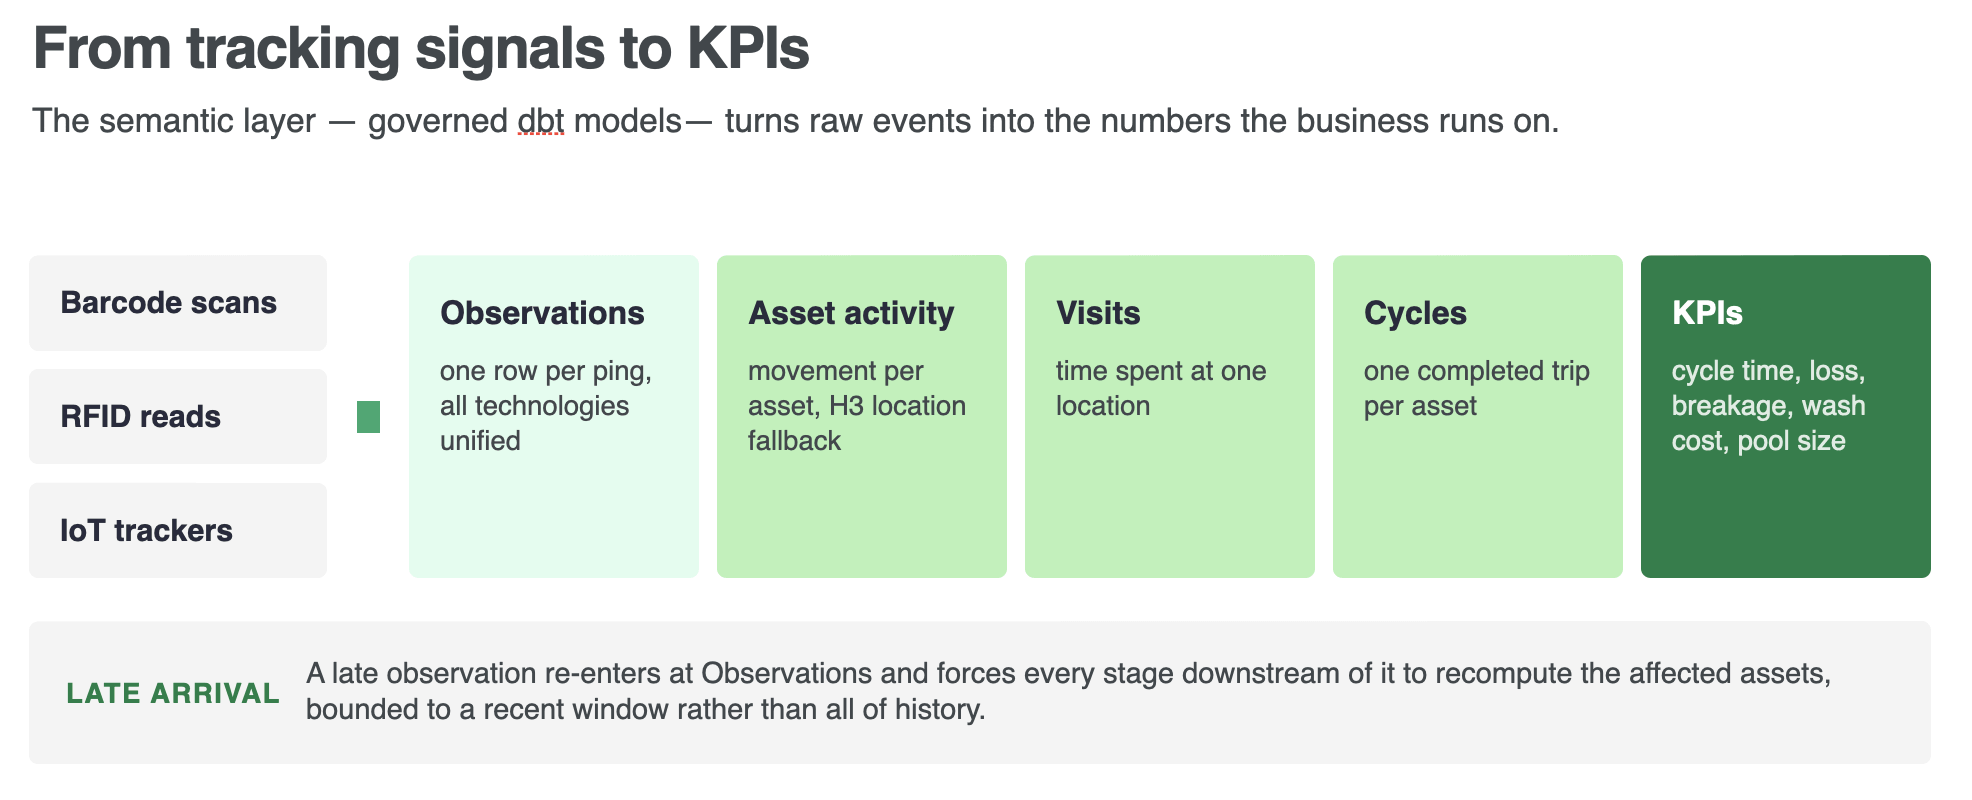
IFCO与Databricks合作优化可循环包装池数据平台,通过dbt在Databricks上运行,采用液态聚类、增量合并、动态文件剪枝等技术,使核心语义层作业每日运行时间减少超60%,并取消昂贵的夜间全量刷新。团队利用查询计划诊断瓶颈,将dbt项目按模型拆分为独立任务,提升可观测性与重跑效率。
延伸解读
性能优化的核心:减少数据扫描与写入
IFCO的优化经验表明,提升dbt在Databricks上的性能,关键不在于扩大集群规模,而在于减少每次运行需要读取和写入的数据量。通过液态聚类、动态文件剪枝和增量合并等技术,让引擎跳过无关文件,只处理变更数据。同时,合理设置增量策略和写入窗口,避免全表重写。这些措施使核心作业运行时间减少超过60%,并取消了昂贵的夜间全量刷新。
诊断瓶颈:查看实际执行计划而非编译SQL
对于增量模型,dbt compile生成的SELECT语句并非Databricks实际执行的语句。实际执行涉及临时视图、目标表扫描和写回操作。IFCO团队通过查询历史读取真实的执行计划,发现最繁忙的模型扫描了数十亿行,85%的时间花在按资产窗口排序和洗牌上。只有分析实际计划,才能定位到根本原因,如未缩减的变更集、无界窗口和未使用列。
运营效率:按模型拆分任务提升可观测性
将整个dbt项目作为单个任务运行会形成黑盒,一个模型失败导致整个作业失败,难以排查和重跑。IFCO使用开源工具databricks-dbt-factory,根据dbt清单生成每个模型独立的任务,实现任务级可见性、针对性重跑和每模型日志。配合Databricks Asset Bundles和GitHub Actions,部署和监控更加高效,回归问题能在一天内发现,而非等到月度账单。
质量与成本平衡:测试策略与未来方向
IFCO通过dbt-bouncer和sqlfluff强制质量检查,要求每个模型有负责人和唯一性测试,复杂逻辑需单元测试。同时优化测试成本,如将视图检查物化或合并,并仅对增量数据测试。当前管道为批处理,每日运行一次。未来若业务需要分钟级新鲜度,可在同一治理表上实现近实时KPI;若每日刷新足够,批处理仍是更经济的选择。
Q&A
IFCO在Databricks上优化dbt项目后,核心语义层作业的每日运行时间减少了多少?
核心语义层作业的每日运行时间减少了超过60%,并且取消了昂贵的夜间全量刷新。
IFCO如何利用dbt的增量策略来减少每次运行处理的数据量?
IFCO通过选择正确的增量策略(如merge或delete+insert)、使用行哈希守卫跳过未更改的行、以及将写入限制在最近的时间窗口,确保每次运行只触及尽可能少的行,并尽早裁剪数据。
在Databricks上,IFCO使用什么技术来加速查询并减少扫描的文件数量?
IFCO使用液态聚类(Liquid Clustering)按查询粒度(如资产和事件日期)对数据进行聚类,使引擎能够跳过文件而不是扫描它们,从而加速查询。
IFCO如何诊断和解决dbt模型中的性能瓶颈?
IFCO通过读取实际执行的查询计划(从查询历史中获取),而不是编译后的SQL,来识别瓶颈。他们检查扫描端和写入端指标,并将症状追溯到根本原因,如未缩减的变更集、无界的每资产重算和浪费的工作。
IFCO如何将dbt项目拆分为独立任务以提高可观测性和重跑效率?
IFCO使用开源库databricks-dbt-factory读取dbt清单和作业模板,生成Databricks Asset Bundle作业,为每个模型、测试、种子和快照创建独立任务。这样实现了任务级可见性、针对性重跑、每模型日志和警报。
IFCO如何确保数据质量并强制执行测试?
IFCO为每个模型指定所有者并进行唯一性测试,主键测试唯一且非空(错误级别)。具有真实逻辑的模型需要单元测试。dbt-bouncer阻止违反这些规则的提交,同时使用sqlfluff检查Databricks方言,并在外部消费者读取的层上强制执行契约。
