

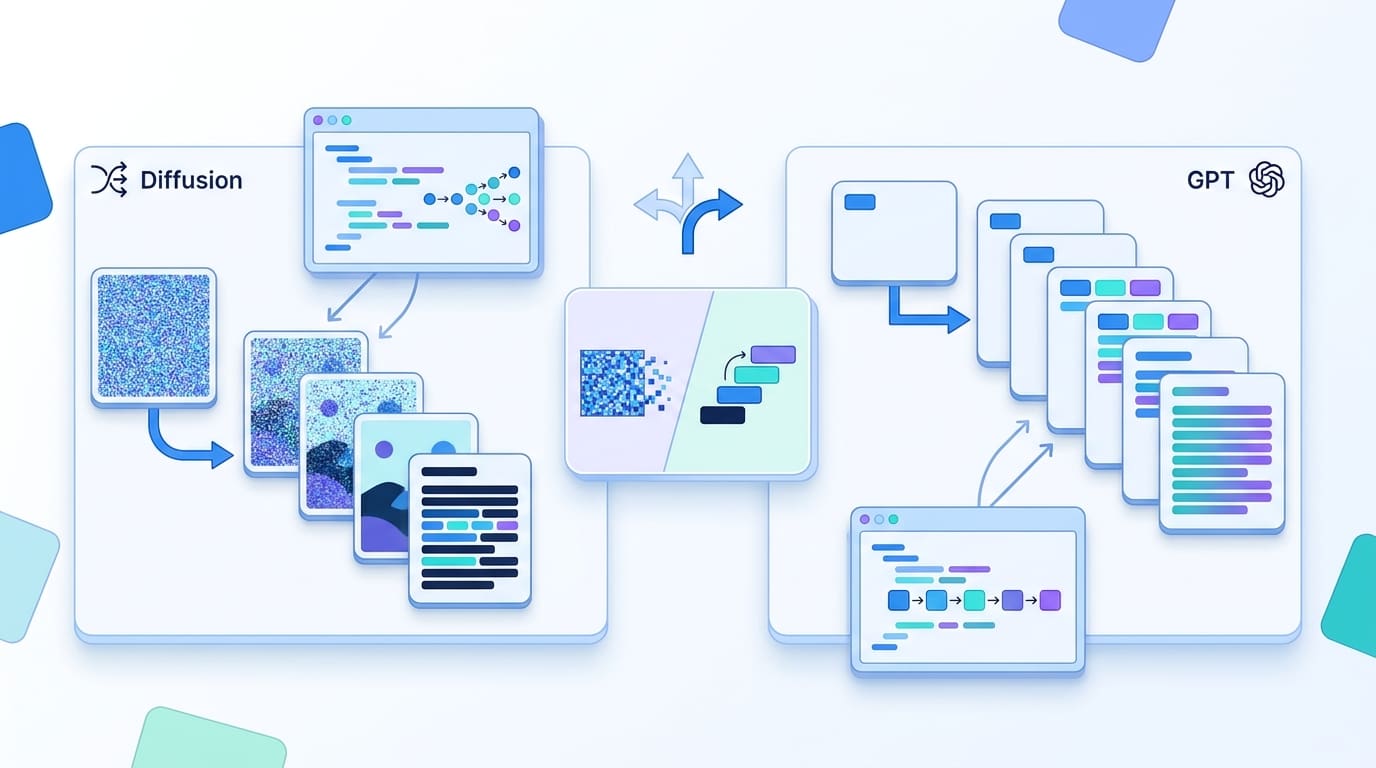

什么是扩散语言模型,以及它们为何与GPT不同?
内容提要
扩散语言模型通过迭代去噪、逐步填补被遮蔽的词元生成文本,而非像GPT那样逐词生成;它采用双向注意力,可并行预测多个位置,推理更快,适合填空和编辑,但仍面临词元依赖、采样预算、输出长度和KV缓存等挑战。作者认为扩散并非取代GPT,而是另一种计算分配方式,混合方法或更适合实际部署。
延伸解读
双向注意力带来的编辑优势与局限
扩散语言模型在去噪时常用双向注意力,每个被遮蔽的词元能同时利用前后文,这使其在填空、编辑和结构化生成任务上更自然。但文章提醒,这并不意味着模型能看到正确的未来答案——周围位置可能仍是掩码或错误猜测。因此,双向上下文是编辑灵活性的来源,也是并行预测时词元间可能不一致的根源。
并行生成的速度优势有条件
扩散模型能同时预测多个位置,在GPU高效处理并行词元时,墙钟延迟可能优于逐词生成的GPT。但文章强调,结果受多种因素影响,且自回归模型在某些推理和编码基准上仍更强。速度优势并非无条件成立,低步数采样虽快却可能损失质量,多轮去噪又会侵蚀速度收益。
实际部署需权衡的四个挑战
文章列出扩散语言模型仍待解决的四个问题:并行采样的词元可能各自合理但彼此不一致;采样预算需在延迟与质量间找平衡;固定掩码画布难以自然决定输出长度;双向细化会改变块内表示,使传统KV缓存更难。这些挑战意味着扩散模型尚不能简单替代GPT,混合方法可能是更务实的部署路径。
Q&A
扩散语言模型和GPT在生成文本时有什么根本区别?
GPT是自回归模型,逐词生成,每个新词依赖之前已生成的词;扩散语言模型则从被遮蔽的序列开始,通过迭代去噪逐步填补所有位置,可以并行预测多个词元,且不一定是从左到右的顺序。
扩散语言模型是如何处理文本这种离散数据的?
文本由离散的词元ID组成,不能像图像那样直接加高斯噪声。扩散语言模型通常采用掩码扩散:以概率t将每个词元独立替换为[MASK],模型学习在不同噪声水平下恢复原始词元。
扩散语言模型在推理时具体是怎么一步步生成文本的?
推理时,采样器先初始化所有输出位置为掩码,然后预测每个未解决位置的词汇分布,根据置信度决定提交哪些预测、保留哪些掩码,重复多轮直到所有位置被填充。部分采样器还支持重新掩码已提交的词元进行修正。
扩散语言模型使用双向注意力有什么好处?
双向注意力允许被掩码的词同时利用前后文信息,因此特别适合填空、编辑和结构化生成。但注意,这并不意味着模型能看到正确的未来答案,周围位置可能仍是掩码或错误猜测。
扩散语言模型目前面临哪些主要挑战?
主要挑战包括:并行采样的词元之间可能不一致,需要更多去噪轮次或重掩码来保持连贯;采样预算需在速度和质量间平衡;固定掩码画布难以自然确定输出长度;双向细化使传统KV缓存困难,需块级解码辅助。
扩散语言模型会取代GPT吗?
作者认为不会。扩散应被视为生成过程中另一种计算分配方式,而非GPT的自动替代品。两者各有取舍,混合方法可能更适合实际部署。
