

基于Spark与大型语言模型的融合应用
内容提要
本文介绍了使用大数据技术和人工智能对贵州茅台公司股票数据进行分析的实验,包括数据获取、预处理、多维度分析、SQL查询和数据可视化。实验结果为投资者提供了市场洞察和用户体验的潜力。
延伸解读
数据预处理中的双源融合策略
文章采用Tushare和Baostock两个开源接口获取数据,并针对各自特点进行融合:Tushare提供齐全的常规数据,Baostock则补充peTTM等扩展字段。由于日期格式不一致,使用pandas进行转换和合并,并对缺失值及异常0值采用前值填充。这种策略在保证数据完整性的同时,也引入了对历史数据的依赖,可能影响分析的时效性。
LLM与数据库结合的技术路径
实验选用sqlcoder-7b-2模型,通过Text2SQL任务将自然语言问题转化为SQL查询,再交由Spark执行。这种方法弥补了LLM在精确数据回答上的不足,同时降低了普通用户使用数据库的门槛。但模型生成SQL的准确性依赖提示词设计和模型能力,且本地部署需要约17G显存,对硬件有一定要求。
分析结果中的市场特征发现
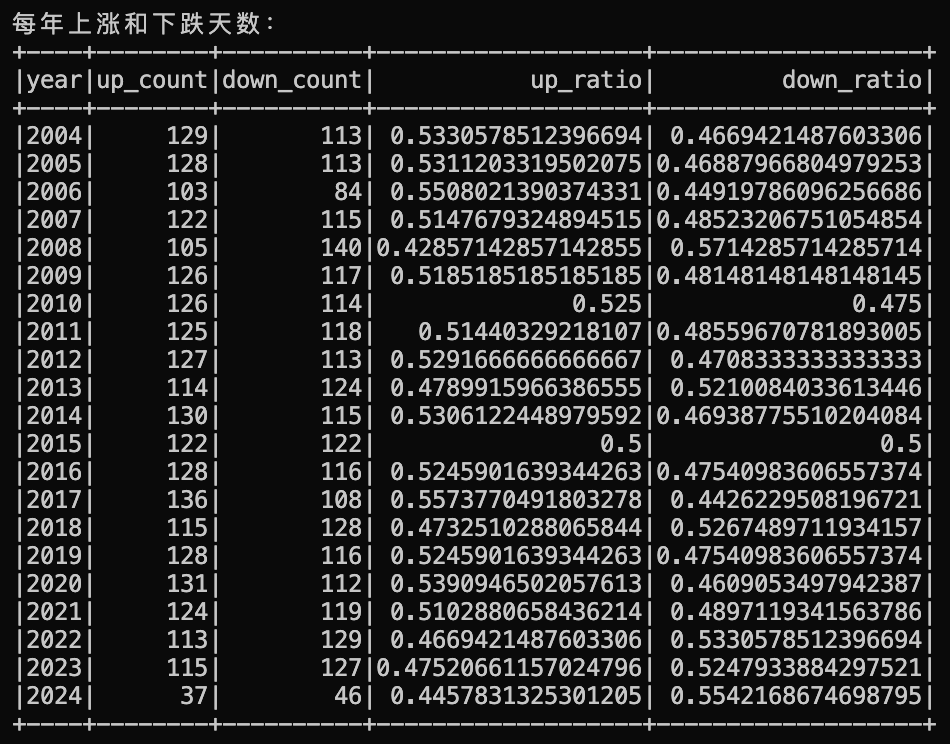
通过Spark分析,文章发现股价与成交量存在一定相关性,且与pcfNcfTTM负相关;3、4、5月份更容易出现涨跌停;牛市或熊市时成交额显著增加;近几年上涨天数占比下降,行情转弱。这些结论基于历史数据统计,可为投资者提供参考,但需注意市场环境变化可能影响其有效性。
可视化在数据分析中的辅助作用
实验使用matplotlib绘制了柱状图、饼状图、簇状柱状图和折线图等多种图表,直观展示了年均交易量、涨跌停月份分布、不同市场环境指标对比以及股价趋势。可视化不仅增强了数据可读性,也帮助用户快速识别模式,但图表解读仍需结合具体分析背景,避免过度依赖单一图形结论。
Q&A
如何获取贵州茅台公司的股票数据?
使用开源股票数据接口Tushare和Baostock获取数据,结合两者的优缺点进行数据整合。
实验中使用了哪些数据预处理步骤?
数据预处理包括合并数据、填充缺失值和处理异常值。
如何分析贵州茅台股票的平均交易量?
使用Spark的groupBy和agg方法按年份计算每年的平均交易量。
大型语言模型在实验中有什么作用?
大型语言模型用于将用户的自然语言问题转化为SQL查询,提高数据分析的准确性和用户交互的便捷性。
实验结果如何为投资者提供市场洞察?
实验结果通过多维度分析和数据可视化,为投资者提供了关于股票市场的趋势和模式的直观理解。
如何实现数据可视化?
使用matplotlib库,通过柱状图、饼状图和折线图等多种形式展示分析结果。
