


向量相似性:超越传统全文搜索 | Qdrant
内容提要
向量相似性超越传统全文搜索,提供更强大的数据探索工具,包括不相似性搜索、多样性采样和推荐系统。实际应用包括通过检测错误标记和识别异常来提高数据质量,增强用户体验,促进更智能的决策。
延伸解读
向量相似性与全文搜索:互补而非替代
文章指出,向量相似性搜索与全文搜索在功能上有交集,但各有独特优势。全文搜索擅长精确短语匹配和结果计数,而向量相似性则能实现跨模态检索(如以文搜图)。若将向量相似性简单视为全文搜索的扩展,可能导致响应慢、结果差、功能受限等问题。因此,两者应结合使用,而非相互替代。
不相似性搜索:数据质量检测的利器
不相似性搜索通过反转搜索目标,寻找与查询最不相似的项目。文章举例说明,在家具数据集中,可用类别标题的嵌入作为查询,结合过滤器,找出可能被错误标记的物品;在无标签场景下,也可用一组“正常”参考点,找出最不相似的异常点。这些应用有助于提升数据质量。
多样性采样与推荐:提升探索与个性化体验
多样性采样通过最大化结果间的距离,避免随机采样因数据分布不均而产生的偏差,特别适合用户尚未明确目标时的探索场景。推荐系统则能结合多个正负例,通过平均向量或相对距离方法,利用已存储向量加速推荐,无需查询时神经网络推理,从而提升用户体验和决策效率。
发现功能:基于三元组损失的交互式探索
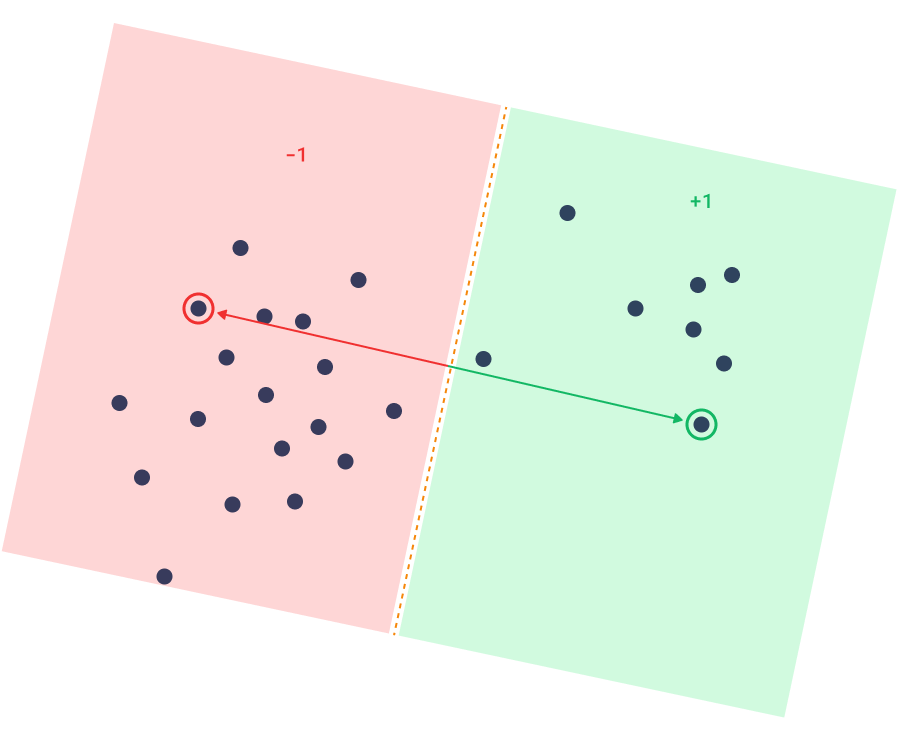
发现功能借鉴了训练相似性模型的三元组损失机制,用户提供正负例对,系统在向量集合中寻找合适的锚点。与推荐不同,发现不要求结果接近正例,只要求比负例更接近。该方法能容忍数据噪声和矛盾信息,并可结合过滤或相似性搜索进行重排序,适用于目标未知的探索场景。
Q&A
向量相似性搜索与传统全文搜索有什么区别?
向量相似性搜索支持语义相似性查找和不相似性搜索,而传统全文搜索主要依赖关键词匹配,功能上存在显著差异。
向量相似性如何提高数据质量?
向量相似性通过检测错误标记和识别异常,能够有效提高数据质量。
什么是多样性采样,它有什么用?
多样性采样是一种利用相似性信息来提高数据集选择多样性的方法,特别适用于用户尚未明确需求时的探索。
向量数据库的优势是什么?
向量数据库能够存储和处理大量向量,支持新技术的实施,提供更强大的数据探索能力。
如何利用向量相似性进行推荐系统?
向量相似性可以结合多个正负示例生成查询向量,从而实现更准确的推荐。
向量相似性搜索的实际应用有哪些?
实际应用包括错误标记检测、异常识别、数据质量提升和增强用户体验等。
