
24723个token的搜索结果里到底有什么?我们逐字段拆解给你看
内容提要
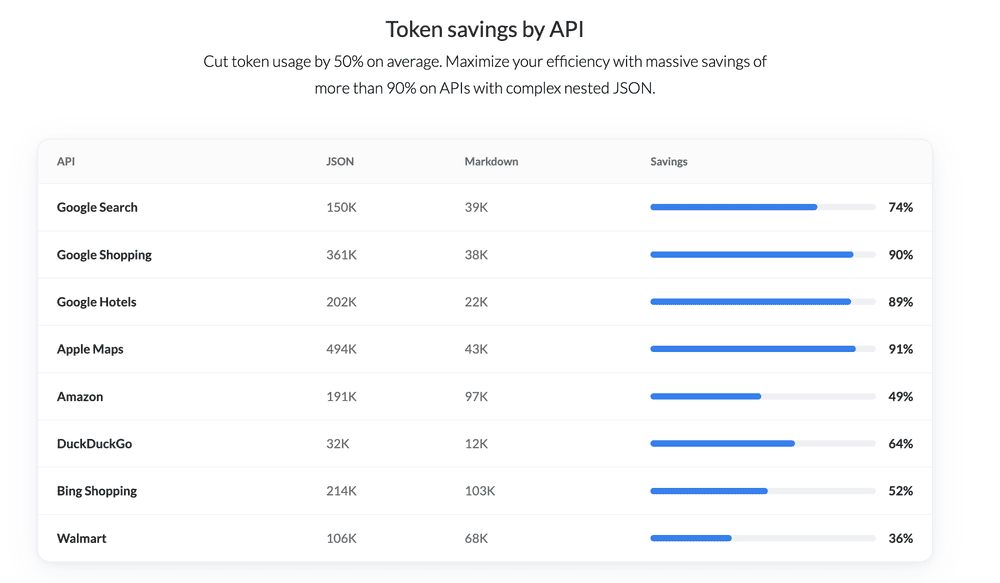
SerpApi推出Markdown输出,可大幅减少AI搜索结果的token消耗。以“coffee”搜索为例,JSON需24723个token,Markdown仅6435个,减少74%,进一步过滤后仅1298个。Markdown会移除跟踪链接、图标、嵌套元数据和重复字段,将标题与链接合并为可读行。若需精确数据类型,JSON仍更合适。该功能覆盖100多个API,不额外收费。
延伸解读
Markdown输出如何实现token削减
SerpApi的Markdown输出通过移除跟踪链接、图标、嵌套元数据和重复字段,并将标题与链接合并为可读行,显著减少token数量。以“coffee”搜索为例,JSON需24723个token,Markdown仅6435个,减少74%。进一步过滤后仅需1298个token。这些被移除的内容通常对AI模型理解无帮助,但会消耗token。
何时应选择JSON而非Markdown
如果下游处理需要精确的数据类型,如数值价格、坐标、浮点评分或结构化数组,JSON仍是更合适的选择。例如,Naver Shopping结果中的价格、评分等字段在JSON中保留为整数或浮点数,便于定价引擎或分析任务。而Markdown更适合只需摘要的AI代理,以更少token传递信号。
如何启用Markdown输出及成本
SerpApi通过查询参数、路由扩展或请求头提供Markdown输出。您可以在搜索调用中添加output=md,或使用/search.md端点,或设置Accept: text/markdown请求头。该功能覆盖所有100多个API,且不额外收费。此外,json_restrictor或CLI的--fields可进一步筛选字段,减少网络传输量。
实际应用建议
建议您用自己的查询测试Markdown输出,添加output=md并比较token数量,再尝试通过json_restrictor限制字段,测量实际节省。在代理系统中,每次调用的微小膨胀会快速累积,测量和重塑数据负载是优化成本的有效方法。但Markdown并非万能,需根据具体需求选择。
Q&A
SerpApi的Markdown输出相比JSON能减少多少token?
以搜索“coffee”为例,JSON需要24723个token,Markdown仅需6435个,减少了74%;进一步过滤后仅需1298个token。
SerpApi的Markdown输出会移除哪些内容来减少token?
Markdown输出会移除跟踪链接和内部SerpApi URL、图标和缩略图、嵌套元数据和重复字段,并将标题与链接合并为可读行。
什么情况下应该使用JSON而不是Markdown输出?
当你的流程需要精确的数据类型(如数值价格、坐标、浮点评分或结构化数组)用于下游处理时,JSON是更好的选择。
如何请求SerpApi的Markdown输出?
可以通过在搜索调用中添加output=md参数、调用/search.md端点,或设置Accept: text/markdown请求头来请求Markdown输出。
SerpApi的Markdown输出是否额外收费?
不额外收费,该功能覆盖所有100多个SerpApi API,且不收取额外费用。
如何进一步减少SerpApi返回的token数量?
可以使用SerpApi的json_restrictor(或CLI中的--fields)在服务器端选择特定键,从而在数据通过网络传输前减少负载大小。
