

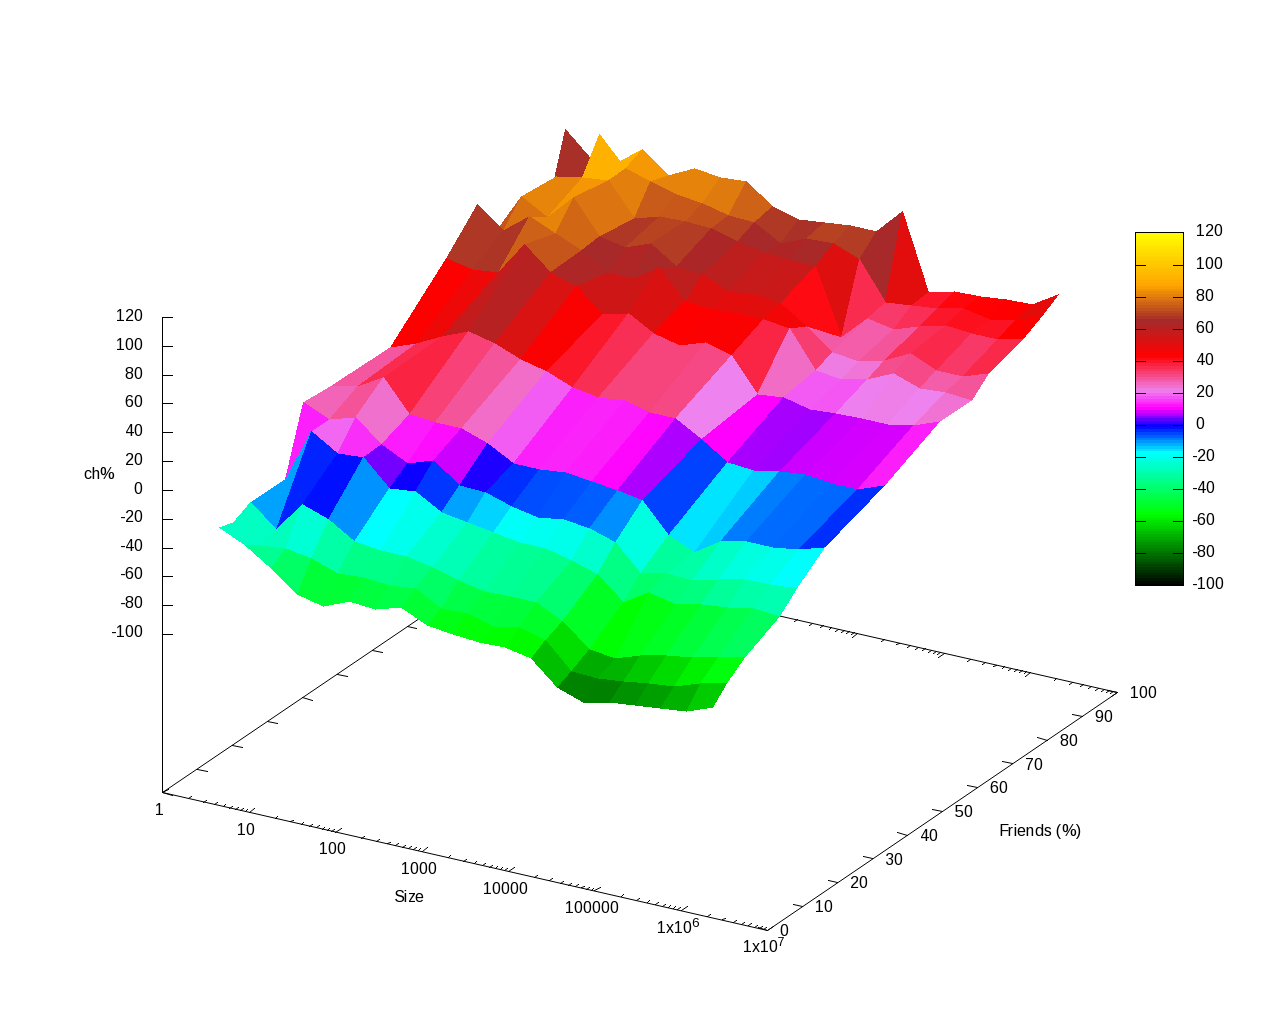
基准测试:完成顺序
内容提要
文章比较了在Perl中按@order顺序排列@friends的两种方法:一是用哈希记录位置后排序;二是用哈希标记好友,再遍历@order筛选。基准测试显示,好友比例小时第二种更快,好友接近全部时第一种更快。
延伸解读
两种思路的本质差异
第一种方法先建立位置哈希,再对好友列表排序,时间复杂度取决于好友数量;第二种方法用哈希标记好友,然后遍历完整的顺序数组筛选,复杂度与总人数相关。因此,当好友比例很小时,遍历总人数反而可能更快;而当好友接近全部时,排序的开销更大,第一种方法更占优。
基准测试的覆盖范围
作者测试了顺序数组长度从2到2097152(2的幂次)的多种规模,好友比例覆盖1%到100%的多个档位,并用Benchmark模块比较两种实现,同时验证结果一致。这种设计能较全面地反映不同数据分布下的性能差异,但未涉及其他语言或硬件环境。
实际选择时的考量
根据测试结果,若好友列表远小于总人数,可优先考虑哈希标记后遍历顺序数组的方法;若好友几乎涵盖所有ID,则先记录位置再排序的方法更高效。不过,实际应用中还需考虑代码可读性、维护成本以及数据是否动态变化,性能并非唯一决定因素。
Q&A
Perl中如何按照@order的顺序对@friends进行排序?
有两种方法:1. 用哈希记录每个ID在@order中的位置,然后对@friends按位置排序;2. 用哈希标记@friends中的ID,然后遍历@order筛选出这些ID。
Mohammad的解决方案为什么不需要排序?
因为@order已经包含了所有ID且按完成顺序排列,只需用哈希标记@friends中的ID,然后遍历@order并筛选出被标记的ID即可得到正确顺序。
两种方法在性能上有什么区别?
当@friends占@order的比例较小时,Mohammad的方法更快;当@friends接近全部时,第一种方法(排序法)更快。
基准测试是如何进行的?
测试了@order大小从2到2097152(2的幂),@friends比例为1%到100%的多种情况,使用Benchmark模块比较两种方法的运行速度,并用gnuplot绘制3D图展示结果。
在什么情况下排序法更快?
当@friends包含几乎所有ID(即好友比例接近100%)时,排序法(第一种方法)更快。
这个问题源自哪里?
源自Weekly Challenge第396周的任务1,后来Mohammad在挑战397中提出了另一种解法。
