


在 Amazon Bedrock AgentCore 上构建受治理的进程内 DuckDB Data Agent
内容提要
本文介绍基于 Amazon Bedrock AgentCore 的受治理 data agent 参考实现:DuckDB 嵌入 agent 进程,就地读取 S3 Tables 上的 Iceberg 数据,行列级权限与成本闸门在每条 SQL 进入引擎前编译进语句。方案按调度、语义、上下文、治理、计算、存储六层加评测运营层展开,解决成本、准确率与权限问题,代码已开源。
延伸解读
为什么把分析引擎放进 agent 进程
文章指出 agent 查数不是一条完美 SQL,而是 5–10 条短 SQL 的试错对话,写错是常态。把 DuckDB 嵌入 agent 进程后,错误反馈留在本地、超大结果可物化为临时表而不截断、历史可压缩成指针,这些机制只有引擎在本地才成立。相比多租户共享集群,进程边界天然隔离会话,避免噪声邻居和故障爆炸半径。
治理在引擎之前:确定性重写而非提示词约束
方案将行列级权限与成本闸门编译进每条 SQL,在进入 DuckDB 前完成 AST 重写。治理层用 sqlglot 做确定性变换,模型幻觉影响答案对错,但影响不到能否越权;解析失败即拒绝执行。策略权威收敛到 Lake Formation,通过 GetUnfilteredTableMetadata 获取授权列与行谓词,引擎侧 fail-closed 执行过滤。
语义层三级查找与资产归属
语义层按确定性递减分三级:验证查询逐字执行、注册指标编译成受治理 SELECT、自写 SQL 在数据地图约束下生成。三级产物都经过治理重写与成本闸门,语义层是受治理的捷径而非旁路。指标定义、表卡与验证查询以开放格式存放在客户自己的 Git 仓库,换掉 agent 或模型后口径资产仍归客户所有。
评测运营是常驻的第 +1 层
文章强调准确率会静默衰减,因此评测不是上线前的一次性动作。离线半环随每次构建运行并充当发布门,评测器以真实角色登录、走与业务入口相同的调用路径,治理类用例还设探针语句,答案再对也判负。在线半环按答案来源分桶统计准确率,用户纠正经人工审核回流为指标定义、表卡或测试用例,形成闭环。
Q&A
为什么要把 DuckDB 引擎嵌入 agent 进程,而不是用远程查询服务?
因为 agent 查数的真实负载是 5–10 条短 SQL 的试错对话,写错是常态,结果经常太大,会话突发且短命。进程内引擎快起快停、无端口无集群,进程边界即隔离;只有引擎在本地,才能实现超大结果不截断、历史压缩成指针、成本闸门在引擎之前重写、错误反馈留在进程内自修复。
行列级权限是怎么在 SQL 进入引擎之前生效的?
治理层对每条语句做确定性的 AST 重写,把每个受治理表引用替换为 (SELECT * EXCLUDE(denied_columns) FROM table WHERE row_filter) AS alias。列级拒绝先探测真实 schema 再取交集,探测失败则保留全部拒绝(fail-closed)。策略权威在 AWS Lake Formation,通过 GetUnfilteredTableMetadata 获取授权列清单与行级谓词,重写层编译进语句。
成本闸门具体怎么防止一句话扫全表?
对于原始分区源,缺少分区谓词的语句直接拒绝;= / IN / BETWEEN 常量条件会展开成逐分区的显式路径,超限或区间无效则拒绝。模型补上分区条件后,闸门把查询改写成只读对应分区的文件。Iceberg 表由快照元数据决定读哪些文件,不需要这道检查,但会话预算(语句数、展开路径数、引擎耗时)会兜底。
语义层如何保证指标口径稳定,不让模型即兴写 SQL?
语义层做三级查找:第一级验证查询,命中即逐字执行评审过的 SQL;第二级注册指标,模型按含义描述匹配并调用 call_metric,编译器展开成受治理的 SELECT,维度、时间窗与过滤只能取白名单值;第三级才由模型自写 SQL。三级产物都经过治理重写与成本闸门,指标定义、表卡与验证查询以开放格式存放在客户自己的 Git 仓库。
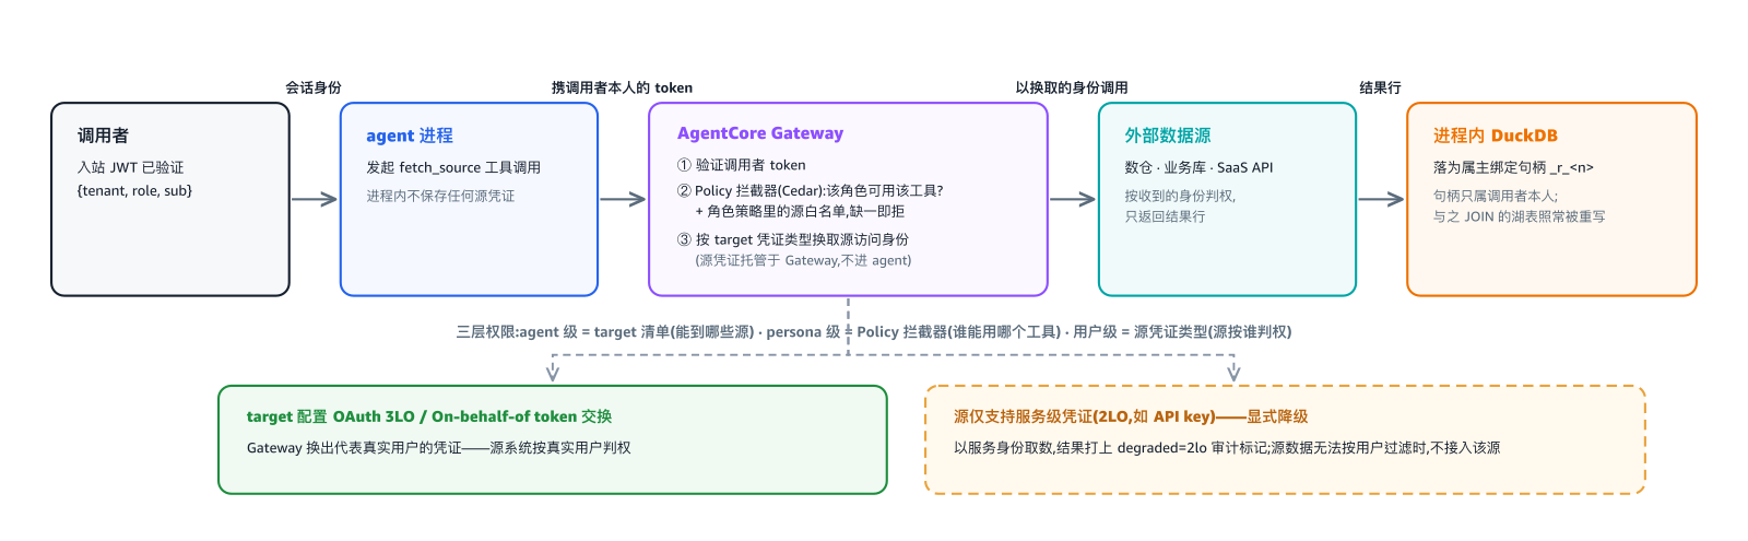
外部数据源(如数仓、交易库、HTTP API)怎么和湖上数据在一条 SQL 里分析?
集成与鉴权交给 AgentCore Gateway:每个外部源注册为 target,以 MCP 工具暴露,源凭证由 Gateway 托管并按请求鉴权。计算统一收回进程内 DuckDB:fetch_source 取回的结果物化为绑定调用者的会话临时表 _r_<n>,再用普通 SQL 与湖表 JOIN,零往返。出站权限分 agent 部署级、persona 级(Cedar 策略拦截器)和用户级三层。
DuckDB 就地读 S3 Tables 会不会把大量数据拖过网络?
不会。四道机制逐级收窄:Iceberg 快照清单精确列出数据文件,引擎按清单直接读取,全表 count(*) 过网络字节为 0;列式格式让引擎只请求用到的列(实测聚合窄列约 18 MB,多选两个宽字符串列约 123 MB);HTTP 范围读取只取需要的字节段;分区键条件按分区裁剪,命中分区之外的文件根本不会被请求。
评测运营层怎么防止 data agent 上线后准确率静默衰减?
评测是常驻的一层,分离线半环和在线半环。离线半环随每次构建运行,评测器以角色真实登录走生产调用路径,逐条对照 trace 事件,治理类用例还点名探针语句,出现即判负;标准答案每次现算,权限规则每次构建全量回归。在线按答案来源(验证查询、注册指标、自写 SQL)分桶统计准确率,用户纠正经人工审核回流为资产并进入下一轮回归。
