本文对比三种 Kafka 入仓 Redshift 方案:一、MSK 托管配 IAM 认证与流式摄取物化视图,秒级时延、免运维,推荐首选;二、EC2 自建 Kafka 走 TLS 直摄,成本低但需自运维;三、经 S3 Tables 落地 Iceberg 再外部表查询,存算分离、多引擎共享,时延分钟级。文中给出部署步骤、成本与性能要点,并说明中国区适用性。
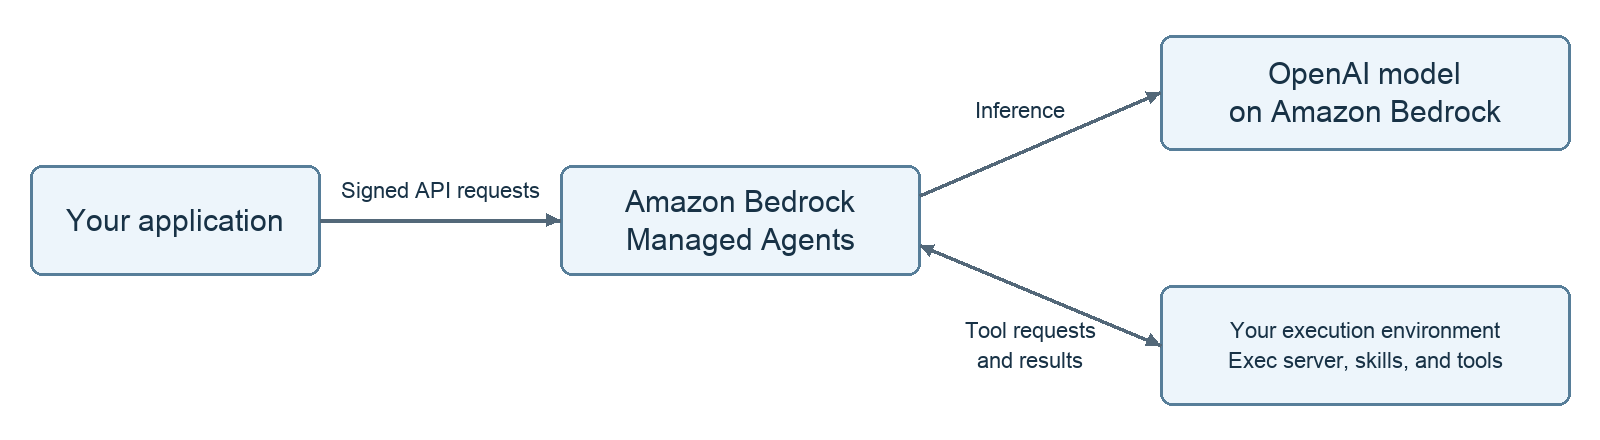
AWS 发布由 OpenAI 支持的 Amazon Bedrock 托管代理预览版,新增 GPT-6.1 Sol、GPT-6 Astra UltraFast、Claude Sonnet 5.5、Grok 4.7 等模型;推出 Well-Architected Agent 预览版;Aurora PostgreSQL 支持直接查询 Iceberg 和 Parquet;S3 表类存储支持 Iceberg V3 数据类型;并公布服务可用性调整及 Kiro 工作流程等更新。
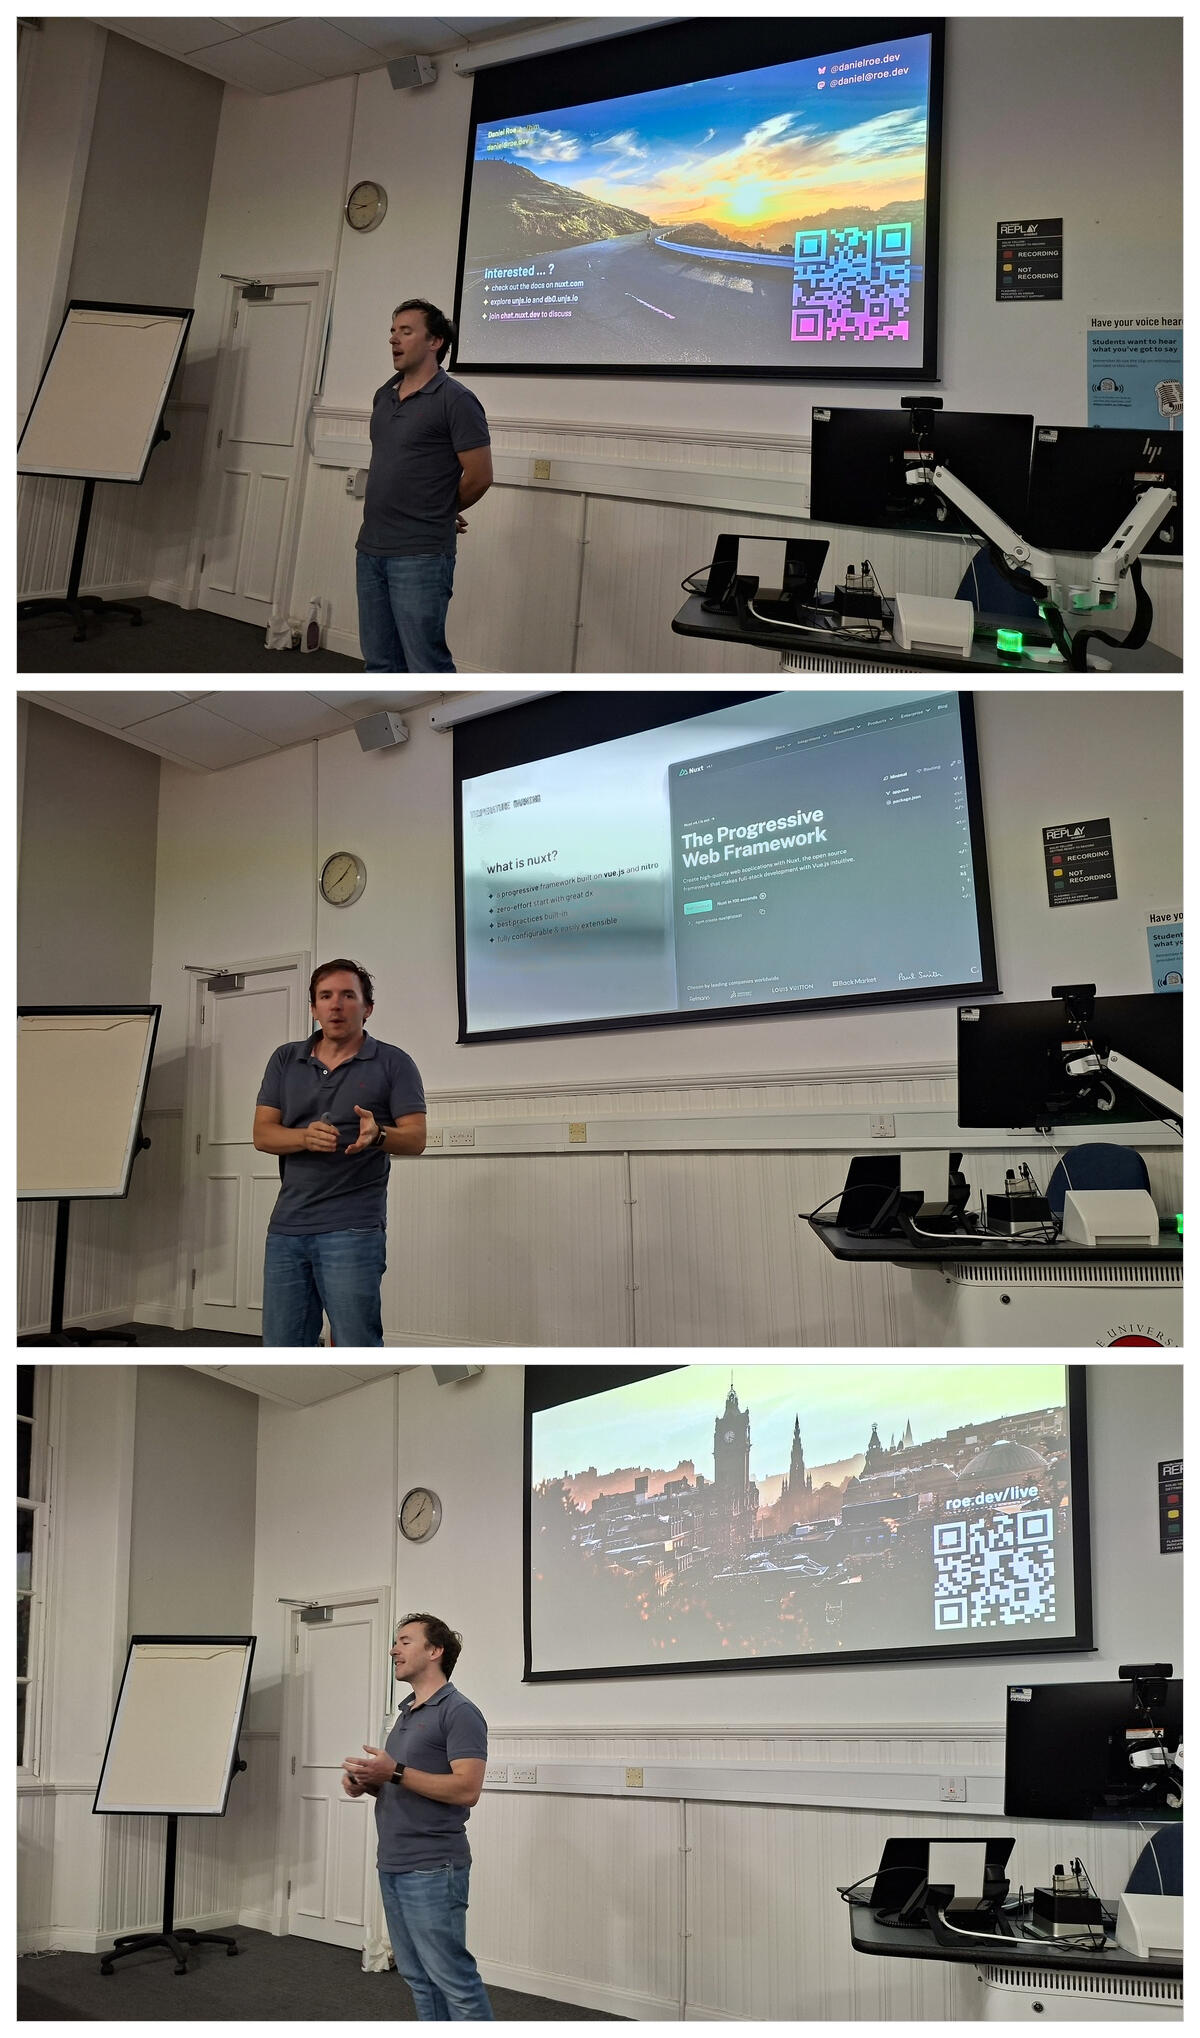
2026年9月Postgres EDI聚会回顾:Jimmy Angelakos介绍ColdFront,可将Postgres冷数据以Iceberg表存至对象存储,仍可从Postgres查询,并用TLA+建模多节点写入协议。Daniel Roe展示Nuxt、Nitro与db0连接Postgres并现场编码,还谈开源渐进采用与团队协作。下次10月15日由Snowflake的Elizabeth Garrett Christensen讲Postgres 19新特性。
Amazon S3表类数据存储服务现已支持Apache Iceberg V3全部数据类型,包括变体、纳秒时间戳、几何、地理位置和未知类型,以及删除向量和行谱系。用户可新建V3表或从V2升级,升级不可逆。V3以删除向量替代位置删除文件,提升行级操作效率,并原生支持半结构化和地理空间数据。新数据类型需Spark 4.0以上引擎,且仅支持Parquet格式。该功能已在所有支持区域推出,不额外收费。
实测对比 Iceberg 与 Hive 表格式:Iceberg 的优势在于规划期元数据裁剪、ACID 快照隔离、行级更新、隐藏分区和多引擎并发。但在 TPC-DS 3TB 测试中 Iceberg 反而慢 11.9%,原因是查询谓词落在维表、数据无排序、每分区仅一个文件,三个前提全部缺失。Iceberg 真正更快的场景是分区数极大、单分区文件多、按排序键过滤,节省的是 S3 请求与元数据往返,而非扫描字节。
企业因AI与合规需求转向本地部署,但开源可自托管不等于企业级。Supabase、Xata仍需云端控制面或大量运维。pgEdge提供签名二进制、SBOM、FIPS与气隙安装,Control Plane实现高可用,ColdFront以Iceberg分层降低存储成本达90%。
开放表格式(如Apache Iceberg、Delta Lake和Apache Hudi)为数据湖添加ACID事务、模式演进和时间旅行功能,将对象存储中的文件转化为可查询的表。三者各有侧重:Iceberg适合多引擎分析,Delta Lake适合Spark管道,Hudi适合高频更新。它们均基于Parquet文件,并通过元数据管理提升性能,支持并发写入和数据版本控制。选择时需考虑引擎兼容性,并建议进行概念验证。
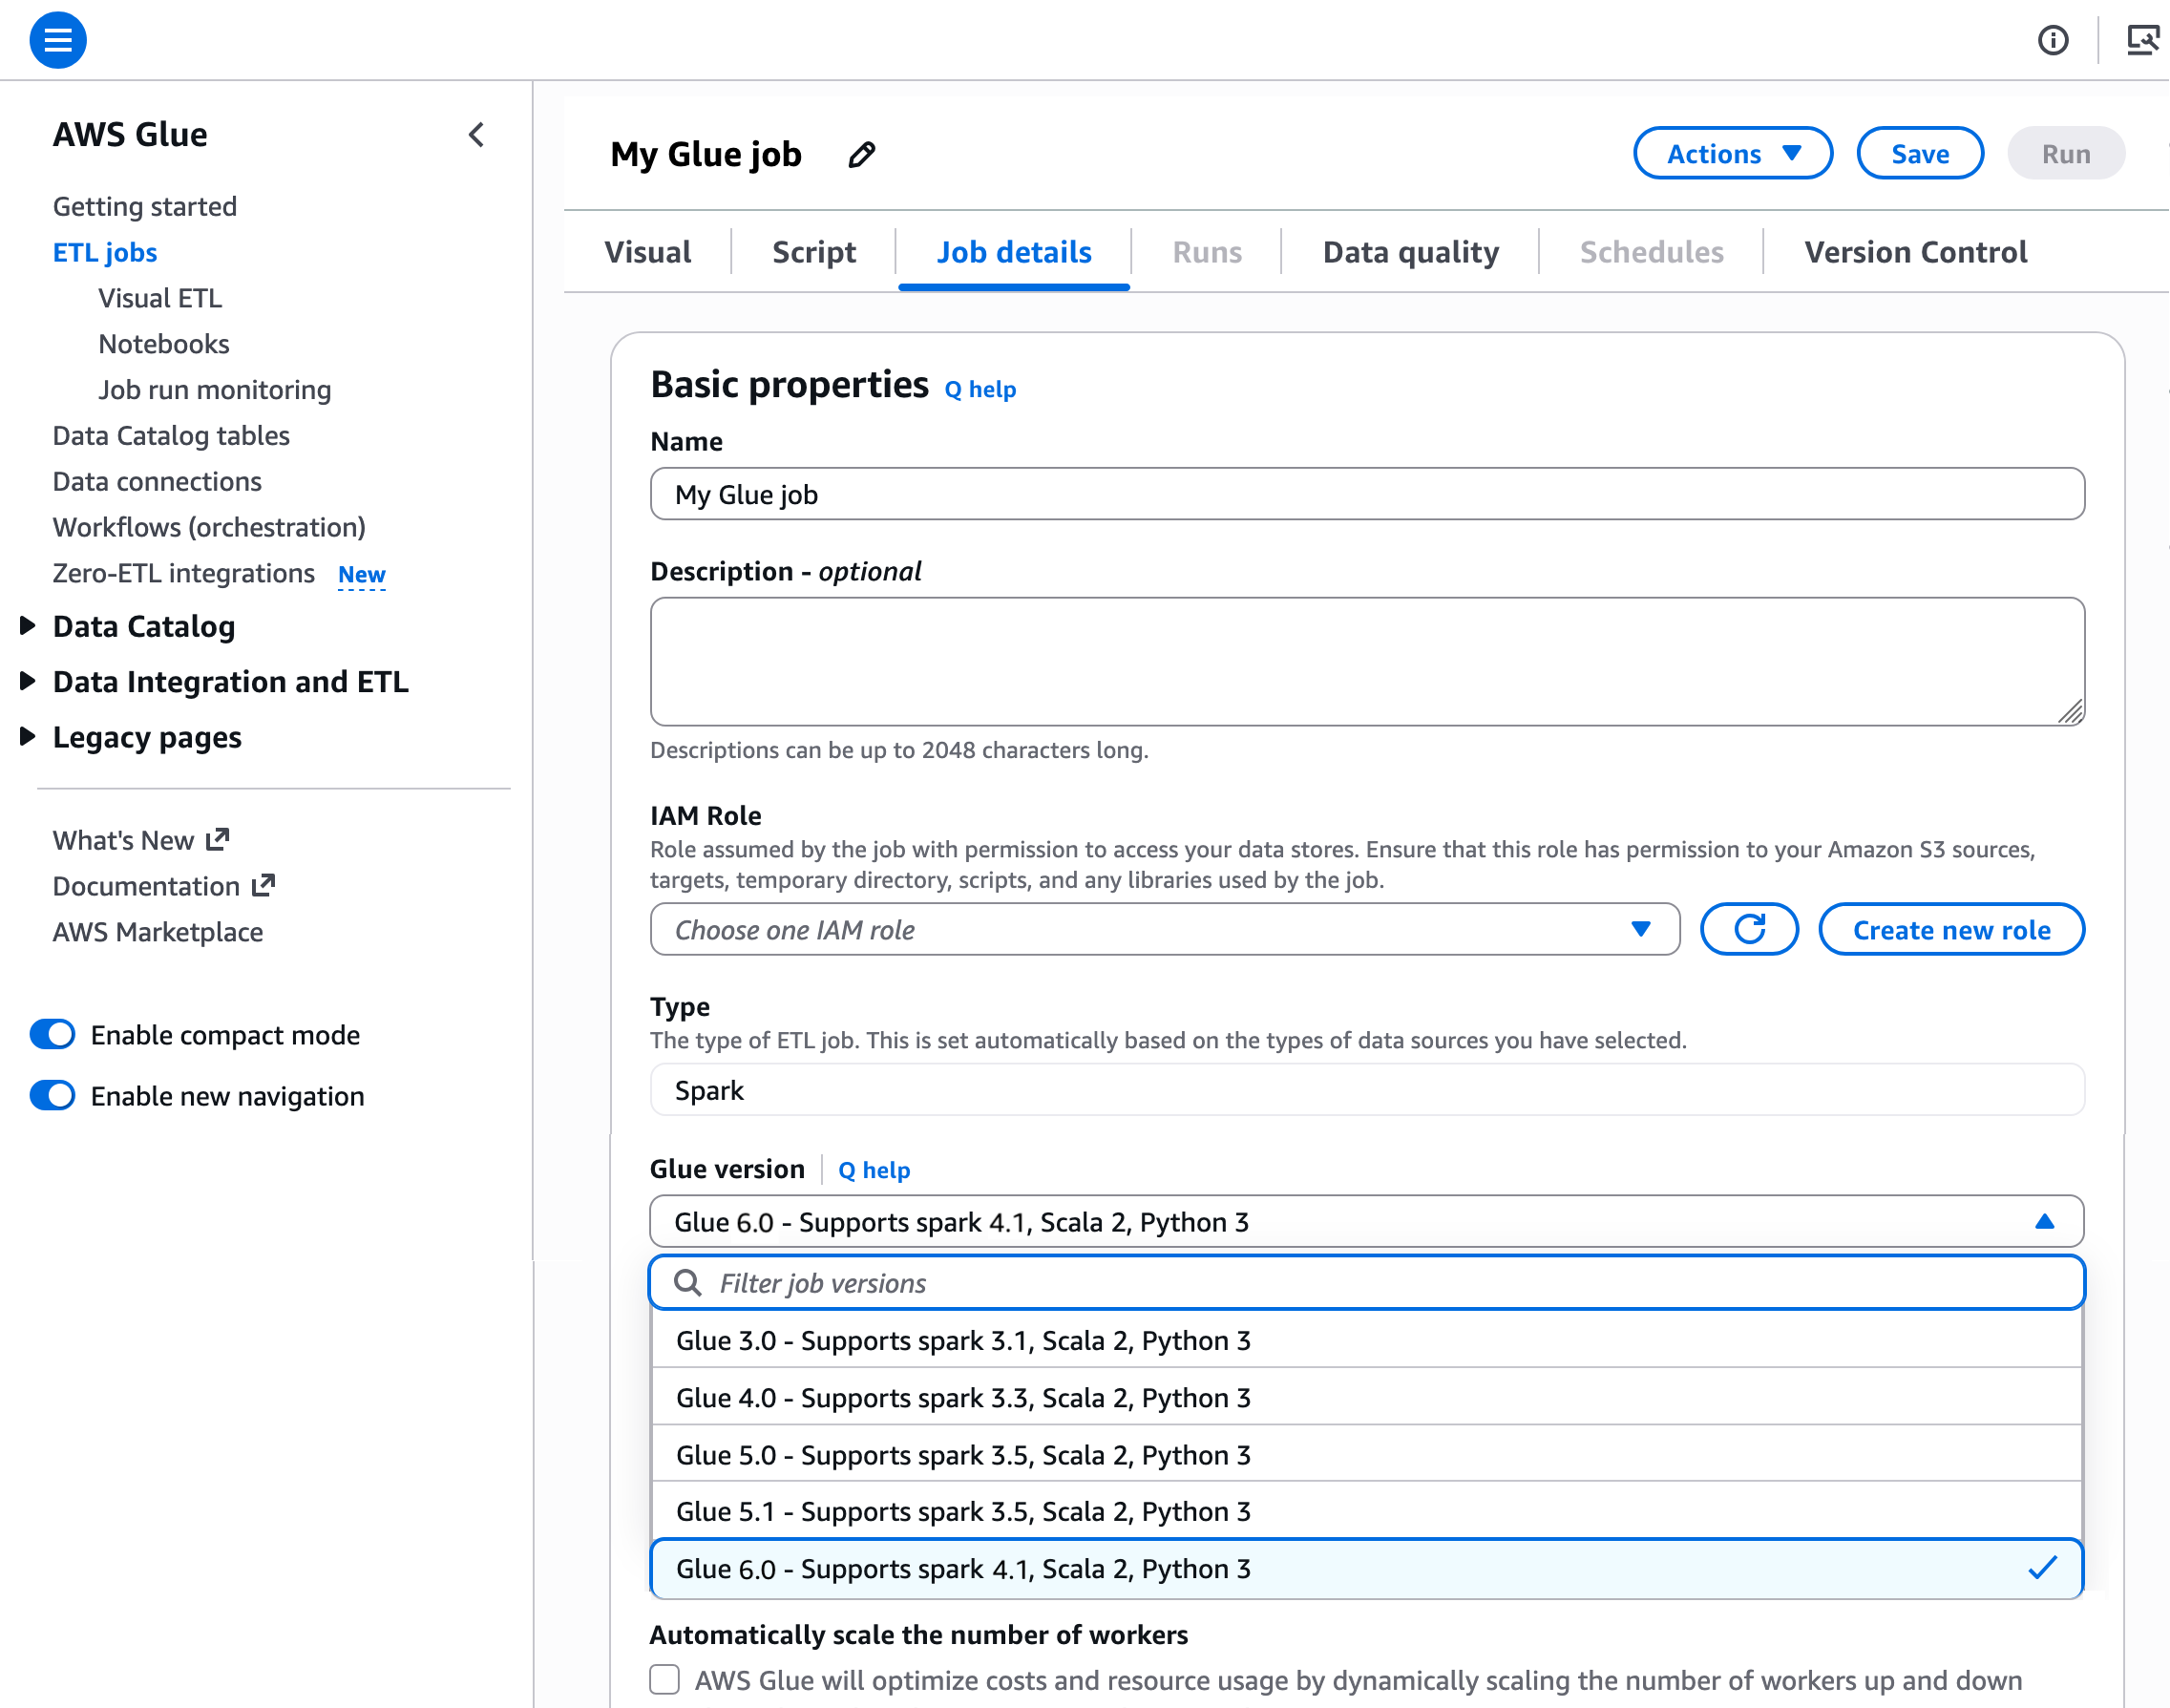
AWS Glue 6.0发布,价格降低30%,全面支持Apache Iceberg v3,基于Spark 4.1、Python 3.12构建。新增VARIANT数据类型、几何地理类型、纳秒时间戳等功能,提升半结构化数据处理和PySpark性能,支持毫秒级实时流处理。用户可通过现有API或控制台直接使用,无需更改代码。
Parquet是一种高效的列式二进制数据格式,比CSV更可靠,支持压缩和快速查询,被Spark、DuckDB等主流工具广泛支持。Apache Iceberg作为表格式管理Parquet文件集合,提供事务、模式演进和时间旅行功能。两者结合,可在低成本存储上实现数据仓库行为,适合数据超出单一系统时使用。
Snowflake将CDC直接嵌入Postgres内核,通过推式架构和事务边界,将数据复制变为自动、稳定的机制。它利用扩展监控WAL日志,将变更打包为Parquet文件存入Iceberg,确保事务一致性和“恰好一次”处理,并通过实时视图解耦复制与查询延迟,简化运维,使复制可靠且无需人工干预。
Apache Iceberg是ASF下的开源表格式项目,Google的三位工程师分享了他们的贡献。Talat Uyarer强调V4规范改进元数据、支持流式写入和细粒度访问控制;Ahmed Abualsaud开发Beam的IcebergIO多语言连接器,提升SQL集成;Parth Desai关注开放湖仓架构,支持AI和跨引擎互操作。开源协作推动项目发展。
某零售品牌因Hudi版本老化和性能问题,迁移至Amazon S3 Tables。采用混合策略,DW层使用增量MERGE,DM层全量覆盖写Parquet。迁移后,核心作业性能提升8倍,ETL成本降低72%。通过新旧并行迁移,确保零停机和数据正确性。
本文探讨了SQL查询优化中的裁剪链路,分析了Trino、Spark和DuckDB在处理Iceberg表时的不同策略。通过四层漏斗模型,描述了SQL谓词到布局约束的转化过程,以及各引擎在规划和执行阶段的职责分工。实验结果表明,优化器能够有效减少扫描的数据量,提高查询效率。
本文探讨了Trino查询引擎的执行流程,包括分析、计划、分片和调度等阶段,重点介绍了Iceberg表的元数据处理及其对查询性能的影响。通过分析SqlQueryExecution的生命周期,阐明了SQL查询如何转化为分布式执行计划,并强调了EXPLAIN和EXPLAIN ANALYZE的使用,以优化查询效率。
本文比较了Trino与Spark SQL在数据处理中的差异,分析了两者的查询执行路径、优化机制及Iceberg连接器的能力。Trino采用解释型操作,而Spark通过全阶段代码生成和自适应查询执行来提升性能。文章还对比了两者在Iceberg下推能力,强调了各自的适用场景和优化风格。
本文讨论了Debezium在变更数据捕获(CDC)管道中的作用,特别是如何通过Kafka将数据库变更传输到Flink或Iceberg。重点在于理解变更事件的结构,包括操作类型(插入、更新、删除)及其对应的前后镜像。文章还探讨了快照与增量数据的处理,以及在数据湖中进行upsert时的主键和顺序要求,强调了Debezium与Flink、Iceberg之间的协作关系。
本文探讨了Flink与Iceberg在流式数据入湖中的配置与优化,分析了checkpoint间隔、提交频率与小文件数量的关系。通过调整checkpoint参数和并行度,优化提交过程,减少背压对数据可见性的影响。同时介绍了预聚合和bucket分区策略,以提高写入效率并降低小文件生成。最后提供了CDC入湖作业的检查清单,确保数据一致性与性能。
Iceberg通过四层不可变元数据树解决了对象存储中的目录管理问题。这四层分别存储表的状态、快照信息、manifest列表和数据文件,确保原子提交和快照隔离。查询时,Iceberg利用元数据快速定位数据文件,避免了传统方法中的高成本LIST操作,并支持高效的分区裁剪和文件裁剪,提升查询性能。
Iceberg通过隐藏分区和分区演进解决了Hive的分区问题。隐藏分区允许用户在数据列上写谓词,系统自动裁剪分区,避免全表扫描。分区演进则允许在不重写历史数据的情况下修改分区方案,保留旧数据的同时新增分区规范。这些设计提高了数据管理的灵活性和效率。
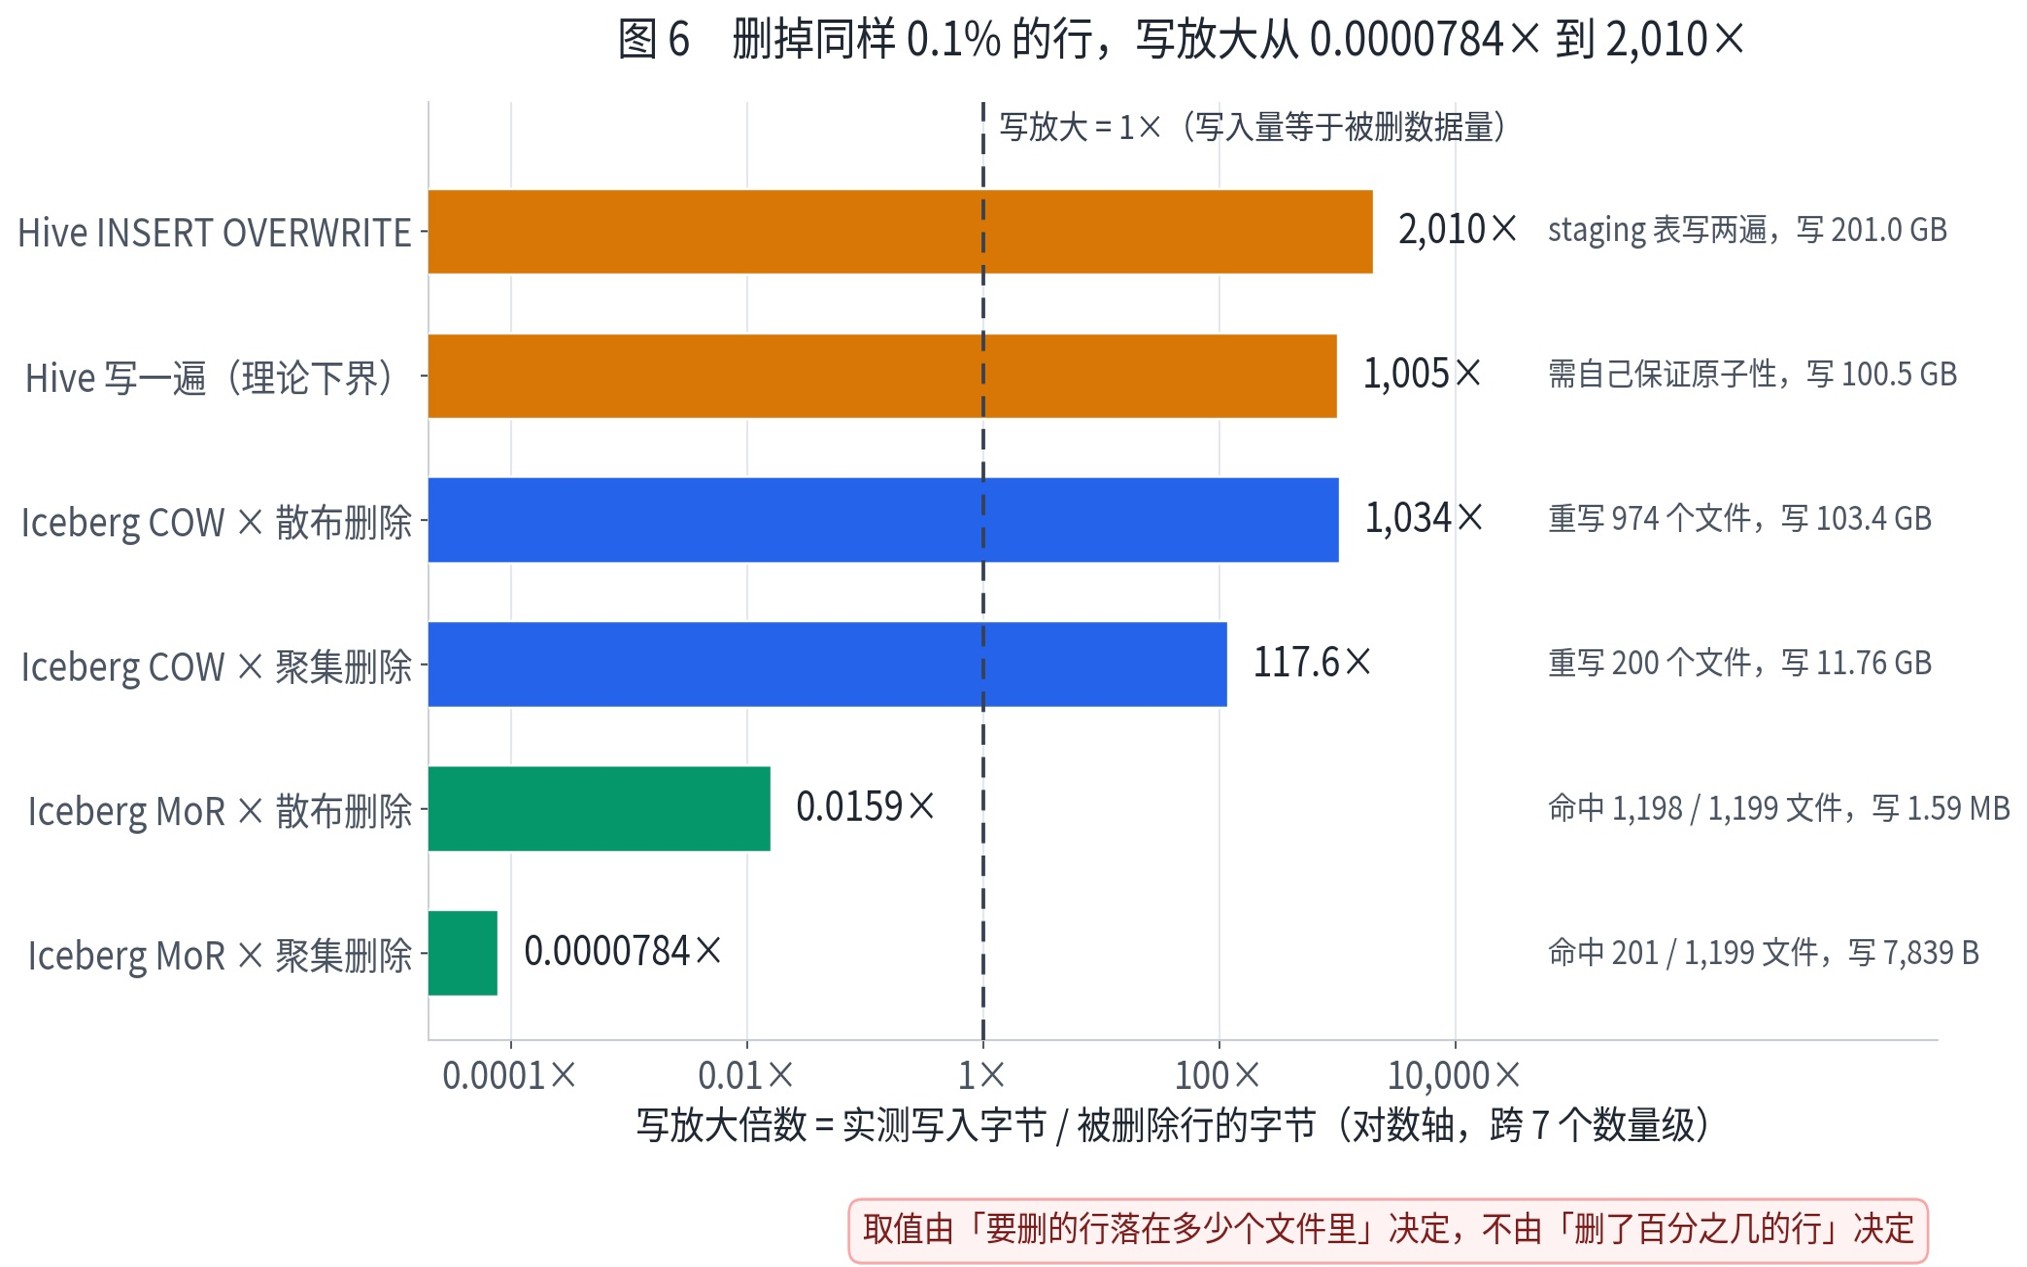
在Iceberg中,数据文件不可变,删除行可通过写时复制(CoW)和读时合并(MoR)两种方式实现。CoW重写整个文件,写放大高;MoR则写删除标记,适合高频删除。V3引入删除向量(DV),提高了删除效率。选择CoW或MoR取决于删除频率和读写性能需求。实验表明,CoW在删除时重写大量数据,而MoR需定期合并以避免性能下降。
完成下面两步后,将自动完成登录并继续当前操作。