


如何在 Databricks 上充分发挥 dbt 的运行效能
内容提要
本文介绍在Databricks上优化dbt管道的实践:采用增量策略、物化视图和预测优化降低计算成本;通过查询标签将费用归因到具体模型;利用流表、指标视图和Lakeflow Jobs统一数据摄取、指标定义与编排;使用声明式自动化包管理作业,并在dbt项目中定义治理策略,由Unity Catalog统一执行。
延伸解读
增量策略选择:避免默认 merge 的浪费
文章指出,全表重建是 dbt 项目最大的可避免成本。多数项目默认使用 merge,但若能用谓词描述变更数据,replace_where 比 merge 扫描目标表更省;若不能,incremental_predicates 可缩小 merge 扫描范围。选择取决于数据到达方式:仅追加用 append,需 upsert 用 merge,窄时间窗口重算用 replace_where,整分区覆盖用 insert_overwrite,按事件时间回填用 microbatch。
物化视图与预测优化:把维护交给平台
物化视图在 dbt-databricks 中是原生物化,只需一行配置,Databricks 自动追踪底层数据变化并仅刷新受影响结果,适合频繁变化源上的聚合服务层。文章引用 TPC-DI 基准,服务层从全量重算切换为物化视图获得 17 倍加速。预测优化自动执行 OPTIMIZE、VACUUM 和统计收集,启用后可退役 dbt 项目中的维护 post-hooks;Liquid Clustering 则替代分区设计,自适应查询模式。
查询标签:让费用可归因到具体模型
文章指出,财务问起仓库账单上涨时,多数环境无法回答,因为使用数据中的查询与发起它的 dbt 模型没有关联。查询标签自动为每个 dbt 查询打上模型名、dbt 版本和物化类型,还可添加自定义标签。标签出现在 system.query.history 中,与 system.billing.usage 关联后,可按模型、团队、域或物化类型归因无服务器仓库支出,看清哪些模型成本最高。
统一管道与治理:减少工具拼接和漂移
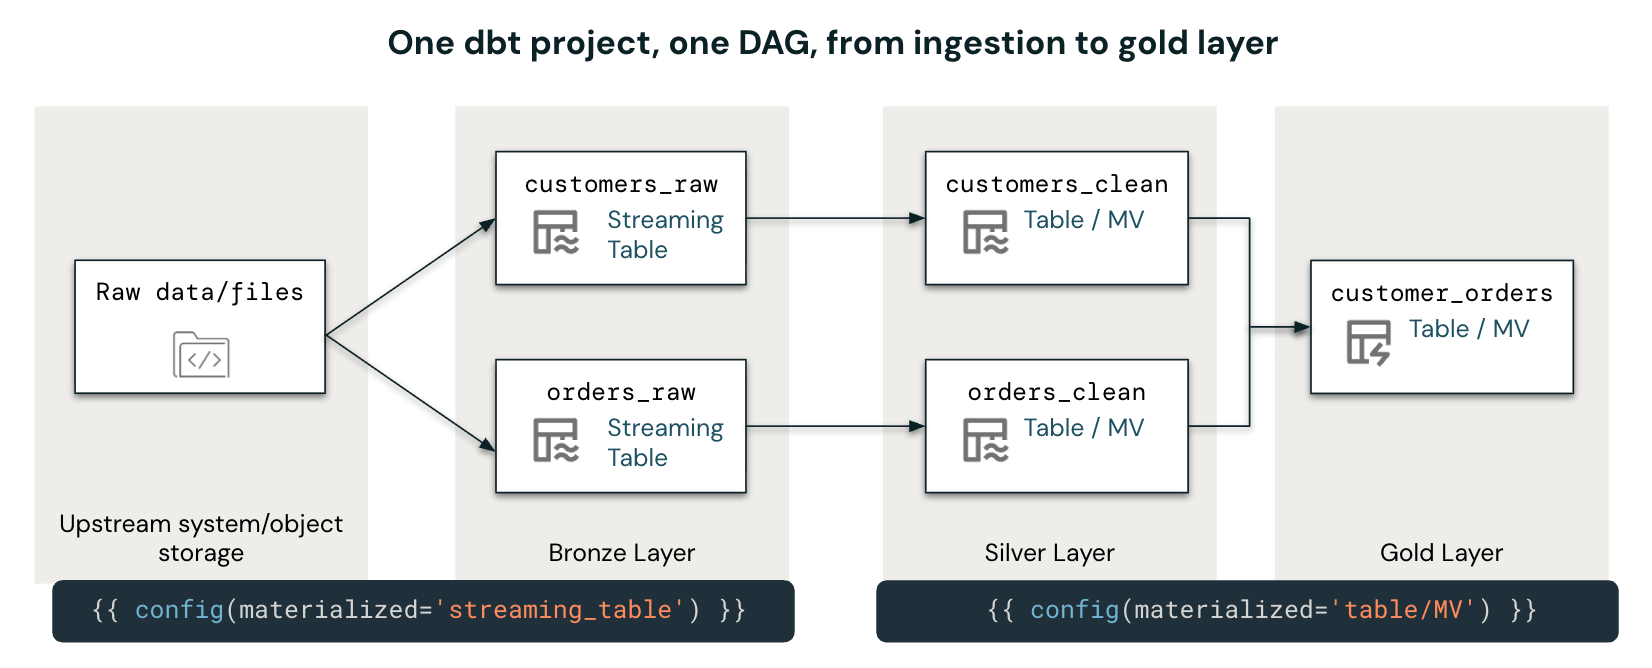
文章建议将摄取、指标定义、编排和治理收进一个 dbt 项目。streaming_table 物化让摄取成为 DAG 中的普通模型,血缘覆盖从原始文件到最终集市;metric view 将指标定义集中到受治理处,供 SQL、BI、笔记本和 Genie 共用;Lakeflow Jobs 以 dbt 为原生任务统一编排。治理在 dbt_project.yml 中定义,由 Unity Catalog 执行,ABAC 可基于标签自动应用行过滤和列掩码。
Q&A
在 Databricks 上运行 dbt 时,如何降低计算成本?
采用增量策略(如 append、merge、replace_where 等)避免全表重建;在服务层使用物化视图自动增量刷新;启用预测优化自动执行 OPTIMIZE、VACUUM 和统计收集;使用 Liquid Clustering 或自动聚类优化数据布局。
dbt 在 Databricks 上如何实现查询成本归因?
通过查询标签自动为每个查询打上模型名、dbt 版本和物化类型,并支持自定义标签。这些标签出现在 system.query.history 中,与 system.billing.usage 关联后,可按模型、团队、域或物化类型归因无服务器仓库支出。
如何将数据摄取统一到 dbt 项目中?
使用 streaming_table 物化类型,将 dbt 模型物化为流表,增量摄取新文件或事件。这样摄取成为 DAG 中的普通模型,下游 silver 和 gold 模型可通过 ref() 引用,测试、文档和血缘覆盖从原始文件到最终数据集的全路径。
dbt 中如何统一定义和管理指标?
使用指标视图(metric view)作为原生物化类型,在 dbt 项目中声明度量与维度,所有消费者查询同一逻辑。用户可通过 MEASURE() 函数在查询时选择分组,同一指标定义可服务于 SQL 编辑器、BI 仪表板、笔记本和 Genie。
如何用 Lakeflow Jobs 编排 dbt 管道?
Lakeflow Jobs 将 dbt 作为原生任务,把摄取、dbt 运行和下游任务整合到一个 DAG 中,由平台管理依赖。内置调度、自动重试、运行历史和警报,无需额外基础设施。支持 dbt Core 和 dbt Platform。
如何在 dbt 项目中定义数据治理策略?
在 dbt_project.yml 的项目级配置中定义标签、授权、行过滤和列掩码,随代码一起版本化和审查,由 Unity Catalog 强制执行。对于大规模场景,可使用基于属性的访问控制(ABAC),在治理标签上定义一次策略即可应用于所有带该标签的表。
