本文对比Databricks湖仓与Oracle传统数据仓库:前者采用开放格式和客户自有存储,统一支持BI、ETL、流处理、机器学习与AI,治理与成本更优;后者在关键OLTP事务系统仍有优势。AXA日本迁移后仓库成本降60%、ETL成本降70%。建议分析型Oracle环境迁移至Databricks,事务核心可保留Oracle。
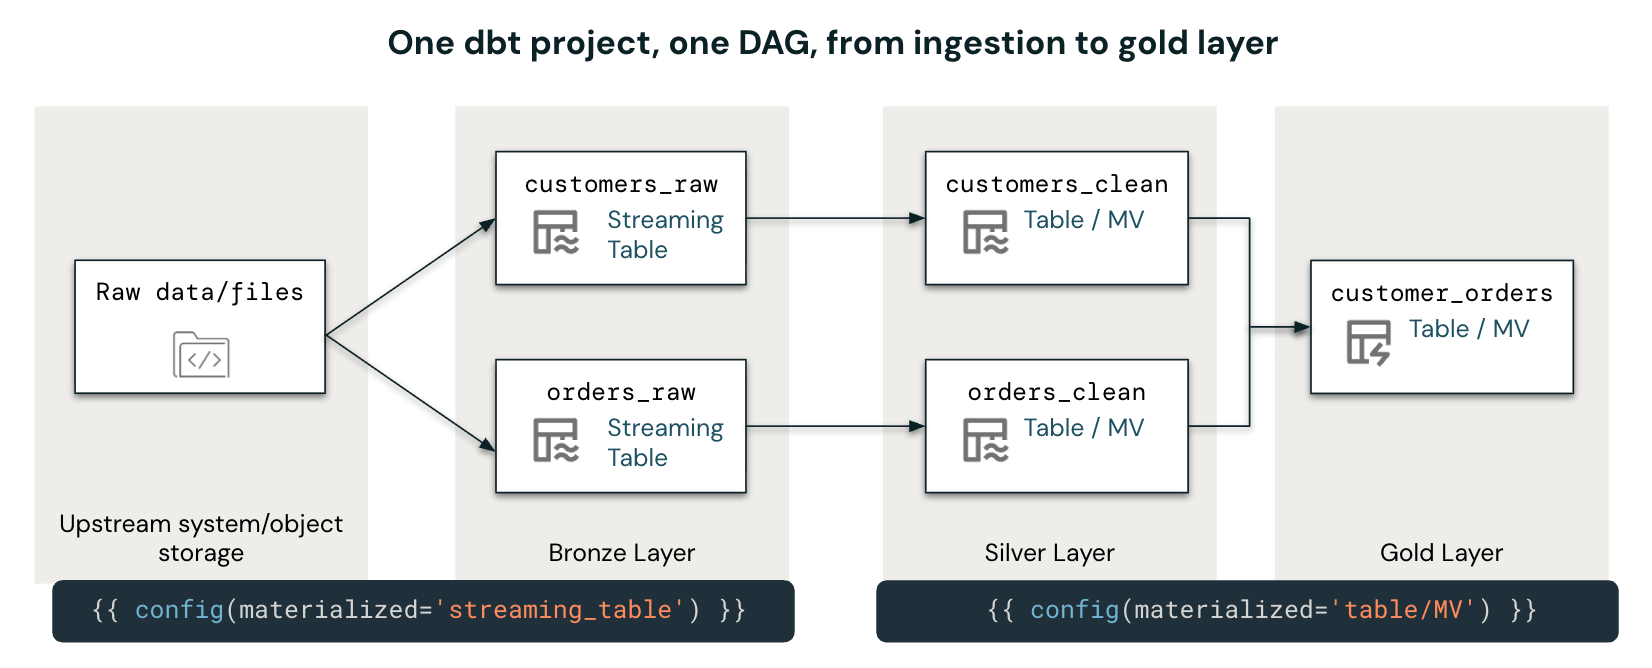
本文介绍在Databricks上优化dbt管道的实践:采用增量策略、物化视图和预测优化降低计算成本;通过查询标签将费用归因到具体模型;利用流表、指标视图和Lakeflow Jobs统一数据摄取、指标定义与编排;使用声明式自动化包管理作业,并在dbt项目中定义治理策略,由Unity Catalog统一执行。
Cloudflare优化其AI代码审查代理,将平均审查成本从2.43美元降至0.77美元(降68%),中位耗时从4分09秒缩短至1分32秒。约40%的节省来自代码优化,其余来自模型与推理强度调整。关键措施包括:各仓库共享缓存前缀、减少LLM调用、并行读取文件、跳过无新内容的复审。质量评估显示,高强度下代码质量审查仍能发现相当数量的真实问题,且误报和严重性虚高大幅减少。
作者复盘近三年Cloudflare账单:2024年3月至2025年8月连续18个月零费用;2025年末迁入核心业务并开通Workers Paid后开始计费,2026年9月单月达71.95美元。主要开销来自域名续费、Images图片转换、请求超量、Observability日志及缓存穿透。通过启用Worker Cache、优化图片尺寸、关闭非必要遥测、改用KV做ISR缓存等措施,可将费用压回5美元基线。结论是5美元只是入场券,架构治理才是控费关键。
Next.js 16.4 推出部分预取与缓存组件,Vercel 用新 Skill 优化 v0 导航:预取可复用内容,返回时不再显示骨架屏。通过 instant() 测试驱动重构,按需预取并控制成本,最终整体日成本降 2.9%,请求成本降 14.4%。
以色列初创公司Uvi获750万美元种子轮融资,旨在解决AI代理重复搜集上下文导致成本虚高的问题。其平台通过语义层、知识图谱和推理层,集中管理企业分散在Slack、Jira等系统中的决策记忆,使代理一次获取精准上下文。测试显示,答案成本从0.75至1.41美元降至0.10至0.16美元,最高节省46倍。
TeamCity推出Warm Agents插件,可预先启动并保持指定数量的空闲云代理,减少构建排队等待。插件支持所有云服务商,但每个热代理会占用许可证并产生云费用。用户可通过REST API设置目标数量,并利用定时触发器在夜间降低目标以节省成本。插件还提供利用率指标,便于监控需求变化。
openJiuwen推出开源智能路由,在Agent与模型之间增加决策层,按任务复杂度动态选择模型。其三层能力包括模型画像、多目标决策和反馈自演进。实测PinchBench得分接近全云基线,成本降低44.6%;Terminal-Bench成功率达Opus的95.2%,成本降低51.4%。
Cloudflare在AI Gateway推出Auto Router公开测试版,用户可将模型设为cloudflare/auto,系统自动按任务难度选择足够胜任的模型,无需手动挑选。内部测试显示,相比只用前沿模型,成本最多降低30%,性能接近Opus等顶级模型。其流程为先筛选可用模型,再用分类器判断任务类型与复杂度,结合价格和缓存成本评分,选出性价比最高者。
Cloudflare 为 AI Gateway 推出 User Insights 更新,可分析任务类型、对话轮次与成本,识别高能力模型被用于简单任务的情况,并关联具体用户、代理和应用。配套的 Auto Router 进入测试,能自动为任务选择合适模型以降低成本。分类异步进行,不增加请求延迟。
2025年底起,AI抢占高带宽内存产能,导致服务器内存价格2026年初翻倍,2027年前难以缓解。内存数据库成本骤增,但多数RAM存储的是冷数据。Redis Flex可将热数据保留在RAM、冷键值移至SSD,按10%–50%比例调节,SSD为主时每GB成本最多降低80%,无需修改代码,并支持Redis Search,适用于特征存储、缓存与AI代理。
Databricks 通过 Unity Gateway 和 CLI,让超万名员工在新模型(如 Opus 5.5、GPT-6 Sol)发布首日即可试用,并标记为实验性。三天内依据基准测试、用户反馈和成本追踪确认性价比,随后转为正式模型。Opus 5.5 每会话成本降低 29%,将设为 Claude Code 默认;GPT-6 Sol 成本降低 48%,将纳入智能路由。
Databricks借助Unity Gateway和CLI,让1.2万名员工在新模型发布首日即可试用。通过实验标签、预算控制和成本追踪,团队在三天内评估了Opus 5.5与GPT-6 Sol的效率前沿。结果显示,Opus 5.5质量更高、成本降低29%,将设为Claude Code默认模型;GPT-6 Sol成本降低48%,将纳入智能路由。
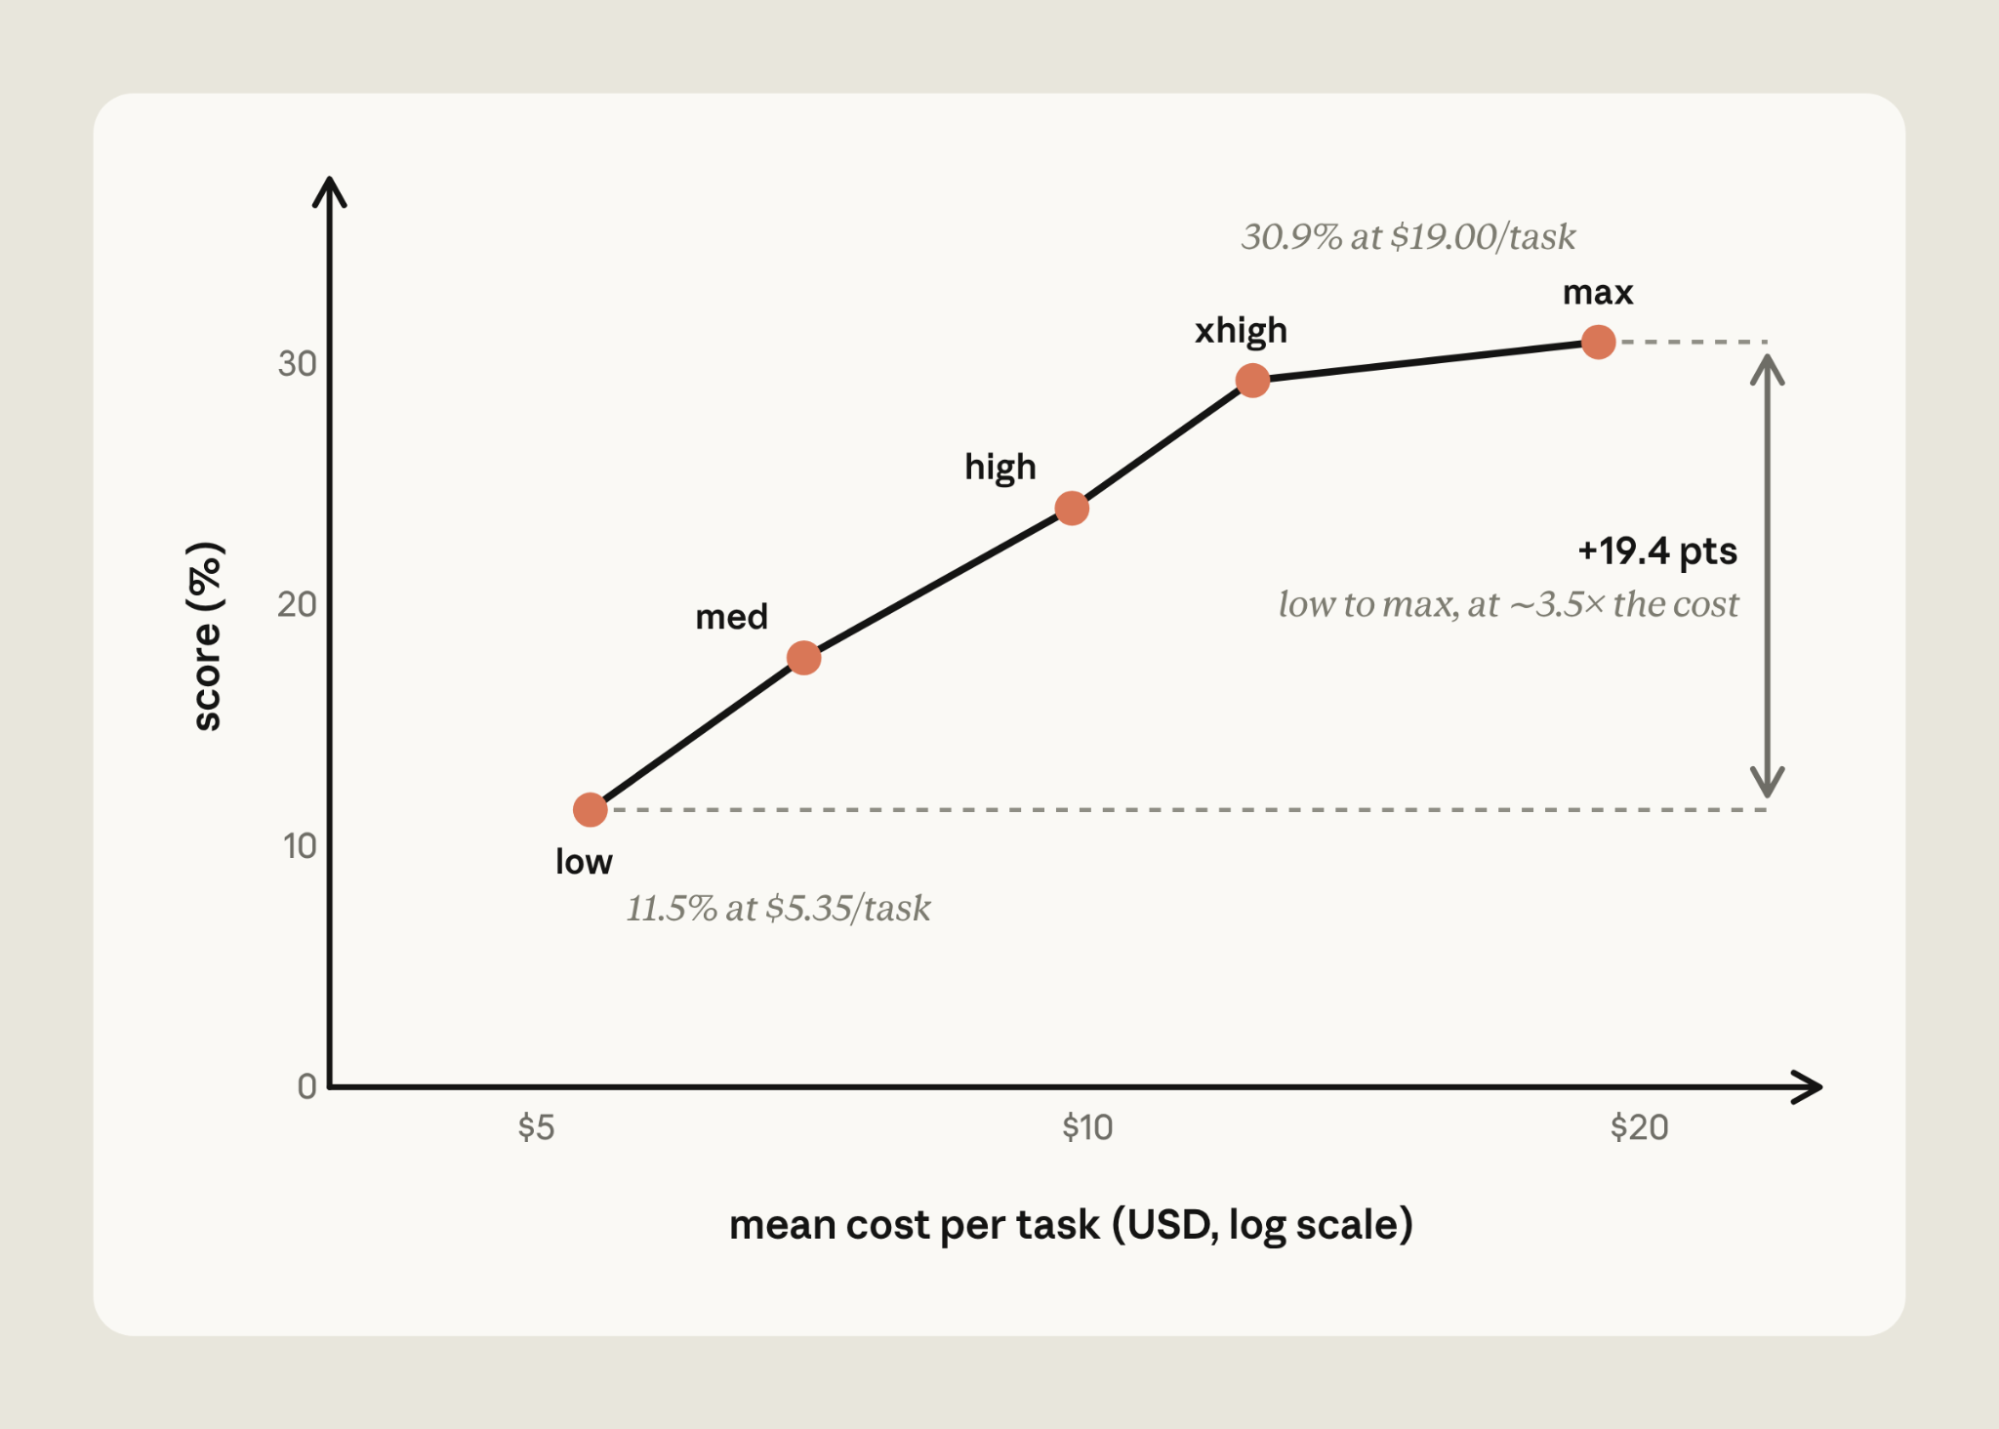
本文介绍如何在不牺牲性能的前提下降低Claude API使用成本。核心方法包括:最大化提示缓存命中率(通过稳定前缀、避免动态内容)、移除过时提示反模式(如验证仪式、过度强调)、校准任务努力程度。使用Claude Code的claude-api技能可自动审计和优化,实测可降低成本14.6%-73%,同时保持或提升准确率。
Jev 是专攻封闭选项判断的轻量决策模型,采用五要素决策模板和五步流水线,在分类匹配路由任务中大幅降低成本:两万条邮件分类仅需 1.45 美元,而 GPT-4o 需十几美元。其核心是让 Jev 只做选择题,输出 token 压缩至一两个,并明确代码、Jev、大模型、人工四角色边界。但 Jev 标签准确率仍在评估,生产环境长期数据尚缺。
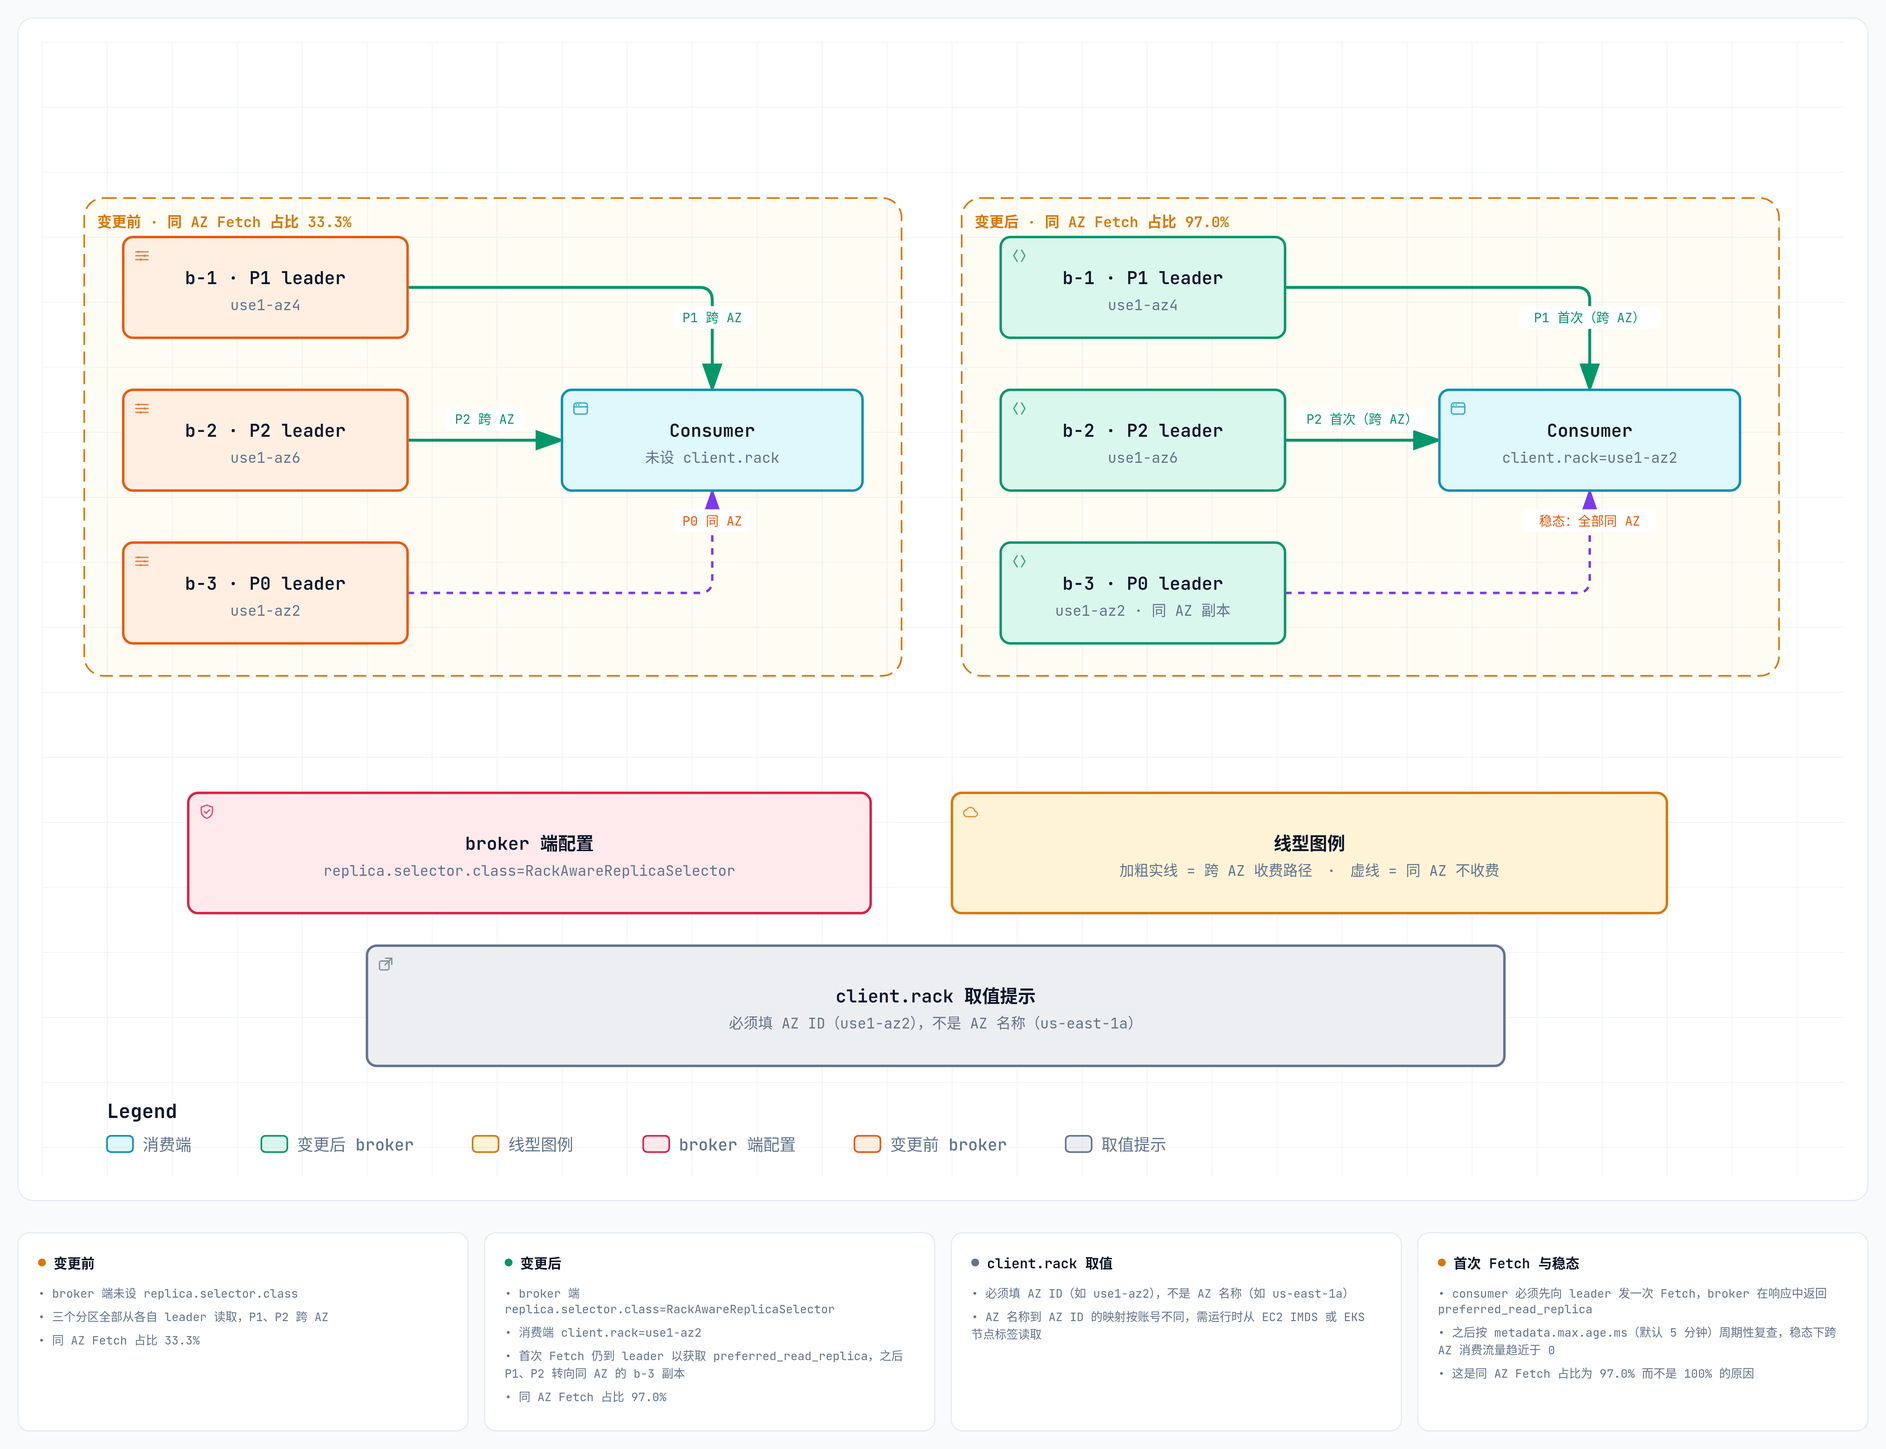
本文介绍 Amazon MSK 成本优化实践。MSK 费用包括 broker 实例、存储、跨 AZ 流量和监控。核心优化措施:启用 zstd 压缩并调整批处理参数以降低存储与流量费用;缩短数据保留期或启用分层存储;开启机架感知消费以消除跨 AZ 读取费;按需选择监控档位;合理选型 Standard 与 Express。综合优化后成本可降低约九成。
Anthropic发布Claude API成本优化指南,通过提示缓存、清理反模式指令和校准effort三步,可降低45%以上成本并提升性能。提示缓存可省90%费用,反模式指令会拖累新模型,effort需按任务调整。官方提供prompt-audit、cost-optimize和hillclimb三个自动化命令,实测成本降幅达52%-73%,准确率提升5.3%。优化需持续进行,随模型升级和对话变化调整。
RTC推流成本与性能平衡的关键在于分层供给,而非一刀切。费用主要由时长、增值服务和并发构成,高清档位和RTC链路是成本放大器。通过调整分辨率、帧率、大小流、动态码率和混流转推五个杠杆,可按内容定档、按需取流、分离互动与广播,实现省钱。但主播上行质量和可观测性不可省,以保障体验和止损。
NVIDIA NeMo Switchyard是一个开源路由层,位于AI代理和模型之间,按请求智能选择模型以降低成本。教程演示了从随机路由到内容感知路由的升级,包括配置YAML、启动服务器、测试简单与复杂请求,以及基于进度或升级的路由策略。最后强调通过指标测量路由效果,优化质量与成本平衡。
文章介绍如何通过Spotify的AiKA Modes优化AI编程成本。作者创建了bulk-reader和code-writer两种模式,将文件读取和代码生成等重复性任务委托给便宜的Gemini 2.5 Flash模型,而将复杂推理留给Claude。通过Claude Code插件shunt自动路由,测试显示可节省约90%的token消耗,同时保持代码质量。
完成下面两步后,将自动完成登录并继续当前操作。