


用于大规模分布式AI训练的RoCE网络
内容提要
Meta在ACM SIGCOMM 2024会议上分享了他们在大规模分布式AI训练工作负载中使用的网络细节,包括采用RDMA over Ethernet技术构建数据中心网络、设计路径固定方案以提高网络流量均衡和路由效率、优化集体流量模式以改善网络拥塞控制。这些设计对分布式AI训练基础设施的发展至关重要。
延伸解读
前后端网络分离的设计考量
Meta将训练集群的网络分为前端和后端:前端负责数据摄取、检查点和日志等任务,后端专用于训练通信。这种分离允许后端网络独立演进和扩展,以支持大规模GPU集群的非阻塞通信。前端网络则确保足够的入口带宽,避免阻碍训练工作负载。这种设计提高了网络的可靠性和性能,同时降低了运维复杂度。
路径固定方案的局限与改进
Meta最初采用路径固定方案,根据目的地的“切片”索引将数据包路由到特定路径。然而,当机架未完全分配给同一任务或发生网络故障时,会导致流量分布不均和拥塞,训练性能下降超过30%。为此,Meta将机架上行带宽升级为下行带宽的2倍,但这增加了成本。随后,Meta通过增强ECMP和队列对扩展,提高了流量熵,使AllReduce集合通信性能提升高达40%。
拥塞控制:从DCQCN到PFC的转变
在400G部署中,Meta发现DCQCN的默认设置和固件实现问题导致性能下降,因此决定不使用DCQCN,仅依赖PFC进行流控。经过一年多的运行,训练集合通信表现稳定,未出现持续拥塞。Meta还通过接收驱动的流量接纳机制,限制网络中的在途流量,优化性能。但这一方案需要精细调整参数,并依赖集合通信库与网络的协同设计。
对AI训练网络设计的启示
Meta的经验表明,AI训练流量具有低熵、突发性和大象流特征,传统数据中心网络方案可能不适用。通过分离前后端网络、优化路由和拥塞控制,Meta构建了支持数万GPU的RoCE网络。然而,其方案依赖特定工作负载和协同设计,可能不具普适性。随着GenAI工作负载增长,网络基础设施需持续演进,业界应关注AI训练流量的独特需求。
Q&A
Meta在大规模分布式AI训练中使用了什么网络技术?
Meta在大规模分布式AI训练中采用了RDMA over Ethernet(RoCEv2)技术。
Meta如何优化其AI训练网络的流量均衡?
Meta通过设计路径固定方案和增强的ECMP来优化网络流量均衡。
Meta的AI网络是如何支持大规模GPU互联的?
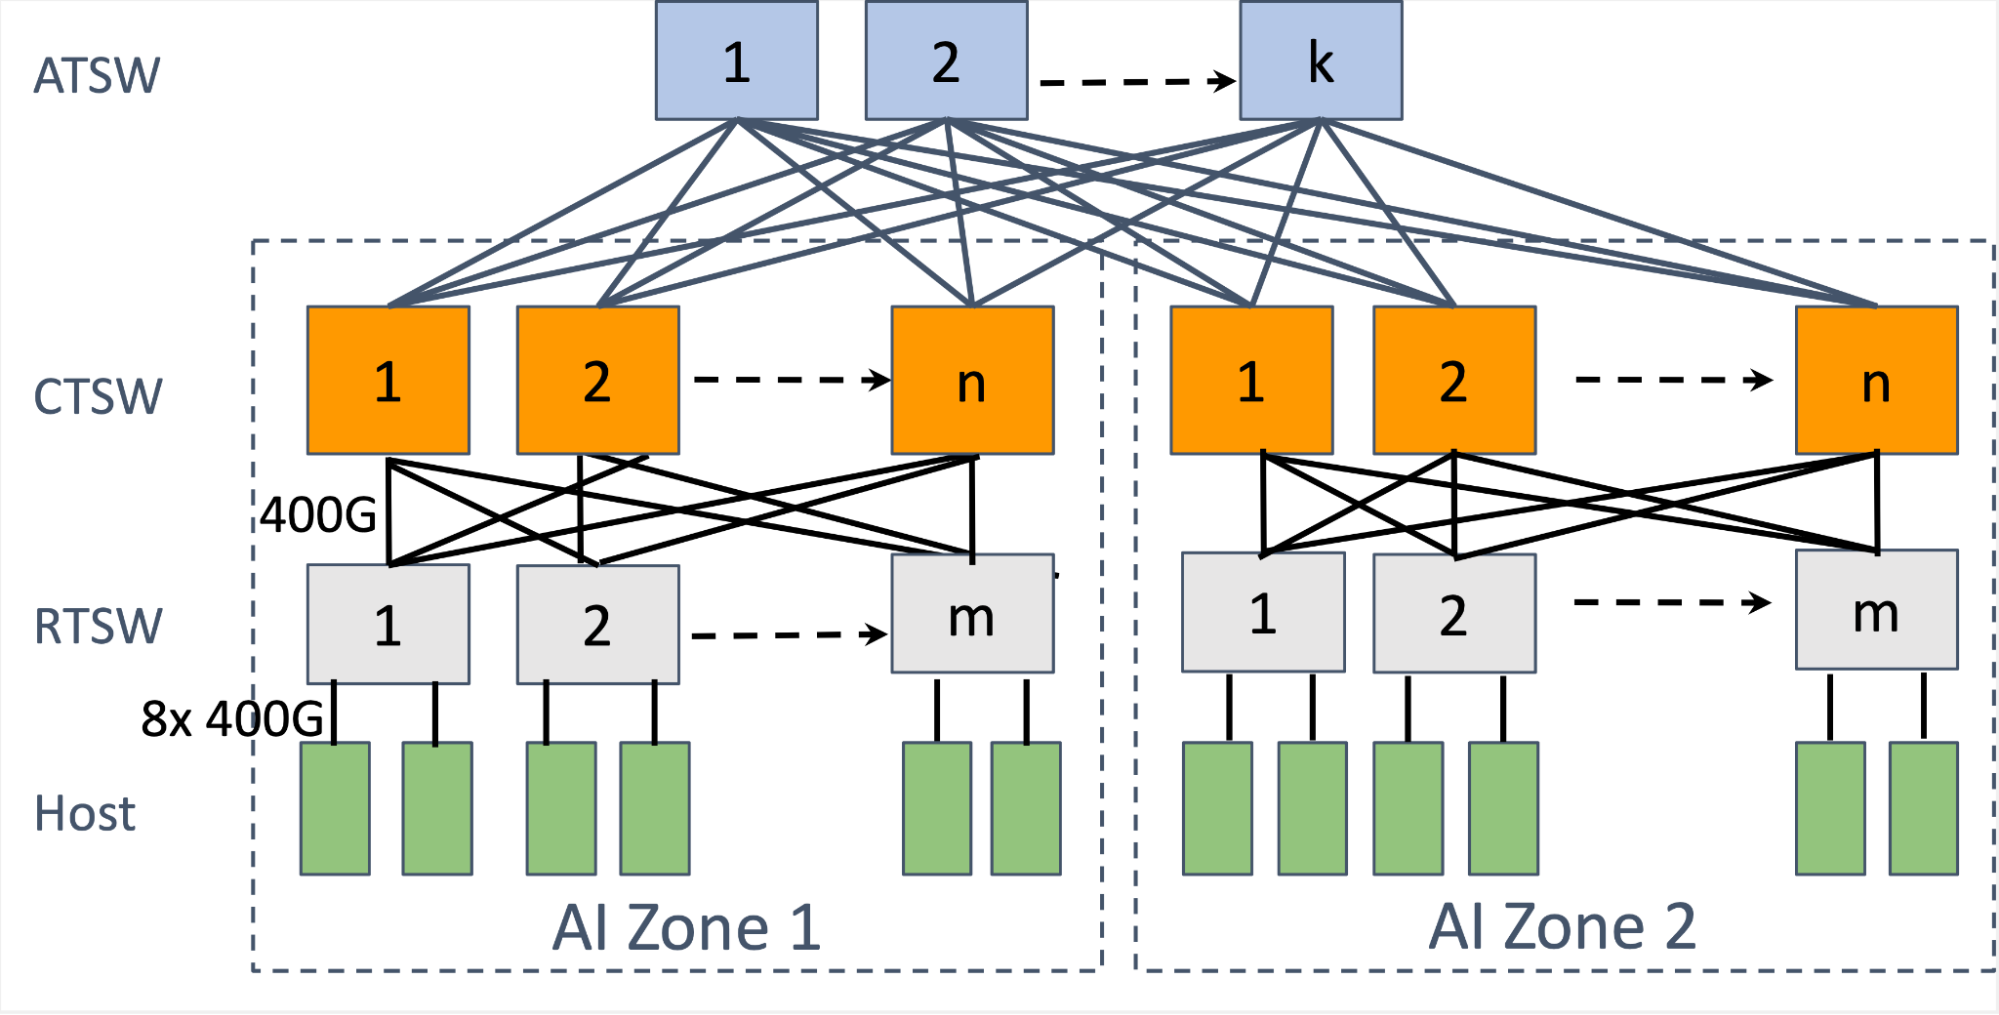
Meta的AI网络采用两级Clos拓扑结构,支持大规模GPU互联,确保高带宽和低延迟。
在400G部署中,Meta选择了什么样的流量控制方案?
在400G部署中,Meta未使用DCQCN,而是依赖PFC进行流量控制。
Meta是如何解决训练流量的低熵和突发性问题的?
Meta通过设计路径固定方案和优化训练作业调度器来解决训练流量的低熵和突发性问题。
Meta的网络基础设施将如何应对GenAI工作负载的增长?
Meta的网络基础设施将随着GenAI工作负载的快速增长而迅速演变,以满足日益增长的计算需求。
